
Veröffentlicht 23. Sept. 20269 Min. Lesezeit
Das AI Connect SDK: Gebt euren KI-Agenten die Connectoren jedes Nutzers als Werkzeuge, eine Zeile pro Framework
Die Integrationsabgabe von KI-Produkten ist die Verdrahtung, nicht das Modell. Das Vinkius AI Connect SDK entfernt sie: ein TypeScript-Client ohne Abhängigkeiten, user-scope-begrenzte Handles und neun Framework-Adapter. So funktioniert es, der minimale Code und ein lauffähiger Multi-User-Assistent, bereit zum Ausliefern.

Von Renato Marinho
Founder · Vinkius
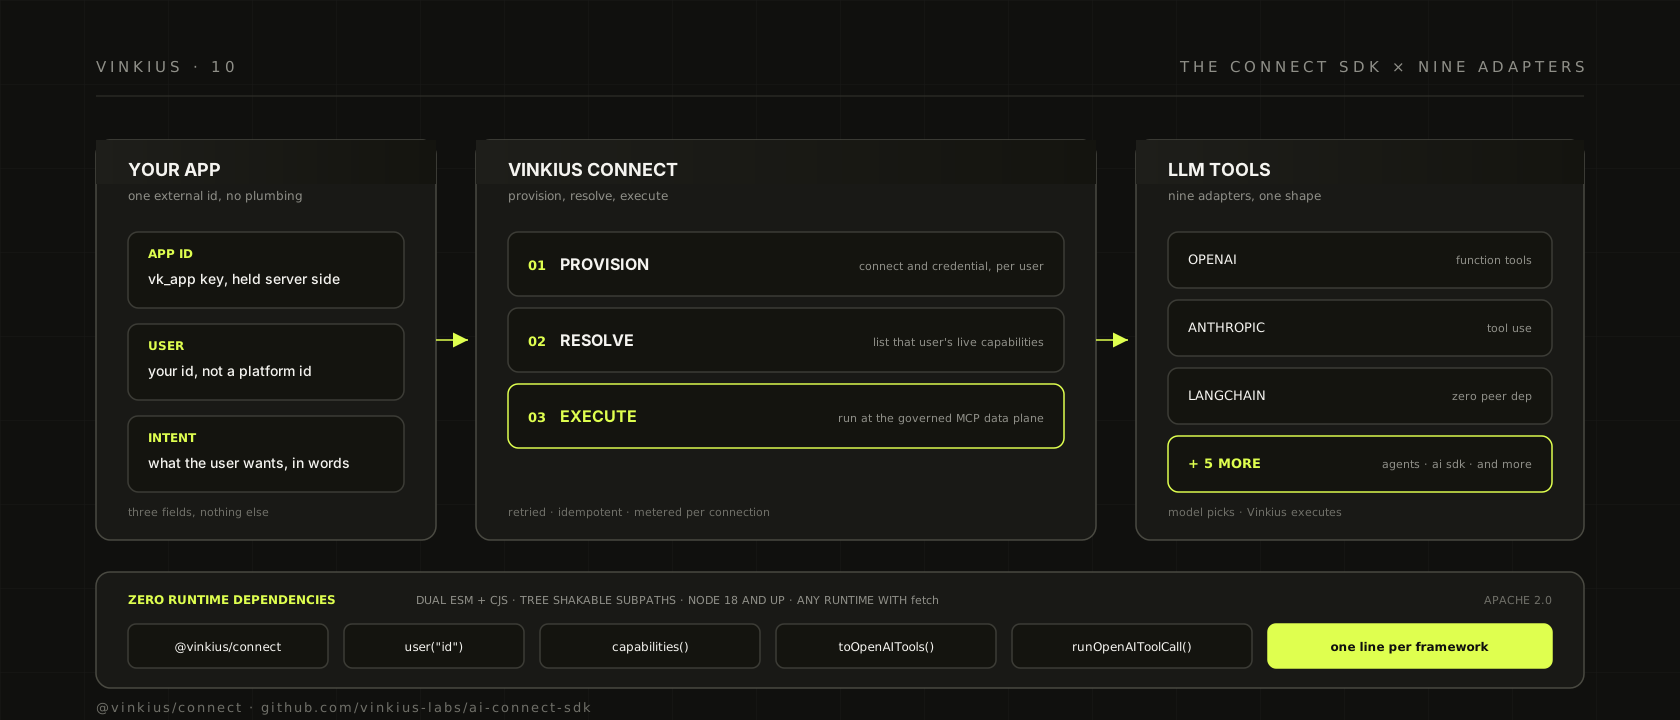
Die Frage, die ich am häufigsten über ein KI-Produkt bekomme, betrifft nicht das Modell. Sie betrifft die Verdrahtung. Wie liest euer Assistent das eigene GitHub des Nutzers? Postet er in dessen Slack? Zieht er einen Datensatz aus dessen CRM? Bei den meisten Produkten lautet die Antwort: Ein Team verbrachte Monate damit, ein Regal an Integrationen zu bauen und zu warten: die OAuth-Handshakes, die Token-Rotation, die Fehlerformen je Anbieter, die Retries, die stille Schema-Drift in dem Augenblick, in dem eine Upstream-API sich ändert. Keines davon macht das Produkt intelligenter. Es sitzt zwischen dem Modell und dem, was der Nutzer eigentlich wollte, und es fordert weiter Budget an.
Diese Abgabe ist es, was das Vinkius AI Connect SDK entfernt. Es ist der Teil von Vinkius, über den ich in Verkaufsgesprächen am wenigsten und mit Ingenieuren am meisten spreche, denn dort lebt der echte Hebel: ein kleiner TypeScript-Client, der die verbundenen Dienste eines Nutzers in Werkzeuge verwandelt, die euer Modell aufrufen kann, ohne dass euer Team ein einziges Upstream-Zugangsdatum besitzt.
Das SDK in einer Zeile
@vinkius/connect ist ein TypeScript-Client ohne Laufzeitabhängigkeiten für die Vinkius-Connectivity-Plattform. Eure Anwendung wird durch ein Paar von Schlüsseln identifiziert, das ihr einmal im Vinkius-Dashboard erstellt: eine öffentliche App-ID und einen geheimen Application-Key. Dann adressiert ihr eure eigenen Endnutzer über die IDs, die ihr ihnen bereits in eurem System zuweist, und der SDK übergibt euch für jeden von ihnen einen scope-begrenzten Handle auf die Conectores, die sie verbunden haben. Vinkius provisioniert die Verbindung, hält die Zugangsdaten und führt die Funktionen hinter einer governed Daten-Ebene aus. Euer Code trägt keinen Upstream-API-Key, keinen OAuth-Flow, keine Retry-Schleife für eine API eines Dritten. Ihr beschreibt die Arbeit im eigenen Werkzeug-Dialekt eures Modells, und ein Adapter routet sie zu dem richtigen Conector für diesen Nutzer.
Dieser Satz ist die gesamte Wertschöpfung. Der Rest dieses Posts ist der Beweis.
Das Modell: eine App, viele Nutzer, je einer Scoped
Die Designentscheidung, die ich am heftigsten verteidigen würde: Die Einheit des Scope ist der Nutzer, nicht der Tenant. Ein Chat-Assistent, der auf den Kalender eines Menschen wirken kann, ist nur sicher, wenn der Kalender, den er berühren kann, derjenige ist, den diese Person verbunden hat und nichts anderes. Der SDK kodiert das direkt: vinkius.user("yourUserId") baut einen lazy Handle, der null Netzwerkaufrufe macht und niemals eine interne Nutzers-ID auflöst oder speichert. Er adressiert die Plattform über eure externe ID, bis hinunter zur Ausführung.
Jeder Conector eines Nutzers ist eine isolierte Verbindung mit ihrem eigenen Token. Das Auflisten und Ausführen von Funktionen geschieht auf der Laufzeit dieser Verbindung, so dass das verbundene GitHub eines Nutzers nie auf das eines anderen Nutzers zugreifen kann. Jede Verbindung wird gemessen und kann unabhängig ausgeschaltet werden, und ein widerrufenes Token schlägt fail-closed statt sich still neu zu prägen. Wenn ein Nutzer einen Dienst löst, verschwindet die Funktion aus dem Werkzeugset dieses Nutzers, in dem Moment, in dem die nächste Anfrage sie auflistet. Isolation ist kein Versprechen in der Doku. Sie ist die Form des Datenpfads.
Der Code in drei Zügen
So sieht der Verbindungs- und Zugangsdaten-Flow aus, direkt aus den eigenen Beispielen des SDK. Ihr verbindet den GitHub-Conector eines Nutzers, lest das erwartete Schema, schreibt das Token und prüft die Bereitschaft:
import { Vinkius } from '@vinkius/connect';

const vinkius = new Vinkius({
  appId: process.env.VINKIUS_APP_ID!,
  apiKey: process.env.VINKIUS_APP_KEY!,
});

async function connectGithub(userId: string, githubToken: string) {
  const github = vinkius.user(userId).connector('github');

  await github.connect();
  const schema = await github.credentials.schema();
  await github.credentials.set({ GITHUB_TOKEN: githubToken });

  const status = await github.status();
  console.log(`github status=${status} requires=${Object.keys(schema).join(',')}`);
}
status kommt als eines von vier Wörtern zurück: not_connected, needs_credentials, ready oder disabled. Zugangsdaten sind schreib-only. credentials.schema() und credentials.status() sagen, welche Schlüssel existieren und welche gesetzt sind, nie die Werte, und der einzige Weg, den ein Geheimnis nimmt, ist einmalig nach innen in den Vault.
Der zweite Zug ist die Aggregation. Ein Aufruf liefert die ausführbaren Funktionen über alle bereit Conectores des Nutzers, bereits namespaced, so dass zwei Conectores, die beide ein create-Tool mitbringen, nicht kollidieren:
const caps = await vinkius.user('alice_123').capabilities();
// caps is a CapabilitySet: an array of executable Capability objects
Der dritte Zug ist der Adapter. Dies ist die Zeile, die die Plattform bezahlt, denn sie ist dieselbe Codeform, egal welches Modell ihr fahrt:
import { toOpenAITools, runOpenAIToolCall } from '@vinkius/connect/openai';

const tools = toOpenAITools(caps);
// pass tools to your model, then dispatch each call back:
const result = await runOpenAIToolCall(caps, call, { idempotencyKey: `alice_123:${call.id}` });
Ihr tauscht das Modell, und ihr tauscht den import. Es gibt neun Subpath-Adapter für die großen Modell-Frameworks, von den OpenAI- und Anthropic-SDKs über LangChain, LlamaIndex, das Vercel AI SDK, OpenAI Agents und Cloudflare Workers AI, zusätzlich ein framework-neutrales JSON-Schema-Dispatcher für den Rest. Jeder ist ein struktureller Typ-Konverter ohne Abhängigkeiten. Er wandelt Vinkius-Funktionen in den Werkzeug-Dialekt eures Modells um und zurück, und importiert deliberate nicht das Vendor-SDK, so dass das Hinzufügen von Vinkius in euer Projekt nichts mitzieht, was ihr nicht ohnehin schon nutzt.
Ein lauffähiger Multi-User-Assistent
So würde ich die Implementierung ausliefern. Ein Chat-Handler, der für einen Nutzer antwortet, unter Verwendung der eigenen Conectores dieses Nutzers, mit der vollen Tool-Schleife: Das Modell fordert ein Tool an, wir führen es auf der governed Laufzeit aus, wir geben das Ergebnis zurück, und wir begrenzen die Schleife, damit ein fehlverhaltendes Modell euch nicht für immer abrechnet.
import OpenAI from 'openai';
import { Vinkius } from '@vinkius/connect';
import { toOpenAITools, runOpenAIToolCall } from '@vinkius/connect/openai';

const openai = new OpenAI();
const vinkius = new Vinkius({
  appId: process.env.VINKIUS_APP_ID!,
  apiKey: process.env.VINKIUS_APP_KEY!,
});

// Any model your chosen provider serves. The integration is model agnostic:
// nothing below depends on a specific model name.
const MODEL = process.env.OPENAI_MODEL ?? 'your-model-id';

export async function assistantFor(userId: string, question: string) {
  // 1. What can this user's connectors actually do, right now?
  const caps = await vinkius.user(userId).capabilities();
  if (caps.length === 0) {
    return 'You have not connected a service yet. Connect one in the app and I can act on it.';
  }

  // 2. Hand the model this user's capabilities as its own tools.
  const messages = [{ role: 'user', content: question }];
  const tools = toOpenAITools(caps);

  // 3. The tool loop. The model picks, we execute at the runtime, we feed the result back.
  let reply;
  for (let step = 0; step < 4; step++) {
    reply = await openai.chat.completions.create({
      model: MODEL,
      messages,
      tools,
    });

    const msg = reply.choices[0]?.message;
    if (!msg || !msg.tool_calls || msg.tool_calls.length === 0) break;

    messages.push(msg);
    for (const call of msg.tool_calls) {
      // Tool level failures come back as isError results, not throws.
      // Transport level failures throw the SDK's typed error classes.
      const result = await runOpenAIToolCall(caps, call, {
        idempotencyKey: `${userId}:${call.id}`,
      });
      const text = result.content.map((c) => c.text).join('\n');
      messages.push({
        role: 'tool',
        tool_call_id: call.id,
        content: result.isError ? `The tool reported an error: ${text}` : text,
      });
    }
  }

  return reply?.choices[0]?.message?.content ?? '';
}
Vier Dinge in diesem Block sind es wert, benannt zu werden, denn dort würde eine naive Version still falsch laufen.
Erstens: die Funktionsliste wird pro Anfrage, pro Nutzer und nur aus bereit Conectores geholt. Ein Nutzer, der einen neuen Dienst verbindet, bekommt ihn im nächsten Turn ohne Deploy, und ein Nutzer, der einen widerruft, verliert die entsprechenden Tools im selben Moment. Nichts wird so gecacht, dass es die Vertrauensbeziehung überlebt.
Zweitens: die idempotencyKey im Ausführen-Aufruf macht das Retry sicher. Der SDK retry-t transiente Antworten, aber ein POST, der einen Nebeneffekt prägt, wird nur retry-t, wenn ihr den Schlüssel erklärt. Dann wird ein Replay serverseitig dedupliziert statt verdoppelt. Der obige Schlüssel ist nach Nutzer und Tool-Aufruf-ID namespaced, so dass zwei Nutzer, die auf denselben Conector wirken, nie kollidieren.
Drittens: die Obergrenze der Schleife. Ein Agent, der ein Tool-Ergebnis liest, entscheidet, es reiche nicht, und ruft das nächste Tool auf, ist der Weg, auf dem das Produkt nützliche Arbeit tut. Es ist auch der Weg, auf dem ein verirrtes Modell sehr lange laufen kann. Die Begrenzung der Schritte begrenzt die Rechnung und die Wirkungshöhe, und die schlichte Textantwort des Modells im letzten Turn ist das, was ihr zurückgebt.
Viertens: die Fehler-Teilung. Eine Funktion, die auf der Tool-Ebene fehlschlägt (die umhüllte API gab einen Fehler zurück), kommt als Ergebnis mit isError: true zurück. Das Modell liest das und kann sich erholen, ein anderes Tool erneut versuchen oder dem Nutzer den Fehler erklären. Ein Transport- oder Authentifizierungsfehler wirft eine der typisierten Fehlerklassen des SDK. Zwei Fehlerformen, zwei Handler, und keiner nimmt die ganze Schleife mit.
Führt es auf einem anderen Framework aus, und nur die Adapterzeile ändert sich. Für Anthropic sind es toAnthropicTools und runAnthropicToolUse. Für LangChain injiziert ihr die tool-Fabrik des Frameworks, so dass der SDK keine Peer-Abhängigkeit mitbringt. Die Funktionsseite ist identisch.
Warum es so gebaut ist
Ich komme immer wieder zu einer Regel zurück, die ich vom Team fordere: der SDK darf eurer App nicht ein Geheimnis aufzwängen, das sie weder sehen noch widerrufen kann. Alles an der Form folgt daraus. Zugangsdaten sind schreib-only und im Ruhezustand verschlüsselt, und die Plattform lässt nicht einmal ihre eigenen Betreiber sie lesen. Verbindungstokens sind auf einen einzigen Conector scope-begrenzt, HMAC-authentisiert, und der Klartext wird nie gespeichert, so dass der Worst Case eines Lecks ein benanntes, widerrufbares, an einen Conector gebundenes Asset ist, kein stehender Pass zum gesamten Besitz. Retries sind begrenzt und gestreut, und ein Zeitlimit pro Anfrage hetzt das Auslesen des Körpers, so dass ein blockierter Stream keinen Worker aufhängen kann. Dasselbe Transportobjekt fährt sowohl die Steuerungs- als auch die Daten-Ebene, weshalb Retry-, Timeout- und Redaktions-Semantik niemals zwischen beiden driften können.
Der eine Ort, an dem ich die Sprache nicht abmindern werde: haltet die Application-Keys auf der Serverseite. Dies ist ein Backend-Client. Die öffentliche App-ID und der geheime Key gehören in eure Umgebung, nicht in ein Bundle, und das Design geht davon aus, dass der Nutzer-Scoped, den ihr übergibt, etwas ist, das euer Server als den Aufrufer nachweisen kann. Wenn ihr geneigt seid, es zum Browser zu bringen, um einen Round Trip zu sparen, habt ihr das Problem von Integrationsarbeit auf Geheimnisverwaltung verschoben, und das ist ein schlechteres Geschäft.
Was es ausliefert
npm install @vinkius/connect. Dual ESM und CJS mit vollständigen Typen, tree-shakeable, läuft auf Node 18 und höher und auf jeder Laufzeit, die fetch hat. Keine Laufzeitabhängigkeiten zum Auditen, kein Lockfile-Aufblähen, keine transitive Lieferkette, über die man mit dem Sicherheitsteam streitet. Die Lizenz ist Apache 2.0, so dass der Code euer ist, zum Halten und zum Ausführen überall, wo eure App läuft.
Die Funktions-Schicht, die es steuert, ist in dem Post über die Funktionsschicht und den Katalog abgedeckt, und die Ausführungsgarantien, auf die es sich stützt, sind in dem Post über das Ausführen untrusted MCP-Server in V8-Isolates. Dieser Post ist die Entwickler-Oberfläche beider: der Client, gegen den euer Team schreibt.
Liefert das Feature, nicht das Integrationsprojekt. Das ist der ganze Punkt, und deshalb hat der SDK genau einen Job: Gebt eurem Modell die Tools, die euer Nutzer verbunden hat, in dem Dialekt, den euer Modell schon spricht, und tretet zur Seite.