
Publicado 21 sept 202619 min de lectura
Cero cold starts para código no confiable: cómo Vinkius ejecuta los servidores MCP en isolates V8
Por qué los isolates V8 ganan a los contenedores para código edge multiinquilino: restauración de snapshot en ~15 ms, techo duro de 128 MB por inquilino, fetch con pinning contra SSRF y un modelo de integridad de snapshot en cuatro capas, donde una entrada corrupta es un cache miss, no un crash, dentro del runtime de Vinkius.

Por Renato Marinho
Founder · Vinkius
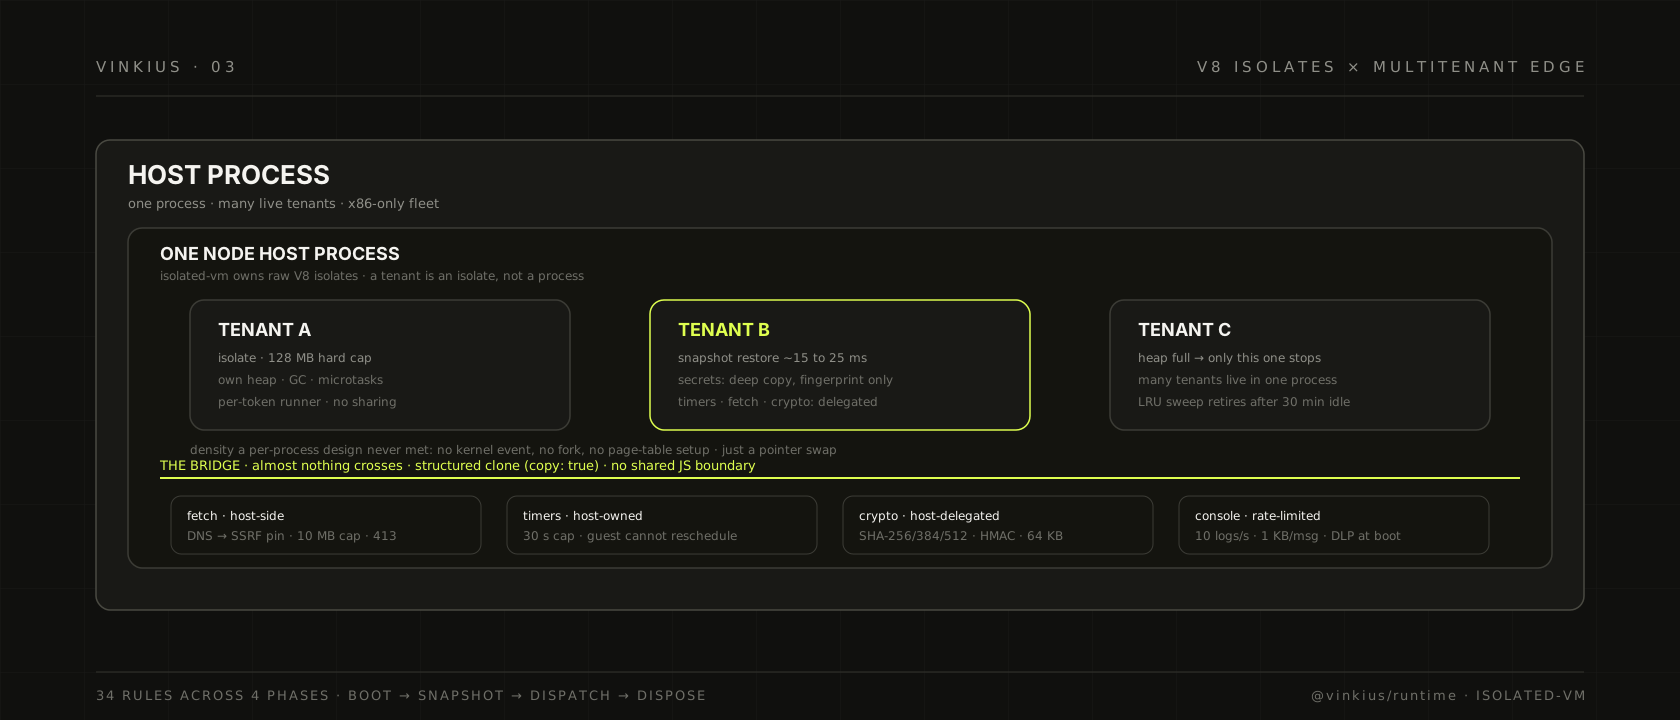
Cada servidor MCP que un cliente despliega en Vinkius Cloud es, tarde o temprano, código de terceros corriendo en nuestra infraestructura. No nuestro. No una librería que controlamos. De ellos. Una nube para agentes de IA solo es útil si los clientes pueden traer su propia lógica, sus propios conectores, su propio pegamento entre un LLM y sus sistemas. En cuanto esa capacidad existe, la pregunta que ninguna presentación de ventas responde se vuelve todo el problema de ingeniería: ¿cómo se ejecuta JavaScript no confiable de miles de tenants en un número reducido de servidores sin darle a ninguno un camino para dañar a los otros, a la máquina o a sus vecinos?
Esta es la pregunta detrás de la capa de isolates de V8 del runtime de Vinkius, y la parte de la arquitectura de la que menos hablo en público; por eso la pongo por escrito aquí. Lo que sigue es cómo funciona el sistema hoy. Los números son los que el código impone, no los que yo quisiera que fueran.
Por qué no un contenedor por servidor
La primera respuesta que cualquier plataforma multi-tenant busca es un contenedor por servidor. Es limpia, se entiende y da aislamiento real a nivel de kernel. Le dediqué un buen tiempo de diseño a exactamente eso.
Murió por densidad. Los clientes de Vinkius Cloud conectan servidores MCP como conectan integraciones en cualquier SaaS: decenas por workspace, baratos de crear, baratos de borrar, la mayoría en idle durante días. Un proceso de Node.js que arrancó un runtime real (framework, SDK, polyfills, pool de conexiones) arrastra un costo fijo de decenas de megabytes antes de hacer trabajo útil. Multiplicar eso por un par de cientos de servidores en una sola task obliga a pelear contra el techo de memoria de la task antes de que ocurra una sola llamada a tool. Y multiplicado por los cold starts, el resultado es una plataforma donde arrancar el propio servidor toma cientos de milisegundos.
La segunda respuesta obvia es muchos procesos en un solo contenedor, un fork por tenant. Es peor. Se intercambia el límite del kernel por nada: cada proceso sigue teniendo su heap, sus tablas de páginas, su recolector de basura, y un crash en un proceso puede tumbar a los hermanos a través de descriptores de archivos compartidos y del proceso init. Se gastó la misma memoria que la respuesta de contenedores y se obtuvo un modo de fallo peor.
También hice los números del término medio: un proceso de Node por workspace, compartido entre los servidores de un tenant. Choca con las mismas dos paredes. La huella fija de un runtime de Node arrancado es un costo por tenant, lo compartas o no, y una fuga de memoria o un fork bomb de un workspace tumba a todos los servidores de ese workspace. El blast radius no se localiza.
Lo que Cloudflare demostró con Workers es la tercera opción: no un proceso por tenant y no un contenedor por tenant, sino un isolate. V8 se construyó para ejecutar muchos programas no confiables dentro de un solo proceso de navegador, que es exactamente la forma de nuestro problema, porque una pestaña de navegador es un tenant. El runtime de Workers se apoya en el mismo primitivo: un isolate por request, restaurado desde un snapshot de V8, de modo que el cold start del que se queja la gente es en realidad solo una restauración de heap. No adopté su plataforma. No puedo: nuestro gateway es de larga vida y stateful de formas en que una función de página no lo es, y alojamos nuestra propia flota en AWS, donde controlo el ritmo de las actualizaciones. Adopté la idea y construí su lado host sobre Node.js con isolated-vm, el binding en C++ que deja a un proceso de Node poseer un isolate V8 crudo.
Esa decisión («un tenant es un isolate, no un proceso») es de donde sale todo el resto del runtime. Lo que sigue es una consecuencia de eso.
Lo que el isolate realmente ofrece
Un isolate es un heap: una región de memoria recolectada por basura con su propia cola de microtasks, sus propios globales y un tope duro que se fija al crearlo. El isolate que isolated-vm crea para un tenant recibe 128 MB. No es una cuota blanda que se impone en el código de aplicación y de la que se registra una advertencia; es un memoryLimit que se le pasa al motor. Cuando el heap de un tenant lo alcanza, el isolate de ese tenant deja de recibir servicio. Los otros tenants siguen corriendo. El globalThis de ningún tenant es alcanzable desde el isolate de otro, porque no hay ningún límite de JavaScript compartido en absoluto. El único tráfico que cruza el límite es lo que se puentea explícitamente, y se puentea casi nada.
El costo de scheduling importa más de lo que la gente piensa. Lanza un proceso y es un evento del kernel; forkear exige montar tablas de páginas, un exec y un calentamiento del recolector de basura. Cambiar de isolate dentro de un proceso es un intercambio de puntero. Por eso Cloudflare puede poner la palabra «zero» junto a los cold starts, y por eso el piso de latencia de nuestros servidores desplegados en edge se mide en milisegundos, no en el rango de 200 a 400 ms donde suele caer un arranque fresco de Node.
La capa de ciclo de vida enuncia la propiedad de aislamiento más de lo que yo podría: un runner por token de conexión y sin compartir entre tokens. El aislamiento de credenciales es absoluto. El runner que posee una conexión posee su isolate, su snapshot de secrets y sus timers, y nada en el grafo de procesos cruza hacia él.
El precio es que un isolate es un entorno vacío. V8 no trae una librería estándar. No hay fetch, no hay TextEncoder, no hay console, no hay setTimeout, no hay process, no hay Buffer. El primer trabajo real del runtime no es entonces ejecutar código de tenant. Es construir el entorno en el que el código de tenant corre.
El entorno vacío
Arrancar un isolate de tenant empieza con lo que llamamos la capa de soporte vital: un solo bundle concatenado de polyfills que restaura la superficie de la API de Web y Node que el código de tenant espera. El orden de carga es deliberado, porque cada capa depende de la de debajo. Primero van los shims de console y process, porque los polyfills de arriba registran e inspeccionan process. Luego TextEncoder y TextDecoder con soporte para UTF-8 y pares de sustitutos, porque un emoji en el argumento de una tool no es un caso límite. Luego URL y un URLSearchParams completo de 12 métodos (la entrada del changelog dice "axios, got y @octokit ahora funcionan correctamente en bundles de edge", y ese era el punto). Luego crypto, timers y el stack de red: Headers, fetch y un shim de XMLHttpRequest solo-async, para que las viejas librerías de HTTP que la gente pega en los conectores no mueran por xhr is not defined.
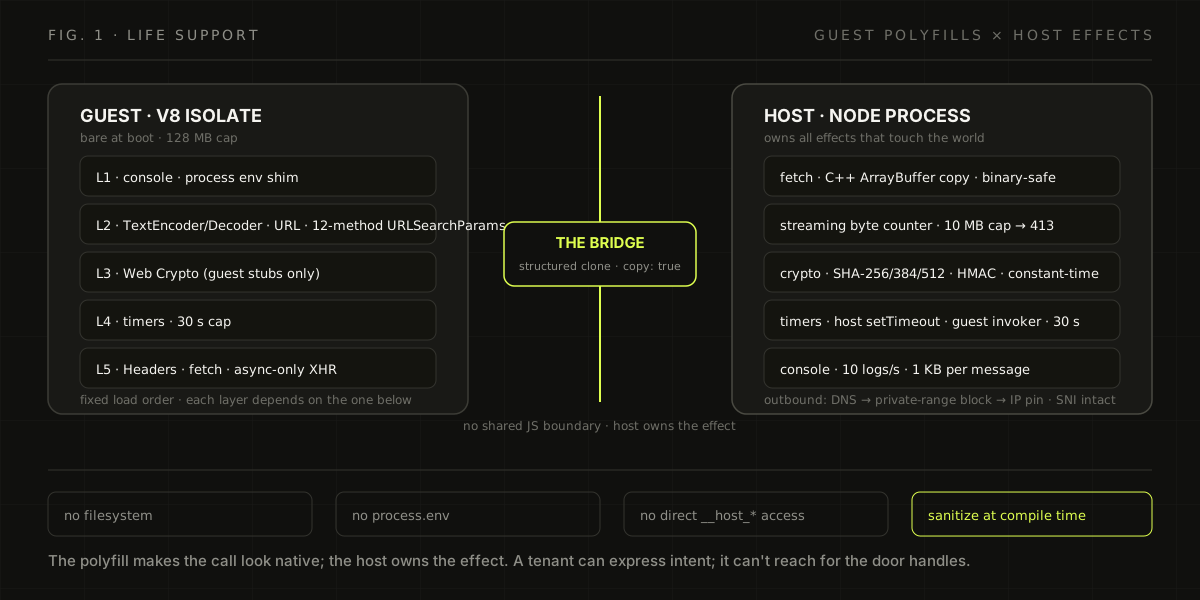
El punto es qué es real y qué se delega. Nada que toque el mundo exterior existe dentro del isolate. fetch en un bundle de tenant es un polyfill del lado guest, pero la request real ocurre del lado host, a través de __host_fetch, como copia de ArrayBuffer en C++ que cruza el límite: segura con binarios, de modo que una imagen o una respuesta gzip no se desfigura en un sin sentido UTF-8. crypto.getRandomValues es randomBytes del host, limitado a 64 KB. crypto.subtle.digest y HMAC, los que necesita la verificación de JWT, también son del host, y el host verifica las firmas con una comparación en tiempo constante. Los timers son llamadas setTimeout del host que llaman de vuelta al guest a través de un invoker registrado, limitadas a 30 s. La regla detrás de todo esto: el polyfill hace que la llamada se vea nativa, y el host posee el efecto. Un tenant puede expresar intención. No puede alcanzar el sistema operativo.
Argumentos y resultados cruzan el límite con clonado estructurado (copy: true en la API de isolated-vm) en vez de JSON.stringify. Se paga la serialización una vez, en C++, y se conservan ArrayBuffer reales y objetos tipados en ambos lados. No se nota esto hasta que se perfila una llamada a tool que mueve una payload de 1 MB: el round-trip de JSON era la segunda parte más cara después de la red.
Del lado de compilación, el código de tenant nunca llega al runtime como fuente. El pipeline de bundles toma la spec del servidor, genera el entrypoint y lo pasa por esbuild (IIFE, plataforma browser, target ES2022, minimizado), de modo que lo que cae en el isolate sea un solo archivo plano sin imports dinámicos. Un sanitizer de análisis estático rechaza las salidas de emergencia antes de aceptar el bundle: acceso directo a los puentes __host_*, colados de globalThis[...] con notación de corchetes, patrones de bypass de Function.constructor. Los bundles se comprimen con gzip y se firman con SHA-256. La API admite hasta 1,5 MB de bundle crudo, y el runtime impone un techo de descompresión de 2 MB con un contador de bytes en streaming que aborta antes de que una bomba GZIP llene el heap. Un detalle que sostengo: el bundle compilado corre una vez en un isolate desechable con todos los puentes stubbed, y esa corrida es la que extrae el manifest de la tool. El programa se paga en tiempo de compilación, no en tiempo de request.
Y aquí está la parte que los developers nunca ven. El bundle no sabe que está en la nube. La misma llamada startServer() que arranca un servidor por stdio en la laptop de un developer detecta el global __vinkius_edge_interceptor del runtime, le entrega sus definiciones de tool por ese interceptor y omite el montaje normal del transporte. Un codebase, dos runtimes: se desarrolla en local con el framework y se despliega a la nube sin una sola rama if (inCloud).
La versionización del protocolo viaja con el runtime, no con el bundle. El gateway habla la release stateless de MCP del 2026-07-28 como dialecto primario y negocia hacia abajo a través de la release de 2025 y del transporte SSE del 2024-11-05 como fallbacks, de modo que un client de un año sigue hablando con un servidor desplegado esta mañana. El dialecto en el que termina una sesión es un handshake, no una decisión de deploy.
Por qué el guest nunca toca la red
Lo más peligroso que un bundle de tenant puede hacer es lanzar una request HTTP. fetch es una fuente universal de SSRF: un bundle descuidado o malicioso que apunta una tool a http://169.254.169.254/, el servicio de metadatos de AWS, le entrega al agente de IA de un cliente un camino de lectura a las credenciales de la instancia. Todo el tráfico saliente pasa entonces por el guard de SSRF, y el guard trabaja bajo un solo principio: una dirección es válida solo mientras viva la política que la aprobó. Resuelve el DNS antes de la request y bloquea los rangos privados de plano (loopback, 10/8, 172.16/12, 192.168/16, link-local 169.254/16, que es el servicio de metadatos, 0/8, y los gemelos IPv6). Luego fija la IP aprobada en la conexión de undici, para que un ataque de rebinding no pueda cambiar la dirección después del vetting. Y mantiene SNI y TLS alineados con la dirección fijada, porque fijar a nivel de socket sin fijar el nombre tiraría CERT_ALTNAME_INVALID en cada request. La cache de DNS se limita a 4.096 entradas y no vive más que la conexión del pool a la que pertenece.
El ajuste de keep-alive de ese agent del pool es el fix más aburrido que he lanzado, y me alegra escribirlo. El idle timeout por defecto de undici es de 4 s, y cerraba sockets del pool en segundo plano entre turnos de conversación, de modo que casi cada llamada a tool real pagaba un handshake TLS frío. Lo corremos a 65 s, justo por encima de la ventana de idle de 60 s del ALB, y limitamos el pool a 100 sockets por target. El p50 de las llamadas salientes bajó por el costo de un handshake. Un fix aburrido con p50: eso es el sueño.
Las respuestas fluyen al isolate con un contador de bytes en marcha, con tope duro de 10 MB, y un AbortController cableado a través de todo el camino de dispose: cuando un isolate se jubila, sus requests en vuelo se abortan en la misma llamada. Cuando un dispatch se queda (el presupuesto de 30 s), el error no es un genérico «la request tardó demasiado». Un clasificador pregunta qué estaba haciendo el isolate en el momento del desborde: ¿I/O upstream en vuelo, el guest calculando, o presión de memoria? El tool_error que vuelve al agente trae la respuesta, más una pista de recuperación. El poseedor de un fallo (la API upstream del tenant, el código del tenant o la plataforma) no es algo que se deba descubrir haciendo grep en los logs a las 3 de la mañana.
La salida de ese clasificador alimenta un anillo de atribución upstream con 32 slots, el más reciente al frente. La imagen operativa entonces muestra no solo que los dispatch están fallando sino el upstream de quién. Cuando la API del CRM de un tenant se degrada a las 2 de la mañana, el runtime sabe que es el CRM del tenant y no la plataforma, y el anillo retiene la evidencia el tiempo suficiente para que el canal del incidente la lea.
Provisionar una vez: el principio del snapshot
Un arranque completo (compilar el bundle, correr la capa de polyfills, ejecutar el IIFE) cuesta de 50 a 100 ms en el primer contacto con un deploy. Sirve para la request 1. No sirve para la request 4.000, que es todas.
El principio es que un entorno y un programa son artefactos distintos, y solo uno de ellos cambia seguido. La capa de polyfills es estática para un deploy dado: misma versión de V8, misma superficie del host. Lo que cambia por request es el código del tenant. Así que se haga snapshot del entorno, no del programa. El host ejecuta el snapshot builder de isolated-vm sobre el entorno provisionado y cachea el blob de heap resultante en disco, indexado por deploy ID y estampado con la versión de V8 bajo la que se construyó. Al restaurar, se crea un isolate nuevo desde ese blob: uno o dos milisegundos para el motor, otro o dos más para cambiar los puentes stubbed por los reales, y el propio IIFE se re-ejecuta en el contexto restaurado. El total es de 15 a 25 ms, contra los 50 a 100 de un arranque completo, y el trabajo de polyfills ocurre exactamente una vez por deploy. El bundle se re-ejecuta en vez de snapshotearse porque Isolate.createSnapshot() es un método estático que no puede ejecutar código async, y nuestros IIFE pueden await a nivel superior.
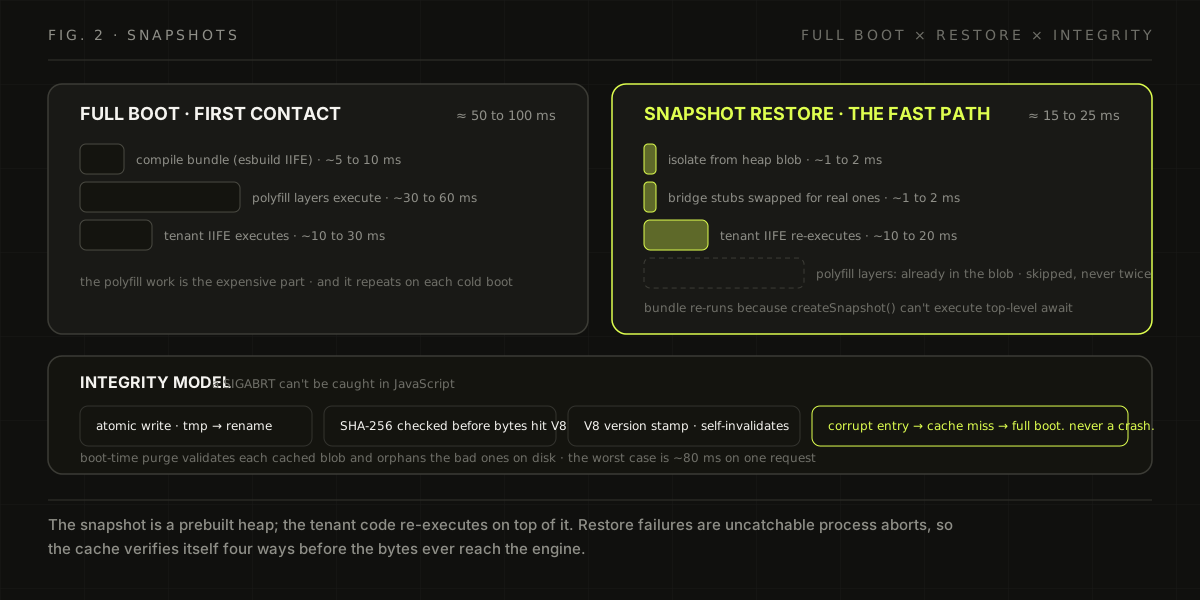
Lo difícil de los snapshots no es la velocidad. Es el modo de fallo. Un fallo de deserialización de V8 es un SIGABRT: el proceso muere, JavaScript no puede atraparlo, y un blob corrupto quieto en disco es un crash loop esperando ocurrir. Restaurar, abortar, reiniciar, restaurar el mismo blob, abortar otra vez. Así que el modelo de integridad trata la cache como entrada no confiable. Cuatro capas, en orden: las escrituras son atómicas (el blob cae en un archivo .tmp y se renombra, metadatos primero, de modo que un kill a mitad de escritura deja un par con discrepancia verificable, no un blob a medias); cada blob se firma con SHA-256 y el hash se verifica antes de que los bytes lleguen a V8; el estampado de versión de V8 hace que la cache se autoinvalida en el instante en que Node se actualiza en la flota; y al arranque del proceso, una pasada de purga valida los snapshots cacheados en disco y borra los malos. El invariante de diseño debajo de todo esto: una entrada corrupta de la cache degrada a un arranque frío de 100 ms. Nunca degrada a un crash. Ese es todo el incidente: 80 ms extra en una request.
La capa de snapshot también hace doble de hibernación. Los bundles stateful exponen hooks de getState y setState con un presupuesto de serialización de 1 s, para que un tenant que mantenga un working set en memoria pueda extraer su estado, jubilar su isolate y reinyectar su estado en la siguiente request. La misma maquinaria, dirección contraria.
Invariantes: lo que una fase debe a la siguiente
La capa de arriba es tan honesta como sus invariantes, y los invariantes se pudren cuando viven en la cabeza de la gente. El runner entonces carga un contrato por escrito: 34 reglas a través de sus 4 fases (boot, snapshot, dispatch, dispose), junto al código que gobiernan, leídas en cada review que toque ese archivo. Las fases son el ciclo de vida; las reglas son lo que una fase le debe a la siguiente. La mayoría son reglas de «no». No puente en un snapshot. No timer del host que sobreviva a su isolate. No dispatch que se salte la atribución de timeout.
Dispose es donde el contrato rinde, porque el disposal es la única fase donde equivocarse con el orden deja algo filtrando. Jubilar un isolate es una secuencia fija de 5 pasos: primero abortar el AbortController, para que el HTTP pendiente muera con el abort; luego limpiar los timers del host, para que el guest no pueda reprogramarse; luego liberar los handles de referencia de isolated-vm en orden inverso de asignación; luego liberar el contexto y el isolate; y solo entonces poner en null la última referencia de JavaScript, para que nada ancle un heap muerto al proceso. El concepto es transferencia de propiedad: ningún puente puede sobrevivir al isolate al que apunta. Se salta un paso y se queda un heap que persiste, un timer que dispara contra un cadáver, o una request que sobrevive a su dueño. El orden carga peso, y el contrato lo dice por escrito.
La prevención de pérdida de datos recibe el mismo trato en el otro extremo del ciclo de vida. Antes de que una payload llegue al código del tenant pasa por una pasada de redacción que se carga al arrancar, no de forma perezosa: un control que aún no se cargó no existe. Las credenciales en tránsito y lo que parezca un secret se enmascaran antes de tocar una línea de log o un argumento del puente. Un DLP dentro del código del tenant es un DLP que el tenant puede desactivar; un DLP del lado host del puente, no.
Contención por construcción
Los límites del runtime no son un muro de números mágicos. Viven en un solo archivo, Limits.ts, que documenta, junto a cada constante, de dónde sale el número. El presupuesto de dispatch de 30 s viene del comportamiento del usuario: los clients de MCP de corriente dan por perdida una tool call en algún punto del rango de 30 a 60 s, así que más allá de 30 se están gastando recursos en un resultado que nadie lee. El keep-alive de 65 s espeja la ventana de idle del ALB. El horizonte del sweep pertenece al tier de idle de 30 min del tracker de conexiones. Un límite es la huella de una política, no una constante: cuando la política cambia, cambia un archivo y la derivación queda registrada.
Las credenciales siguen la misma disciplina. El mapa de secrets descifrados de un tenant se inyecta en el isolate como copia profunda en __vinkius_secrets: el guest lo lee, no puede escribir de vuelta al host. El runner mantiene una huella SHA-256 del mapa, no los valores, lo que hace que la reinyección en una request posterior sea un no-op barato cuando nada cambió. Cada token obtiene su propio runner y su propio isolate; no hay pooling que comparta estado de credenciales entre tenants, y ya.
La única forma de token que alcanza un isolate es el token de conexión en vivo, lo que tenga el prefijo vk_live_. Tokens de preview, tokens revocados, tokens de otro deploy: fallan en el límite del runner, antes de que se registre un puente. La única capacidad que el guest sí sostiene es VINKIUS_TOKEN, expuesta al código de tools del catálogo: autentica a una tool de vuelta a la plataforma como el usuario que la posee, limitada al catálogo de ese usuario. El modelo son capacidades, no contraseñas: cada cruce del límite es un derecho nombrado, auditado y revocable.
Lo que un bundle no puede hacer está documentado con la misma positividad que lo que puede: sin filesystem, sin process.env, sin acceso directo al puente (el sanitizer lo rechaza en tiempo de compilación), 128 MB de heap, timers de 30 s, 10 logs por segundo y 1 KB por mensaje a través del puente de console, y un techo de fetch de 10 MB. Cuando un tenant cruza la línea financiera, el circuit breaker no devuelve un 429 y se encoge de hombros. La capa de cuota emite un error nativo para IA: lenguaje llano que le dice al LLM que deje de reintentar y que le muestre al usuario humano el techo del presupuesto, con un link a la consola de Vinkius Cloud donde el dueño aprueba reanudar. Una tormenta de reintentos es el modo de fallo nativo de los agentes; la plataforma debe responderle al agente, no solo a la persona de detrás.
Lo que la plataforma posee
Todo esto corre sobre una flota pequeña, deliberadamente x86-only. El pin de x86 es una restricción que sostengo por escrito: isolated-vm es un addon nativo, y sus builds de ARM han sido la dependencia más inestable que lanzamos. En x86 es aburrido, y aburrido es lo que se busca en la capa donde corre el código de otros.
El proceso arranca vacío. No se carga config al arrancar; la primera conexión para un token tira la config del servidor de la API de Laravel bajo demanda, arranca el isolate de ese servidor just in time, y un LRU sweep jubila las entradas después de 30 min de idle, para que una sola task sostenga el estado en vivo de muchos tenants. Redis carga el control plane (invalidación, kill switches, notificaciones de cambio de tool, actualizaciones de cuota), para que un cambio de config en la consola llegue a todas las tasks sin un deploy.
Una última pieza de la historia de seguridad vive junto a los isolates, y cierro con ella porque muestra el límite que dibujamos a propósito: el camino de auditoría criptográfico. Cada evento de tool call fluye a un daemon de streaming de un solo hilo que teje una cadena de hashes SHA-256 y la firma con una clave de sesión Ed25519, que vive en RAM 24 h y es certificada por la clave maestra al arrancar. Tras un crash, el daemon reprocesa los eventos sin ACK, para que la cadena nunca tenga huecos. Cada eslabón tejido se checkpointea en un grupo de consumers de Redis Streams, para que un crash retome desde el último evento ACK y no desde rederivar la cadena, y los adaptadores de SIEM drenan ese mismo stream detrás de sus propios circuit breakers: un sink que falla se aísla, en vez de dejarse atascar el camino de auditoría. La regla que hizo necesario al daemon cabe en una línea de su fuente: V8 nunca toca crypto. El código del tenant puede calcular hashes a través de los puentes del host, pero no puede firmar, certificar ni forjar nada. El rastro de auditoría es algo que la plataforma hace al runtime, no algo en lo que los tenants del runtime pueden meterse.
La dirección
La capa de isolates hoy es la historia stateless, rápida y con tope duro: arrancar en uno o dos milisegundos, topar a 128 MB, jubilar en un sweep, y dejar que el snapshot cargue con la parte pesada. La dirección abierta es la stateful: estado de tenant de vida más larga montado en los hooks de hibernación, empaquetado más denso de isolates en vivo por task, y que los equipos traigan en definitiva sus propios catálogos de conectores al marketplace sin esperar a nuestro CI.
No creo que los isolates de V8 sean la respuesta final al código edge multi-tenant. Son la respuesta para la forma que esta plataforma tiene, y esa forma es donde quiero que se quede: tenants baratos, topes duros y arranque a escala de milisegundos, porque la paciencia de un agente se mide en segundos, y su confianza también. El «zero cold start» de Cloudflare es una frase que se puede ingenierizar, no un eslogan que solo se admira. Es un isolate, un snapshot, una cadena de integridad y una serie de decisiones sin glamour sobre quién posee los timers. El código de este post es el runtime detrás de los servidores MCP en cloud.vinkius.com, y el trabajo de tracing que enlaza sus spans de tool en trazas distribuidas está en el post de MCP Fusion 5.1.0. La dirección stateful hacia la que se mueve esta plataforma es la capa de sesiones en sí: cómo el SwarmGateway coalesce sesiones de agentes superpuestas y aplica invalidación causal sobre estado obsoleto. La arquitectura completa está en la publicación sobre sesiones de SwarmGateway.
El sandbox de isolate V8 y su secuencia de arranque de 12 pasos se cubren con código fuente en Preguntas de IA Empresarial.