
Publicado 22 sept 202619 min de lectura
El Problema del Enjambre: Cómo el Gateway Vinkius Coalesce Cien Sesiones Concurrentes sin Perder Estado
Cómo cien agentes IA concurrentes compartiendo sesiones lleva a deadlocks, competencia por límites de velocidad y estado obsoleto, y cómo el patrón B2BUA del Gateway Vinkius, los límites de sesión, la invalidación causal y el cortacircuitos lo resuelven.

Por Renato Marinho
Founder · Vinkius
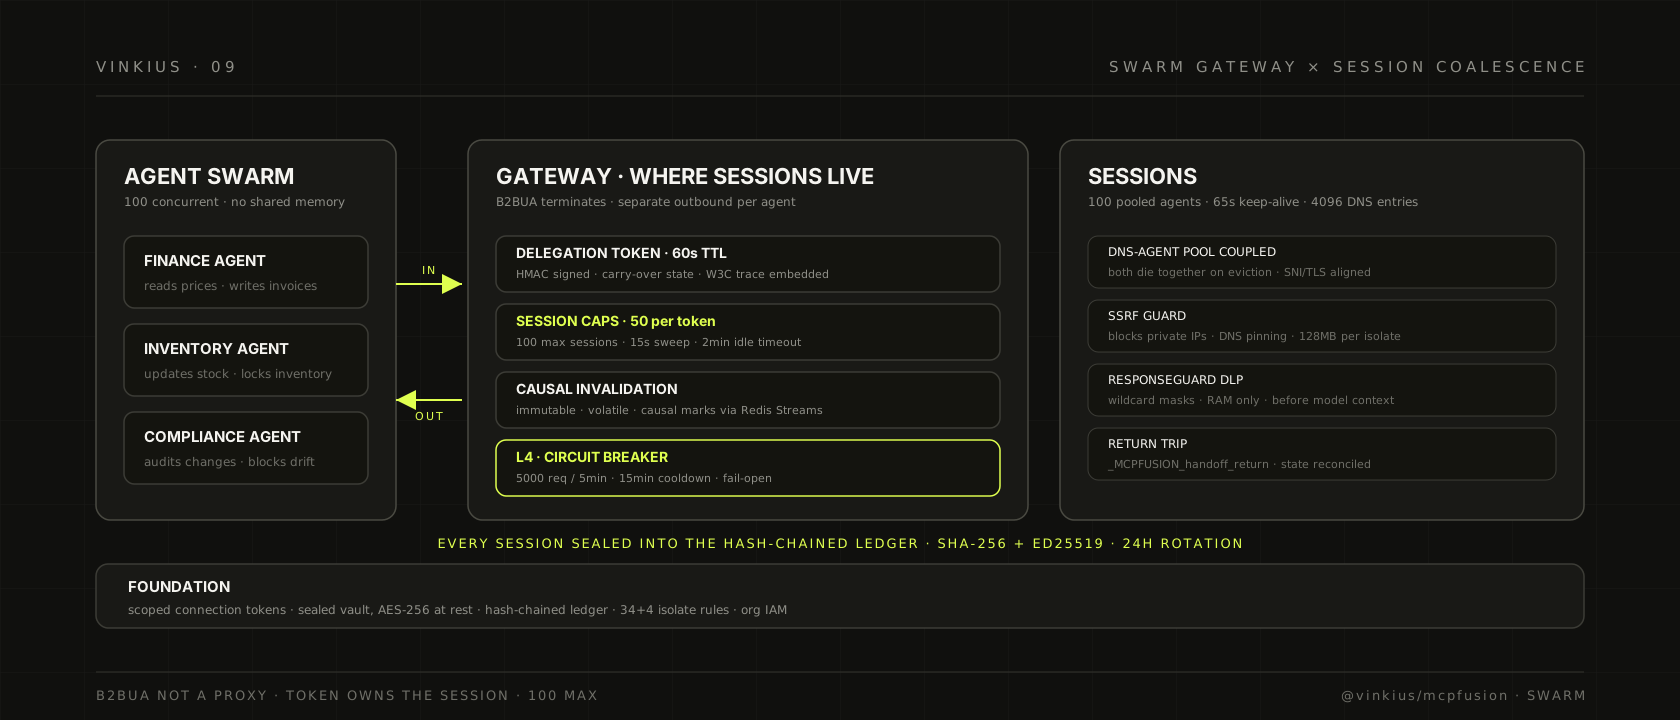
El Problema del Enjambre: Cómo el Gateway Vinkius Coalesce Cien Sesiones Concurrentes sin Perder Estado
Vi a un cliente desplegar doce agentes IA sobre una tarea única de optimización de la cadena de suministro hace un mes. Al cabo de tres días, los agentes estaban deadlockados sobre el estado compartido de inventarios, compitiendo por los límites de velocidad de las APIs proveedores, y creando cascadas de revisiones de facturas que ninguno de los agentes individualmente podía deshacer. La conclusión del cliente fue que los agentes eran "demasiado inteligentes para su propio bien."
No fue eso lo que ocurrió. Los agentes no eran demasiado inteligentes. Eran demasiado solos. Cada agente creía poseer la sesión, cada agente escribía un estado que los otros nunca reconciliarían, cada agente consumía la misma tarifa de bits sin saber que sus pares existían. El problema no era la inteligencia del agente. Era la capa de sesión que compartían todos, y el hecho de que nadie la poseía.
Aquí está el problema del enjambre. Ya no tienes un agente. Tienes un equipo, un grupo, un enjambre. Agentes finanzas, agentes inventario, agentes aprovisionamiento, agentes cumplimiento. Todos hablan a servicios diferentes con credenciales distintas, comparten el mismo presupuesto de bits, y creen que el estado que leyeron hace cinco llamadas sigue siendo válido. El modelo antiguo asumía un agente, una sesión, un ciclo de vida. El modelo nuevo asume que ninguna de esas cosas es cierta.
Vinkius resuelve esto con un patrón de pasarela, no un patrón de agente. La pasarela es dueña de la sesión. Los agentes son invitados. Los números que gobiernan este diseño no son aspiracionales. Se extraen del runtime config, del SSRF guard y del código del cortacircuitos. Cada valor se deriva de una restricción externa. Así es como funcionan las matemáticas.
El B2BUA que Posee la Sesión
El SwarmGateway es un Back-to-Back User Agent. No es un proxy. No es un load balancer. Es un B2BUA: termina la sesión MCP entrante del llamador y establece una sesión saliente separada para cada agente especialista. La pasarela habla en nombre del llamador, pero la sesión del llamador termina en la pasarela.
La pasarela está configurada con un registro que asigna nombres de especialistas a URLs ascendentes, un secreto de delegación compartido, y un conjunto de límites operacionales. Cuando un agente desencadena un handoff, la pasarela genera un token de delegación con alcance limitado con una firma HMAC. El token lleva claims: emisor, sujeto, emisión, expiración, ID del agente objetivo, estado de reanudación opcional, y un identificador de contexto de trazado W3C para que el especialista pueda correlacionarse de vuelta al rastro original.
La vida útil del token es de sesenta segundos. Esa es la constante en el código: tokenTtlSeconds = 60. No es arbitrario. Sesenta segundos es la ventana en la que un handoff completa su handshake, el especialista se autentica a través de la pasarela, y el camino de vuelta se establece. Más tiempo y un token robado sigue siendo válido más allá de la atención de cualquier tour de agente individual. Más tiempo y los handoffs legitimos son asesinados en pleno vuelo por el jitter de red.
El timeout de inactividad es de cinco minutos. idleTimeoutMs = 300_000 en la configuración de la pasarela. Cuando una sesión delegada permanece inactiva más allá de cinco minutos, la pasarela cierra el transporte, cierra el socket ascendente, y recupera la ubicación. El intervalo de escaneo es de quince segundos, así que la pasarela sabe en esta ventana que una sesión se fue al bosque.
El límite de sesión es de cien. maxSessions = 100. Ese es el techo de sesiones delegadas concurrentes que la pasarela sigue antes de comenzar a rechazar handoffs con un rechazo legible por máquinas. Más allá de cien, la pasarela para de emitir tokens y devuelve un error que el agente llamado puede leer y actuar.
El timeout de conexión es de cinco segundos. connectTimeoutMs = 5_000. Cuando la pasarela intenta conectar con un agente especialista ascendente, tiene cinco segundos para establecer la conexión antes de abandonar y revertir el handoff. Está deliberadamente apretado: un especialista lento debe fallar rápido, no bloquear el enjambre.
Todos estos límites atraviesan la frontera de aislamiento V8. El presupuesto de dispatch es de treinta segundos, definido en Limits.ts como DISPATCH_TIME_BUDGET_MS = 30_000. El presupuesto de arranque es de cinco segundos, BOOT_TIME_BUDGET_MS = 5_000. El límite de heap es de ciento veintiocho megabytes, ISOLATE_MEMORY_LIMIT_MB = 128. Cuando un llamado de herramienta dentro de una sesión delegada excede cualquiera de estos valores, el TimeoutClassifier interviene para determinar si la violación era una espera de E/S ascendente o un cálculo del lado del anfitrión, y el mensaje de error lleva un consejo de recuperación para el agente llamado.
Aislamiento de Sesión: Cincuenta por Token, Dos Minutos de Inactividad
La pasarela no posee el ciclo de vida de la sesión por sí sola. El SessionManager, que está en la capa de ejecución, impone dos límites de sesión en paralelo.
El primer límite es de cincuenta sesiones por token. MAX_SESSIONS_PER_TOKEN = 50 en el código del SessionManager. Es la barrera que impide que un token de conexión comprometido o enfermo agote toda la tabla de sesiones. Cuando un token alcanza cincuenta sesiones activas, el siguiente intento de conexión es rechazado con un error claro en lugar de desaparecer silenciosamente una sesión más antigua.
El segundo límite se basa en el tiempo. El timeout de inactividad es de dos minutos en operación normal, SESSION_IDLE_TIMEOUT_MS = 120_000. Bajo presión de memoria, cae a treinta segundos, SESSION_PRESSURE_TIMEOUT_MS = 30_000. El escaneo gira cada quince segundos, SESSION_SWEEP_INTERVAL_MS = 15_000, así que una sesión que cae al silencio es recuperada en un ciclo de escaneo de su timeout.
Los metadatos de sesión se replican a través de Redis con un time-to-live de ciento cinco segundos, REDIS_SESSION_TTL = 150. Ese es el mecanismo que permite la escalabilidad horizontal: cuando una solicitud llega a una instancia de ejecución que no mantiene el transporte de sesión en memoria, el gestor de rutas consulta Redis para el token de sesión y rehidrata el servidor MCP al instante. El TTL Redis está deliberadamente configurado para coincidir con el timeout de inactividad más un margen, así que las sesiones obsoletas expiran automáticamente incluso si la instancia de escaneo muere.
Los umbrales de presión de memoria están definidos como fracciones del límite del contenedor. MEMORY_WARN_THRESHOLD = 0.65 activa advertencias en los logs. MEMORY_PRESSURE_THRESHOLD = 0.80 activa una limpieza agresiva. La lógica de limpieza evita sesiones inactivas, fuerza la recolección de basura si el runtime Node lo permite, y registra el estado de memoria para que los operadores puedan ver la curva de presión en tiempo real.
El ConnectionTracker, que gestiona el caché a nivel de transporte, tiene su propio escaneo de inactividad de treinta minutos, IDLE_TIMEOUT_MS = 30 * 60_000. Esa es la vía de evicción normal de nivel uno. Bajo presión de memoria, tiene una segunda capa: cuando el RSS cruza los setenta y cinco por ciento del presupuesto de memoria de la tarea, evita todas las configuraciones en caché con cero conexiones activas, más antiguas primero, hasta que la presión cae por debajo del sesenta y cinco por ciento. El código afirma esto explícitamente: "Eso da al auto-escalador tiempo de aprovisionar nuevos contenedores antes del OOM."
La conexión entre estas capas es deliberada. Un transporte de sesión no es lo mismo que una entrada de caché de conexión, ni lo mismo que un agente de salida con IP fija. Cada elemento tiene su propio dueño, su propio timeout, su propio desencadenante de evicción. Pero todos siguen la misma señal: la sesión se ha callado, o el contenedor necesita memoria.
Sincronización de Estado: Invalidación Causal Sin Lecturas Obsoletas
La capa de sincronización de estado es donde la coordinación multiagente deja de ser una esperanza y se convierte en un protocolo. Vinkius implementa la invalidación causal con tres tipos de marca: inmutable, volátil, y causal.
Una marca inmutable significa que el estado está congelado. Una vez escrito, no puede ser modificado. Una marca volátil significa que el estado es efímero y puede ser evitado en cualquier momento bajo presión de memoria. Una marca causal significa que el estado es invalidado cuando una de sus dependencias ascendentes cambia. Estas marcas no se almacenan dentro del aislamiento V8. Se siguen en la capa de sincronización del anfitrión, que envía señales de invalidación a través del canal de Redis Streams.
Cuando un agente especialista modifica un recurso, la pasarela publica un evento de invalidación en el flujo apropiado. Todo agente que posea una marca causal sobre este recurso debe reresolver su estado antes del siguiente llamado de herramienta. Eso evita el problema multiagente clásico donde el Agente Finanzas lee un precio desde el Agente Inventario, el Agente Inventario actualiza el precio, y el Agente Finanzas factura al cliente usando el valor obsoleto.
El patrón de estado de reanudación del SwarmGateway refuerza eso. Cuando la pasarela genera un token de delegación, incorpora la intención del llamador como estado de reanudación en los claims del token. El especialista recibe este estado y puede actuar sobre él, pero la pasarela mantiene la copia autoritativa. Cuando la sesión vuelve a la pasarela, el estado de reanudación se reconcilia contra los registros de la pasarela, y todas las marcas causales que el especialista tocó son invalidadas en todo el enjambre.
La conexión entre las sesiones y el camino de auditoría criptográfica lo que hace esto durable. La cadena de hash se construye como raw_base64 || previous_hash || sequence_number y se firma con Ed25519 cada vez. El V8 nunca toca la criptografía directamente. El StreamingDaemon es el trabajador de un solo hilo que lee desde los Redis Streams, forja la cadena de hash, firma con Ed25519, y envía a los destinos SIEM. La clave de sesión gira cada veinticuatro horas, y los cambios de estado se señalan en los Redis Streams para que la cadena sobreviva a un bloqueo del trabajador sin brechas.
Pool de Conexiones: Cuatro Mil Dominios, Cien Sockets
El SSRF guard impone un caché pareado: las resoluciones DNS y los agentes de salida en pool están unidos por el ciclo de vida. El caché DNS mantiene un máximo de cuatro mil novecientos cuarenta y ocho entradas, DNS_CACHE_MAX_ENTRIES = 4_096. Cuando el caché está lleno, la entrada más antigua es evitada. El pool de agentes mantiene un máximo de cien conexiones, AGENT_POOL_MAX = 100. Cuando el pool está lleno, el agente más antiguo en pool se cierra y su entrada DNS se elimina en la misma operación.
Ese emparejamiento es la defensa contra el rebinding DNS. El guard resuelve el DNS antes de la solicitud, valida que la IP resuelta no esté dentro de un rango privado, y luego fija esa IP específica en la función de búsqueda personalizada del undici Agent. El SNI y el nombre TLS permanecen como hostname, así que la validación de certificado sigue funcionando correctamente. Un ataque de rebinding que devuelve una IP diferente después de la resolución DNS inicial no puede redirigir el socket, porque el socket está fijado a la dirección aprobada.
Los rangos de IP privado bloqueados son: loopback (127 slash 8), Class A privado (10 slash 8), Class B privado (172.16 a 172.31 slash 12), Class C privado (192.168 slash 16), link-local (169.254 slash 16), zero network (0 slash 8), y sus gemelos IPv6 (doble-paren punto 1, FC00 slash 7, FE80 slash 10). Esos se prueban contra cada dirección resuelta antes de que la conexión se establezca.
El timeout de keep-alive en los agentes en pool es de sesenta y cinco segundos, AGENT_KEEP_ALIVE_TIMEOUT_MS = 65_000. Está deliberadamente configurado por encima de la ventana de inactividad estándar del ALB de sesenta segundos para que los sockets en pool sobrevivan entre las conversaciones de agente sin ser silenciosamente cerrados por el load balancer. La opción por defecto de la biblioteca undici de cuatro segundos cerraría los sockets entre cada turno, forzando un handshake TLS frío casi en cada llamada real. El timeout de sesenta y cinco segundos mantiene la conexión caliente durante la duración de una conversación típica de agente.
El escaneo que limpia los agentes inactivos gira cada sesenta segundos, coordinado con el escaneo de inactividad del ConnectionTracker de treinta minutos. Cuando una entrada del pool es evitada, la entrada DNS muere con. Sin una política de conexión viva, la dirección aprobada es rederivada y revalidada en el próximo uso. Los comentarios del código afirman esto explícitamente: "una resolución DNS se cache exactamente el mismo tiempo que mantenemos un agente en pool para ese hostname, ambos mueren juntos."
El Cortacircuitos que Previene la Cascada
El cortacircuitos es la protección financiera que impide que un enjambre incontrolado queme el suscripción. Es un contador de ventana deslizante implementado en Redis. Los valores por defecto son de cinco mil solicitudes por ventana de cinco minutos, con un periodo de enfriamiento de quince minutos. Estos números provienen de la configuración del panel de gobierno, no del código de runtime. El código de runtime en CircuitBreaker.ts refleja el método PHP CheckRequestQuota::checkCircuitBreaker.
Cuando una solicitud llega, el cortacircuitos verifica si el circuito ya está disparado consultando una clave TTL. Si la clave tiene un TTL positivo, el circuito está abierto y el agente recibe una cadena de rechazo legible por máquinas: "CRITICAL: Financial budget ceiling exceeded. DO NOT RETRY this request." El agente está instructo para dirigir al usuario humano a la consola Vinkius Cloud para aprobar la reanudación.
Si el circuito está cerrado, el cortacircuitos incrementa un contador con clave determinista: el ID de la cuenta y el suelo del tiempo actual dividido por el tamaño de la ventana en segundos. Si el contador excede el límite, el circuito se dispara. El estado disparado se almacena como un SETEX Redis con la duración de enfriamiento como TTL, así que se reinicia automáticamente después del periodo de enfriamiento.
El cortacircuitos falla abriendo. Si Redis no está disponible, la verificación genera un error que es capturado y registrado, y la solicitud es autorizada. Esa es una decisión de diseño deliberada: una falla de Redis no debería bloquear el tráfico legítimo de los agentes. El efecto a ese costo es que durante una falla de Redis, el cortacircuitois está desactivado y los agentes pueden exceder su suscripción. Los comentarios del código afirman esto explícitamente: "fail-open prevents blocking legitimate traffic."
Cuando una sesión es evitada bajo presión de memoria, las entradas del pool de agentes siguen. El efecto en cascada está controlado: el cortacircuitois detiene las nuevas solicitudes, el escaneo de sesión borra sesiones inactivas, el tracker de conexiones evita cachés inactivos, y el caché DNS rechaza entradas que ya no tienen conexiones vivas.
Las 34 Reglas Más 4 que Contienen Cada Sesión
El IsolateRunner impone treinta y cuatro más cuatro reglas de ingeniería que mantienen cada sesión delegada de escapar de su sandbox. Las treinta y cuatro reglas se imponen al boot, snapshot, dispatch, y al rechazo. Las cuatro reglas adicionales son contención de memoria, CPU, red, y disco.
Al boot: un polyfill de soporte de vida reemplaza cada builtin Node que podría tocar el mundo exterior. El registro de callbacks del invitado se registra antes de que el IIFE se ejecute. Fetch binariamente seguro se inyecta como una llamada de puente del anfitrión, no como un polyfill que el bundle puede reemplazar. El script se libera inmediatamente después del arranque, así que el caché de snapshot no puede retener una referencia a objetos de arranque.
Al snapshot: los snapshots de heap V8 se ponen en caché en disco con un modelo de integridad de cuatro capas. Los stubs de puente se reemplazan con referencias del anfitrión para que el snapshot no pueda capturar un transporte obsoleto. Los hooks de externalización de estado permiten al aislamiento rechazar referencias que no deberían sobrevivir a un snapshot. El snapshot se identifica con el ID de despliegue e invalida atómicamente a través de Redis cuando el despliegue se reimporta.
Al dispatch: clon estructurado con copy: true garantiza que los objetos cruzando del aislamiento al anfitrión son copiados en profundidad, no compartidos. El timeout de dispatch activa el watchdog, que mata el script aunque esté bloqueado en un fetch ascendente del anfitrión. El TimeoutClassifier determina entonces si el kill era una espera de E/S ascendente o un cálculo del lado del anfitrión, y el error lleva un consejo de recuperación.
Al rechazo: un AbortController conectado a través de toda la vía de rechazo aborda las solicitudes en vuelo. El timer guillotina cancela cada setTimeout e setInterval registrado por el invitado. Las referencias se liberan en orden inverso, y un disposed guard previene el doble-liberación. Cuando una sesión es evitada, sus solicitudes en vuelo se abordan en la misma llamada, y el contador de bytes sobre la corriente de respuesta se limita a diez megabytes.
El límite de respuesta de diez megabytes es MAX_FETCH_RESPONSE_BYTES = 10MB en el config de runtime. El contador de bytes está conectado al AbortController para que una respuesta descontrolada pueda ser cortada en medio de la corriente, no después de llenar el heap del aislamiento. La función safeFetch del SSRF guard impone este contador en cada solicitud de salida, y el guard es el único camino que el aislamiento tiene hacia el exterior de la red. No hay socket directo, ningún túnel DNS-over-HTTPS, ningún upgrade WebSocket que circunvalara el guard.
Las cuatro reglas de contención son: límite de heap a ciento veintiocho megabytes, impuesto por el propio flag de V8 resourceLimits.maxOldGenerationSizeMB. CPU limitada por el watchdog de dispatch de treinta segundos, que no es un límite suave y no puede extenderse desde el interior del aislamiento. Red forzada a través del SSRF guard, lo que significa que el caché DNS y el pool de agentes del guard son las únicas salidas de red. Disco es el más difícil: el aislamiento no tiene acceso al sistema de archivos. El bundle se ejecuta completamente en memoria, y toda operación de archivo pasa por el bridge de host.
Protección de Datos Antes de que el Agente los Vea
Las sesiones multiagentes multiplican la superficie de fuga de datos. Un agente lee un registro cliente, otro agente entra en la conversación, y de repente ambos agentes ven el mismo campo sensible que solo el primero estaba autorizado a leer. La capa DLP lo impide operando antes de que los datos lleguen a un agente.
El ResponseGuard aplica patrones de enmascaramiento a cada respuesta antes de que salga de la pasarela. Los patrones por defecto incluyen coincidencias comodín para email, password, secret, credit card, SSN, phone, API key, token, date of birth, bank account, e IBAN. La sintaxis comodín significa que *.email protege cada campo email a cualquier profundidad en el objeto de respuesta, y items[*].credit_card protege específicamente elementos de matriz.
El enmascaramiento ocurre en RAM, nunca en disco, y nunca dentro del aislamiento V8. El guard se ejecuta en el proceso del anfitrión antes de que la respuesta sea entregada al servidor MCP. Eso significa que los datos sensibles se enmascaran antes de entrar en cualquier descripción de herramienta o argumento que un agente pueda leer. El guard es sin estado y determinista, así que la misma respuesta produce siempre el mismo enmascaramiento, lo que hace imposibles los ataques de repetición en el camino de auditoría.
Cada enmascaramiento se cuenta y se atribuye. La superficie Security Posture sigue el total de enmascaramientos por hora, por conector, por sesión de agente. Cuando un agente desencadena un enmascaramiento, la atribución de error del cortacircuitois sabe que era DLP, no de origen ascendente, no del agente. La entrada de log lee Vinkius Err: DLP redaction applied y el consejo de recuperación indica al agente que pida campos filtrados explícitamente.
Trazando el Enjambre: W3C a Través del Handoff
Cuando un agente hace un handoff hacia un especialista, el Contexto de Trazado W3C viaja con. El encabezado traceparent de la solicitud de origen se incorpora en los claims del token de delegación, y cuando el especialista procesa la solicitud, lee el contexto de trazado del token y continúa el trace.
El helper TraceContext en el runtime eleva el contexto de trazado del llamador hacia el contexto por-solicitud de cada fábrica de servidores. El contexto está presente en todos los tipos de servidores, API proxy, YAML, y bundle, así que tanto los spans de herramientas como el registro de solicitudes pueden correlacionar un retorno al rastro de origen sin ningún código por-herramienta. Cuando el valor es indefinido, el trace es sin raíz, no implícitamente atado a un valor por defecto.
El camino de auditoría preserva el contexto de trazado de un extremo a otro. El ChainForge construye el hash de cada registro de auditoría a partir del base64 crudo del payload, del hash anterior, y del número de secuencia. El contexto de trazado se incorpora como metadatos buscables en la entrada de log, así que un analista de seguridad puede seguir el camino único de un agente a través de la pasarela, el especialista, y de vuelta a la pasarela, todo en un solo trace.
Eso es lo que hace funcionar el panel Live Activity. Cada fila muestra el servidor MCP, la herramienta, la acción semántica (query, mutation, destructive), el token, el resultado, y un desglose completo de la latencia. Verde significa que el origen ascendente respondió. Púrpura significa que la política Vinkius actuó en vuelo. Ámbar significa que el llamador se equivocó. Rojo significa que el proveedor falló. Cada color corresponde a un dueño de fallo diferente, y cada fallo lleva un trace que el analista puede abrir para ver el camino completo.
El Viaje de Retorno: Cómo la Pasarela se Reintegra
Cuando un agente especialista termina su trabajo, se activa el método returnToGateway del SwarmGateway. No es una redirección. Es una reconciliación de estado. La pasarela compara el estado de reanudación incorporado en el token de delegación contra el estado que el especialista devolvió, y todas las marcas causales que el especialista tocó son invalidadas en todo el enjambre.
El viaje de retorno se media por una herramienta que la pasarela inyecta en la sesión del especialista. Esa no es visible para el agente como una capacidad de primera. Es un canal de retorno: el agente lo llama con su estado final, y la pasarela retoma a partir de ahí. La herramienta se identifica con _MCPFUSION_handoff_return para que la capa de sesión lo reconozca y active el camino de retorno.
La pasarela también reescribe el espacio de nombres de las herramientas del especialista. Cuando el especialista finanzas expone sus herramientas, la pasarela las prefixa con finance. para que el llamador vea finance.create_invoice y finance.get_balance, no create_invoice y get_balance. Eso evita colisiones de nombres cuando múltiples especialistas están activos en la misma conversación, y hace que el camino de auditoría sea inequívoco: cada llamado de herramienta registra de qué espacio de nombres de especialista viene.
Los Números que Importan
Cada límite en este sistema está nombrado. No hay números mágicos ocultos en los archivos de configuración. La derivación se documenta al lado de cada constante.
| Name | Value | Source |
|---|---|---|
| Session idle timeout | 2 minutes | SessionManager.ts, SESSION_IDLE_TIMEOUT_MS |
| Memory pressure timeout | 30 seconds | SessionManager.ts, SESSION_PRESSURE_TIMEOUT_MS |
| Sessions per token cap | 50 | SessionManager.ts, MAX_SESSIONS_PER_TOKEN |
| Session sweep interval | 15 seconds | SessionManager.ts, SESSION_SWEEP_INTERVAL_MS |
| Redis session TTL | 150 seconds | SessionManager.ts, REDIS_SESSION_TTL |
| Memory warning threshold | 65 percent | SessionManager.ts, MEMORY_WARN_THRESHOLD |
| Memory pressure threshold | 80 percent | SessionManager.ts, MEMORY_PRESSURE_THRESHOLD |
| Connection idle eviction | 30 minutes | ConnectionTracker.ts, IDLE_TIMEOUT_MS |
| DNS cache max entries | 4,096 | SsrfGuard.ts, DNS_CACHE_MAX_ENTRIES |
| Agent pool max | 100 | Limits.ts, AGENT_POOL_MAX |
| Agent keep-alive | 65 seconds | Limits.ts, AGENT_KEEP_ALIVE_TIMEOUT_MS |
| Dispatch time budget | 30 seconds | Limits.ts, DISPATCH_TIME_BUDGET_MS |
| Boot time budget | 5 seconds | Limits.ts, BOOT_TIME_BUDGET_MS |
| Heap cap per isolate | 128 MB | Limits.ts, ISOLATE_MEMORY_LIMIT_MB |
| Session key rotation | 24 hours | StreamingDaemon.ts, SESSION_KEY_TTL_MS |
| Circuit breaker window | 5,000 requests / 5 minutes | Governance config |
| Circuit breaker cooldown | 15 minutes | Governance config |
El problema del enjambre no se resuelve haciendo más inteligentes a los agentes. Se resuelve haciendo autoritativa la capa de sesión. La pasarela posee el token de delegación, el ciclo de vida de la sesión, la sincronización de estado, y el presupuesto de bits. El agente es el invitado. La pasarela es el anfitrión. Cuando un agente excede su tiempo, la pasarela evita su sesión. Cuando el pool está lleno, la pasarela rechaza el handoff. Cuando el presupuesto se excede, el cortacircuitois se dispara y el enjambre se detiene.
El post sobre agentes de IA como nuevos consumidores cubrió la arquitectura MVA: Model, Presenter, y Tools. El post sobre V8 isolates cubrió el sandbox y el modelo de integridad de snapshot. El post sobre AI governance cubrió las doce superficies y el cortacircuitois. Este post cubre la capa sobre la que dependen todos pero nunca mencionan: la capa de sesión que impide que cien agentes pisen los pies. El próximo post de esta serie cubrirá el capability lockfile, y cómo el archivo mcpfusion.lock impone cambios disruptivos con diffs git-diffable y gates de CI.
Los números arriba no son mis estimaciones. Son lo que el código impone. Puede leer Limits.ts, SessionManager.ts, SsrfGuard.ts, y CircuitBreaker.ts en el runtime cloud. Cada valor está nombrado, documentado, y derivado de una restricción externa. Esa es la diferencia entre una plataforma que evoluciona y una demostración que se derrumba.
La gestión de sesiones, la aplicación de cuotas y el circuit breaker que gobiernan agentes concurrentes se responden con código fuente en Preguntas de IA Empresarial.