
Publicado 21 sept 202621 min de lectura
IA Governance: el plan de control detrás de cada tool call de tus agentes
Vinkius IA Governance: el plan de control que atribuye cada tool call MCP a una identidad, protege datos en vuelo, presupuesta el gasto de los agentes y sella un comprobante de auditoría encadenado por hash para el regulador, el equipo financiero y el page de las 3 a. m.

Por Renato Marinho
Founder · Vinkius
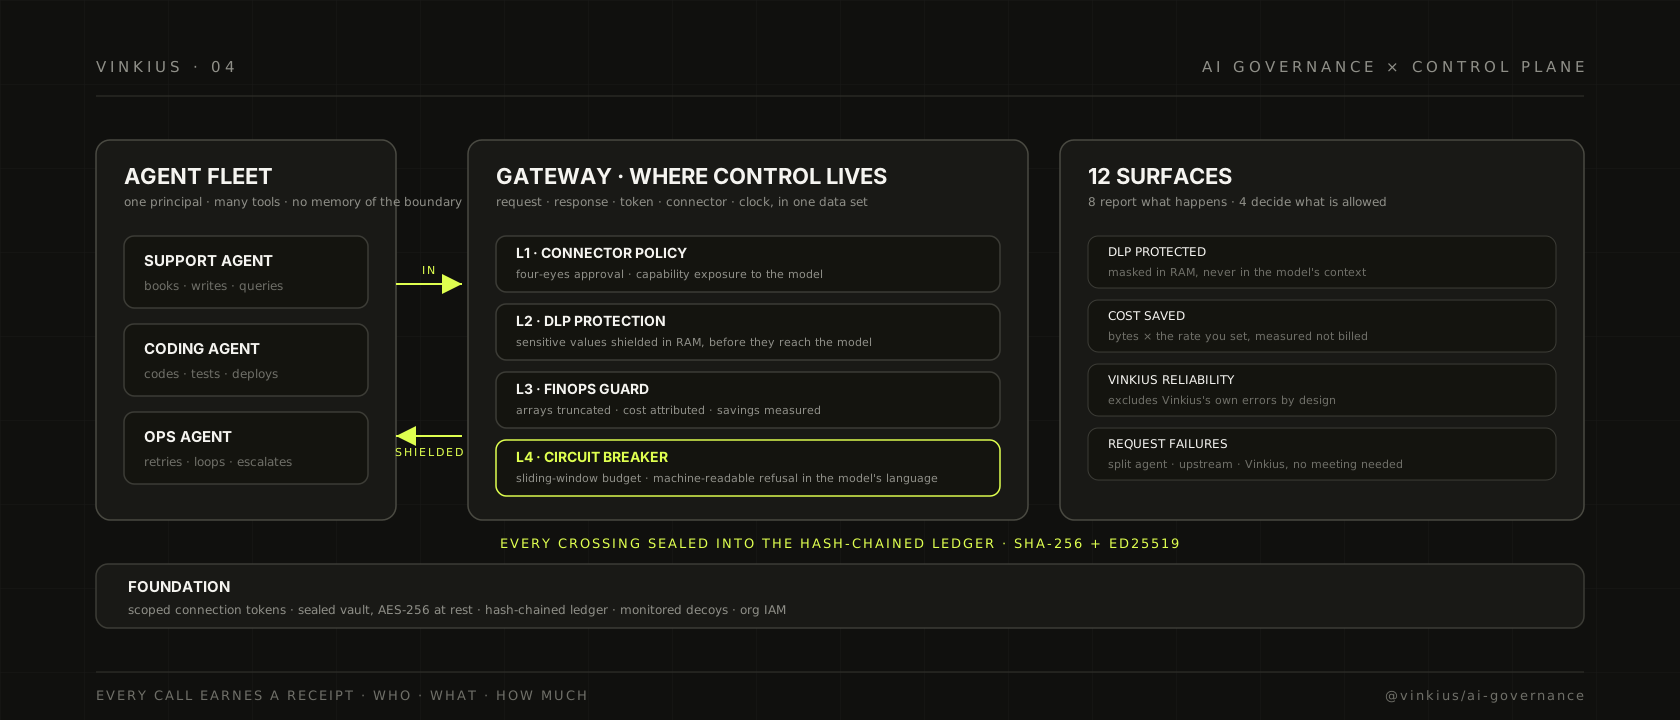
Hace seis meses todavía veía a equipos demostrar agentes. Hoy veo agentes que actúan. En algún punto entre los dos, el centro de gravedad de la infraestructura agéntica se movió de "¿puede el modelo hacer la tarea?" a "¿sobrevives al momento en que la respuesta deja de ser respuesta y se vuelve acción?". Una llamada de herramienta es una escritura al mundo. Sale un correo. Se actualiza una fila. Se registra un pedido. Se elimina un archivo. Lo que decide es probabilístico; lo que ejecuta no lo es. Cada incidente en sistemas agénticos vive en ese hueco, y este post es sobre cerrarlo.
Fundé Vinkius a partir de una convicción: una nube para agentes de IA solo está lista cuando puedes responder cuatro preguntas sobre cualquier llamada de herramienta, en cualquier momento, con evidencia adjunta. Quién llamó. Qué estaba permitido que pasara. Qué cruzó el gateway, y qué se protegió de camino. Y cuánto costó. La respuesta a esas cuatro preguntas es el plano de control que entregamos como doce superficies: ocho que te cuentan qué está pasando, y cuatro que deciden qué está permitido. Todo lo que sigue es lo que la plataforma hace hoy. Los números son los que el sistema aplica o reporta, no los que yo hubiera querido.
El momento en que los agentes dejan de hablar y empiezan a actuar
En la empresa, la respuesta de incidentes estuvo tranquila durante años, porque lo que se rompía era construido por humanos y cambiaba despacio. Un servicio tiene un dueño, un changelog, un post-mortem y una población fija de llamadores. Cuando el llamador es un modelo, todo eso se evapora en una decisión de diseño. El mismo agente puede agendar una reunión por la mañana, escribir código al mediodía y consultar una base de datos de producción por la tarde. Para eso están los sistemas agénticos: un principal, muchas herramientas, y ninguna memoria del límite entre ellas. Las categorías de falla cambian con eso.
El monitoreo clásico pregunta "¿falló la llamada y por qué?". Con agentes hay que hacer cuatro preguntas más, y cada una tiene su propia forma de respuesta. ¿La falla es del agente, porque mandó una solicitud mal formada o quedó en loop sobre una herramienta rota? ¿Es del servicio de afuera, porque la API que llamó devolvió un 500? ¿Es de la plataforma, porque el gateway se comportó mal? Y está la que nadie hace hasta que la hace el equipo de finanzas: cuánto costó todo eso, por llamada, por conector, por agente, en dólares?
Leí reportes de incidente suficientes, en este rubro y en el mío, para conocer el patrón de respuesta. Casi siempre es "no pudimos saber qué agente hizo qué, y lo supimos después del daño". Un llamador no determinístico y un sistema de logs a posteriori son una pésima pareja. El log es una foto del lugar del hecho, y el sospechoso ya salió del edificio. La gobernanza es la arquitectura que hace que el sospechoso, el arma y la marca de tiempo se registren en el momento del acto, y no después.
Qué es realmente la gobernanza de IA
La gobernanza de IA, en el sentido que la industria necesita, es el plano de control que rodea el tráfico de agentes hacia herramientas. No es un motor de políticas en el sentido tradicional de OPA, que decide en el deploy qué reglas recibe un servicio. No es RBAC, que decide qué humano puede entrar. No es un SIEM, que correlaciona logs después del hecho. Todos esos sistemas fueron diseñados para un mundo donde lo que actúa es una persona o un pipeline fijo.
Lo que hace la gobernanza de IA es distinto, y vale la precisión. Decide, por llamada, si la acción de un principal no determinístico está permitida para pasar, en una máquina, contra el sistema de un tercero, bajo un presupuesto. Y guarda, para cada llamada, un comprobante que responde quién, qué y cuánto. La palabra "gobernanza" está haciendo trabajo real aquí, y no es solo una palabra de cumplimiento. El cumplimiento es la salida. La entrada es un plano de control con dos propiedades: atribución en granularidad de identidad, y ejecución en vuelo, antes de que la llamada salga de tu infraestructura.
En Vinkius, ese plano de control se llama Gobernanza de IA, y se organiza en doce superficies. Ocho superficies de reporte cuentan qué está pasando en la flota de conectores que tus agentes usan. Cuatro superficies de política deciden qué está permitido, y se ejecutan en el runtime, en el camino de la llamada, no en un dashboard que abres los lunes. La división es deliberada. Un dashboard sin acción posible es teatro, y una política sin comprobante es miedo. Las dos mitades hacen falta, y el producto es la unión de ambas.
Por qué el gateway es el único lugar donde el control puede vivir
El argumento arquitectónico es corto. Tus agentes no llaman a tus APIs de afuera directamente. Llaman a herramientas, y en Vinkius esas herramientas son conectores, servidores MCP hospedados que cada agente de la flota alcanza por un solo gateway. El gateway es por donde pasa el tráfico, y entonces es donde el control debe vivir.
El lado del cliente no es un lugar seguro para esto. Los guardrails a nivel de prompt son frágiles por construcción, porque el modelo puede reformular para rodear una regla, y porque un guardrail que vive en el prompt está a una ventana de contexto de no existir. Los filtros del proveedor no son tu camino de datos, y no puedes hacer responsable a un vendor por el comportamiento de tu agente. El análisis a posteriori, el SIEM que acoplas después, es un registro de lo que pasó, que es útil, y tarde para detener lo que está pasando ahora.
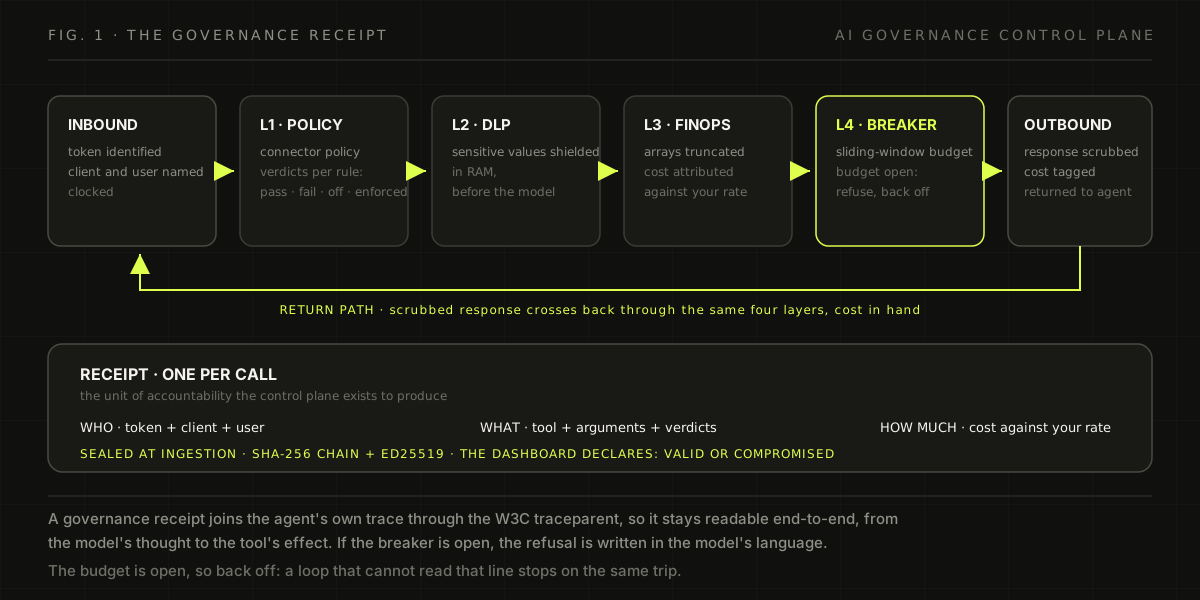
El gateway lo ve todo a la vez: la llamada, la respuesta, el token que autenticó la llamada, el conector al que apuntó, y el reloj. Ese es el único punto del sistema donde "quién, qué y cuánto" tiene respuesta con un solo conjunto de datos, y también el único punto donde una decisión todavía puede cambiar el desenlace. Cada llamada de tu flota cruza el gateway dos veces, ida y vuelta, y esos dos cruces son la gobernanza.
Dos piezas más de la plataforma completan el argumento del gateway. Cada conector corre dentro de su propio isolate sandboxeado, un diseño que escribí en cómo Vinkius ejecuta cada servidor MCP en un isolate V8, de modo que una herramienta hostil o rota solo puede actuar a través de efectos que el host posee. Y desde la versión 5.1.0 de nuestro framework abierto, el contexto de trace distribuida del agente cruza el gateway, de modo que cada span de herramienta se ancla en la trace del llamador. Ese trabajo está en la publicación de MCP Fusion 5.1.0 sobre correlación de trace, y importa aquí porque un comprobante de gobernanza que no se une a la trace del propio agente es un comprobante que nadie puede leer.
Una nota de honestidad antes del tour: en el plan gratuito, el dashboard de Gobernanza de IA abre con datos de ejemplo claramente etiquetados. Exploras la forma del plano de control antes de comprometerte. La ejecución en vivo, el disyuntor y la detención de emergencia corren en planes de pago. Prefiero decirlo en voz alta a dejar que el lector asuma que el gratuito hace lo que es de pago.
Ocho superficies que cuentan qué está pasando
La mitad de reportes de la Gobernanza de IA es donde quiero pasar más tiempo, porque es la parte que las empresas prueban primero, y la parte donde "instrumentamos nuestros agentes" suele resultar ser una frase sobre cuatro dashboards y una oración.
Mission Control
La superficie del tope es la franja de KPIs de toda la flota: llamadas totales, latencia promedio, una figura de confiabilidad que llamamos Vinkius Reliability, tokens totales movidos, la cantidad de valores protegidos por la prevención de pérdida de datos y el costo ahorrado por la guarda de FinOps. Debajo, un mapa de calor de actividad agéntica de 30 días, un gráfico de volumen y latencia de llamadas, y un AI Briefing: un digest generado por un modelo de lenguaje sobre lo que cambió en tu tráfico en el período. Es la única superficie deliberadamente no determinística en un plano de control determinístico, y es una función de pago, porque el briefing es una llamada de modelo. Un detalle en el que insisto: la figura de confiabilidad que ves excluye los propios errores de Vinkius. El número responde "¿cuán confiable es tu flota para ti?", no "¿cuán confiables somos nosotros?". No contamos nuestros errores contra tu tiempo activo.
Agent Activity
La vista por cliente. Cada token de conexión de tu organización aparece con su actividad: qué cliente es, cuándo llamó por última vez, cuántas llamadas hizo. Esta es la superficie que responde "¿qué agente está haciendo qué?". Un agente que debería correr cada hora y está llamando cada 90 segundos aparece acá, y es ahí donde un loop descontrolado suele notarse, antes de convertirse en una factura.
Connector Traffic
La misma descomposición, por conector. Cuál de tus herramientas está caliente, cuál está fría, dónde se concentra la latencia. Cuando un proveedor de afuera degrada, es esa vista la que separa el problema del proveedor del problema de tu flota.
Access Tokens
La flota de tokens como inventario. Estado, último uso, conteo de llamadas. Esta gana su existencia de un modo que sorprende: un token de conexión que no se usa hace 90 días es una credencial permanente que emitiste y olvidaste, y esta superficie existe para hacer ese olvido visible y accionable, con revocación y rotación a un clic.
AI Spend
El costo, hecho legible. Gasto estimado, los ahorros medidos por la guarda de FinOps, costo por llamada, el retorno de las políticas de FinOps, y un libro mayor por conector. La guarda atribuye costo sobre una tarifa por millón de tokens que tú defines, y el valor por defecto es de 3 dólares por millón de tokens. El punto de la superficie no es cobrarte. Es mostrar qué agente, sobre qué conector, está consumiendo qué, porque el gasto de agentes no tiene la forma de ningún costo que hayas grafiado antes. No es por usuario ni por llamada. Es por razonamiento, y se multiplica con cada retry que un loop agrega.
Capability Reliability
Confiabilidad a nivel de herramienta, no de servicio. Cada capacidad que un conector expone tiene su propio comportamiento de latencia y falla, y la Tool Health Matrix las grafica juntas: latencia contra tasa de falla, una burbuja por herramienta. Un conector puede estar perfectamente sano mientras una herramienta específica dentro de él falla en silencio. Esa es la diferencia entre monitorear un producto y monitorear lo que tus agentes realmente tocan.
Security Posture
Dos series de tiempo y un donut. Las series siguen cuánto blindó la capa DLP y cuánto truncó la capa de FinOps, a lo largo del tiempo. El donut es el Compliance Coverage: la fracción de políticas de gobernanza activas en la flota, contadas por categoría, DLP, FinOps y aprobaciones. Es el número que el revisor quiere ver, y se calcula desde el estado de las políticas, no desde un cuestionario que llenas.
Request Failures
La línea de tiempo de errores, dividida en tres bandejas: errores del Agente, donde el llamador mandó algo que la herramienta no pudo honrar, errores del Upstream, donde el tercero detrás del conector falló, y errores de Vinkius, donde fallamos nosotros. Esta es la atribución de fallas de la que el inicio de este post hablaba. Cuando una llamada falla, se te avisa de quién fue la falla, en la misma vista, en el mismo período, sin reunión.
Request Detail: el comprobante
Abre cualquier llamada individual y tienes la unidad de responsabilidad para la cual existe todo el plano de control. El comprobante nombra la identidad que hizo la llamada: el token, el cliente, y el humano o el usuario de aplicación detrás. Lista la política en vigor en ese instante, regla por regla, agrupada por la fase del ciclo de vida de la llamada a la que cada regla pertenece, con el veredicto de cada una: pass, fail, off o enforced. Muestra la entrada de auditoría de la llamada, sellada en la ingesta en el registro encadenado por hash que describo abajo. Muestra la continuidad de trace, el contexto W3C que une esa llamada a la trace distribuida del propio agente. Descompone la latencia en el tiempo que tomó la API de afuera y el tiempo que la capa de gobernanza agregó, entonces siempre sabes cuánto cuesta el propio plano de control. Y termina con acciones: bloquear una capacidad para todos los llamadores, o, en Business, la detención de emergencia del conector. Una llamada, una pantalla, la historia completa.
Cuatro superficies que deciden qué está permitido
Connector Policy
La primera superficie de política es sobre cómo un conector ingresa a tu flota. Los deploys pueden exigir aprobación antes de quedar activos, y el producto ancla esta configuración al principio de cuatro ojos que el AI Act de la UE espera de los sistemas de alto riesgo en el Art. 14(5): una sola persona no decide, por sí sola, que una herramienta nueva con consecuencias reales llegue a los agentes. La misma superficie controla cómo las capacidades se exponen al modelo, planas o agrupadas, con un agrupamiento automático cuando la lista de herramientas del conector crece, porque lo que el modelo ve es superficie, y la superficie es una decisión de diseño.
Y está la zona de peligro, que prefiero que entiendas antes de descubrirla. El Global Emergency Halt detiene todos los conectores activos de tu organización. Los desactiva a todos, revoca todos los tokens, y termina todas las sesiones abiertas, en una sola acción síncrona, y la confirmación exige teclear HALT ALL, porque este es el botón que presionas cuando algo salió muy mal y prefieres la flota entera muerta a equivocada. Después del halt puedes restaurar, pero los tokens revocados siguen revocados. Los reemites con intención. Esa es una decisión de diseño que quiero dejar explícita: la recuperación es una relación de confianza nueva, no un replay de la vieja.
DLP Protection
Prevención de pérdida de datos, diseñada para el camino del modelo. Nombras patrones para campos sensibles, un correo en cualquier lugar del árbol de respuesta, un número de tarjeta, un campo en una ruta específica que decides proteger, y el runtime los aplica en el camino de salida, enmascarando el valor antes de que la respuesta llegue al agente. El blindaje pasa en memoria, en el camino entre el servicio de afuera y el modelo, que es la diferencia entre datos que fueron enmascarados y datos que nunca estuvieron en el contexto del modelo. El KPI que ves en Mission Control, DLP Protected, cuenta los enmascaramientos por período, entonces la capa no solo existe, se mide.
FinOps Guard
Guardrails de costo, por las razones de la sección de AI Spend. La guarda hace tres cosas. Trunca arrays más allá de un número máximo de ítems, porque una respuesta que devuelve diez mil registros es una factura de tokens, no una respuesta. Comprime las descripciones de herramientas que el modelo lee antes de actuar, la configuración de Toon compression del dashboard. Y atribuye costo sobre la tarifa que defines, para que la guarda te cuente, por período, cuánto ahorró, en bytes y en dólares, contra la tarifa. La salida no es una factura. Es la medida del hueco entre lo que la herramienta devolvió y lo que el agente necesitaba, que es el número que decide si tu agente puede seguir llamando a esa herramienta.
Circuit Breaker
Un presupuesto de llamadas en ventana deslizante por conector, con un valor por defecto de 5.000 llamadas cada 5 minutos y un enfriamiento de 15 minutos, números que ajustas. Cuando el presupuesto de un conector se excede, el disyuntor salta, y el salto hace lo que la mayoría de los guardrails nunca hace: le avisa al agente, en una negación legible por máquina escrita para un modelo, que el recurso está abierto y que debe retroceder. Un buen agente lo respeta. Un loop que no lee la negación es detenido por el mismo salto, que es el punto. El estado del disyuntor es compartido entre las instancias del gateway, entonces un presupuesto es un presupuesto, no un límite por proceso que se resetea cuando el tráfico cambia de instancia. Después del enfriamiento se reinicia solo, o apruebas la reanudación desde el dashboard. El disyuntor es lo que impide que un agente descontrolado lleve consigo la API de un tercero, y tu propia factura.
Los cimientos: tokens con alcance, bóveda sellada, registro encadenado
Las doce superficies se asientan en cimientos, y es en los cimientos donde mucha "gobernanza" resulta fina.
La capa de identidad es el token de conexión. Cada conector tiene sus propios tokens, generados por organización, mostrados una sola vez, firmados, y con alcance solo para ese conector. El token del conector de correo no toca el conector de pagos. Cada comprobante nombra el token que hizo la llamada, entonces la identidad no es teoría, es una columna de los datos de auditoría.
La capa de secretos es la bóveda. Las credenciales de los conectores están cifradas en reposo con AES-256, y la garantía que hacemos es que ni siquiera los operadores de la plataforma pueden leerlas en reposo. Se inyectan solo en runtime, en el isolate donde corre el código de la herramienta, y el agente nunca ve el secreto. Esa separación es la que más me preocupa al diseñar: lo que decide, el modelo, y lo que prueba la autoridad, la credencial, nunca deben compartir contexto. Un modelo que puede leer tu contraseña de afuera no es un problema de gobernanza que la auditoría resuelva. Es el problema.
La capa de auditoría es el registro. Cada hash de llamada se sella en la ingesta, y el registro está encadenado por hash: cada registro lleva el hash anterior y su posición en la secuencia, y la cadena está firmada, SHA-256 con Ed25519, entonces una manipulación no es un problema de privacidad, es un evento detectable, y el dashboard dice si la cadena es válida o comprometida. La auditoría de deploy está estructurada sobre el Art. 73 del GDPR, el derecho de acceso del titular de datos, entonces cuando un regulador o un cliente pide el historial completo de un conector, la respuesta es una sola cadena exportable y verificable, no un proyecto.
Y una capa más, de la que estoy más orgulloso. Algunos conectores de nuestro marketplace son cebos vigilados. Parecen herramientas reales. No lo son, y están vigilados. Cuando un cebo es tocado, la plataforma aísla la herramienta, revoca el token, mata las conexiones abiertas y congela el camino de pago, automáticamente. Si una herramienta se vuelve hostil, o un token se filtra, la contención no espera a que te des cuenta.
Por debajo de todo, la capa de organización: single sign-on, roles y equipos a la medida, cuentas de servicio para las identidades no humanas que corren en CI y workloads OIDC, claves de API de organización, y un log de auditoría de seguridad para las acciones sobre la propia organización. El plano de control se asienta sobre un modelo de identidad que conoce la diferencia entre una persona y una máquina, que es una diferencia sobre la que cada una de las doce superficies confía.
Qué cambia la gobernanza para los propios agentes
Casi toda la conversación sobre gobernanza de agentes trata al agente como riesgo a contener, y no voy a fingir lo contrario, porque lo es. Pero la otra mitad del argumento es la que yo pondría en el deck de ventas, y la que creo que define la década: la gobernanza es lo que convierte al agente de demo en empleado.
La confianza se otorga en proporción a la evidencia. Un operador le va a dar el turno de la noche, la query de producción, la conciliación de pagos a un agente, exactamente en proporción a que cada acción que tomó puede ser atribuida, presupuestada, blindada y verificada después. El comprobante no es una carga sobre el agente. Es la credencial que le da la sala más grande.
El envoltorio de un agente gobernado es conocido. Una política determinística alrededor de un modelo no determinístico es la única forma sana para producción: el modelo planea dentro de una caja, y la caja es estable. La negación del disyuntor está escrita en el idioma del modelo, entonces el agente aprende el presupuesto, y lo respeta, en lugar de descubrirlo en forma de factura. La truncación de la guarda de FinOps hace que el modelo reciba una respuesta de tamaño, en vez de un bloque de 200 kilobytes, que es un problema de inteligencia, no solo de costo.
Y el agente mismo gana la capacidad que ningún sistema autónomo tuvo en la práctica: mostrar su trabajo. Para un agente que va a operar en flujos regulados, la traza de auditoría no es overhead, es el producto. El agente gobernado es el único tipo de agente al que se le puede dar autoridad real, y el agente sin gobernanza es, para siempre, una demo.
Observabilidad que finalmente habla el idioma de los agentes
Si tu equipo ya corre Datadog o Grafana, la forma de las superficies de Gobernanza de IA va a resultarte familiar, y es intencional. Franjas de KPIs, mapas de calor, desgloses, comprobantes por llamada. Lo que no es familiar es lo que el tráfico de agentes le hace al modelo para el cual esas herramientas fueron construidas.
Datadog mide un mundo donde los llamadores son sistemas que alguien escribió. La carga tiene una forma fija, el costo escala con usuarios o llamadas, y una falla tiene un responsable. El tráfico de agentes rompe las tres suposiciones a la vez. El llamador es probabilístico. La carga tiene la forma del razonamiento, y un loop de retry la multiplica. Y una falla tiene tres responsables candidatos, agente, upstream, plataforma, por eso la línea de tiempo de fallas se divide en tres bandejas en vez de una.
Entonces el plano de control para agentes es observabilidad con capa de ejecución, y la capa de ejecución es la propiedad que los sistemas agénticos necesitan y que las plataformas construidas para el mundo hecho por humanos no tienen. Cada llamada de herramienta es atribuida a una identidad, el costo es atribuido en granularidad de token, las fallas son atribuidas a un lado responsable, y la capa de política actúa en vuelo, antes de que la llamada salga del gateway. Esa es la elevación que quería en este post: tomar la disciplina de instrumentación de las plataformas en las que ya confías, y sumar las dos propiedades que los sistemas agénticos exigen, atribución por llamada y ejecución en vuelo. El resultado no es una nueva categoría de herramienta. Es la misma categoría, en la resolución que los sistemas agénticos exigen.
Preguntas frecuentes
¿La gobernanza de IA es RBAC con pasos extra?
No, y la diferencia es la unidad de decisión. El RBAC decide qué humano, con qué rol, alcanza un sistema. Es una puerta sobre la identidad, evaluada una vez. La gobernanza de IA decide qué puede hacer una acción, tomada por un principal no determinístico a través de una herramienta específica, en cada llamada, bajo un presupuesto, con la respuesta registrada. Una es una puerta. La otra es el tribunal del tránsito donde cada acción de tus agentes es juzgada.
¿Vinkius lee los prompts de mis agentes?
No. El gateway ve la llamada de herramienta: el nombre de la herramienta, los argumentos que mandó, la respuesta que recibió, la identidad detrás, y el reloj. Las cuatro superficies de política son capas determinísticas de regla y presupuesto, no un juez de lenguaje. Si quieres que un modelo inspeccione al modelo, eso es otro producto, y yo no llamaría eso gobernanza, lo llamaría segunda opinión.
¿Qué pasa cuando salta el disyuntor?
El tráfico del conector es negado con un aviso legible por máquina que le dice al agente que el presupuesto está abierto y que debe retroceder, por un período de enfriamiento. Después del enfriamiento el disyuntor se reinicia solo, o un operador aprueba la reanudación desde el dashboard. El estado es compartido entre las instancias del gateway, entonces el presupuesto se mantiene sin importar qué instancia sirve la llamada. La capa de sesiones que mantiene el enjambre bajo control es el tema de la publicación sobre sesiones de SwarmGateway.
¿Puedo exportar y verificar la cadena de auditoría?
Sí. La auditoría de deploy se exporta como documento, y la cadena es verificable de punta a punta: cada registro lleva el hash anterior y su posición, la cadena está firmada, y el dashboard declara si es válida o comprometida. Está estructurada sobre el Art. 73 del GDPR, entonces una solicitud de acceso del titular de datos mapea a un solo artefacto.
¿Qué recibo en el plan gratuito?
El dashboard completo, con datos de ejemplo claramente etiquetados, para que aprendas la forma del plano de control. La ejecución en vivo, el disyuntor y la detención de emergencia están en planes de pago, y el AI Briefing es una función de pago. Prefiero ser el vendor que lo dice en un post que el que te deja descubrirlo en la página de precios.
El plano de control es el producto
El hueco entre la demo de agente y el agente que dejarías actuar mientras duermes no es el modelo. Es el plano de control. Doce superficies, ocho que cuentan y cuatro que deciden, sobre tokens con alcance, una bóveda sellada, un registro encadenado, y una capa de cebo que contiene el daño antes que tú. Cada llamada gana un comprobante, y el comprobante responde quién, qué y cuánto, en el orden que un regulador, un equipo de finanzas o un aviso a las 3 de la mañana lo preguntaría.
Si tus agentes ya actúan sobre tus sistemas, la pregunta ya no es si puedes pagar gobernanza. Es si puedes pagar el día en que descubras que no la tenías.
Para una explicación más profunda de cómo Vinkius construyó el runtime que hace posible esta gobernanza para agentes de IA, ver Los agentes de IA son los nuevos consumidores.
Las doce superficies de gobernança definidas aquí se aplican con código fuente y números de línea en Preguntas de IA Empresarial.