
Publié 23 sept. 20269 min de lecture
Le SDK AI Connect : donnez à vos agents IA les connecteurs de chaque utilisateur comme outils, une ligne par framework
L'impôt d'intégration des produits IA, c'est le câblage, pas le modèle. Le SDK AI Connect de Vinkius le supprime : un client TypeScript à zéro dépendance, des handles bornés par utilisateur et neuf adaptateurs de framework. Voici comment ça marche, le code minimal et un assistant multi utilisateurs fonctionnel, prêt à livrer.

Par Renato Marinho
Founder · Vinkius
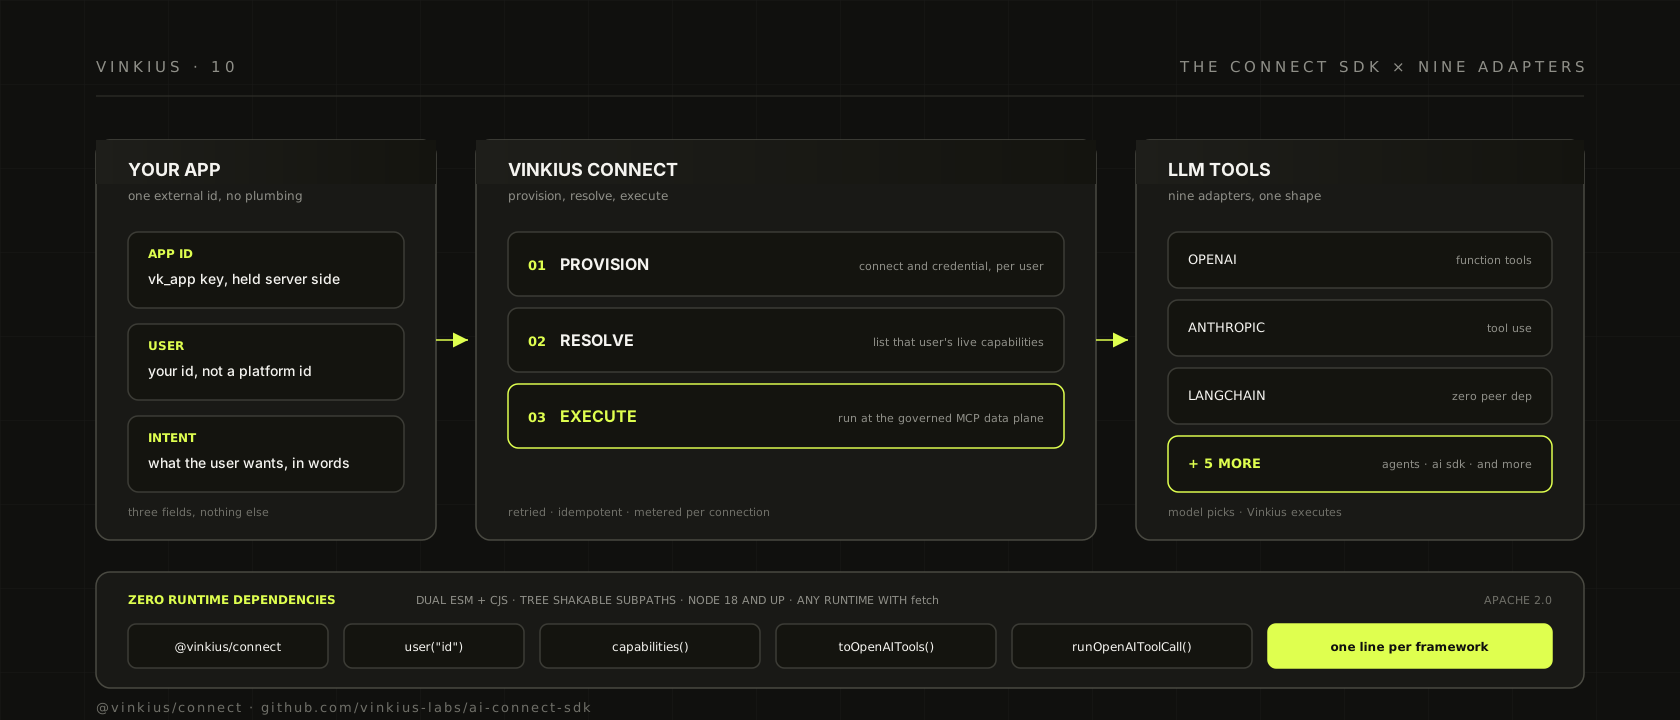
La question qu'on me pose le plus souvent sur un produit de IA ne porte jamais sur le modèle. Elle porte sur le câblage. Comment votre assistant lit le GitHub de l'utilisateur ? Poste dans son Slack ? Saisit un enregistrement de son CRM ? Dans la plupart des produits, la réponse, c'est qu'une équipe a passé des mois à construire et entretenir une étagère d'intégrations : les poignées de main OAuth, la rotation des jetons, les formes d'erreurs de chaque fournisseur, les réessais, la dérive silencieuse de schéma au moment où une API en amont change. Rien de tout cela ne rend le produit plus intelligent. Ça se place entre le modèle et la chose que l'utilisateur voulait vraiment, et ça continue de réclamer du budget.
C'est cet impôt que l'AI Connect SDK de Vinkius supprime. C'est la partie de Vinkius dont je parle le moins en calls de ventes et le plus avec les ingénieurs, parce que c'est là que vit le point d'appui réel : un petit client TypeScript qui transforme les services connectés d'un utilisateur en outils que votre modèle peut appeler, sans que votre équipe détienne le moindre identifiant de l'amont.
Le SDK en une phrase
@vinkius/connect est un client TypeScript à zéro dépendance d'exécution pour la plateforme de connectivité Vinkius. Votre application est identifiée par une paire de clés que vous créez une fois dans le tableau de bord Vinkius : un identifiant d'application public et une clé d'application secrète. Vous adressez ensuite vos propres utilisateurs finaux par l'identifiant que vous leur donnez déjà dans votre système, et pour chacun d'entre eux, le SDK vous remet une poignée bornée vers les connecteurs qu'ils ont reliés. Vinkius provisionne la connexion, garde les identifiants et exécute les capacités derrière un plan de données gouverné. Votre code ne porte aucune clé API de l'amont, aucun flux OAuth, aucune boucle de réessai pour une API d'un tiers. Vous décrivez le travail dans le propre dialecte d'outils de votre modèle, et un adaptateur le route vers le bon connecteur pour cet utilisateur.
Cette phrase est toute la proposition de valeur. Le reste de ce post est la preuve.
Le modèle : une application, beaucoup d'utilisateurs, borné par utilisateur
La décision de conception que je défendrai le plus fort, c'est que l'unité de bornage est l'utilisateur, pas le locataire. Un assistant de chat qui peut agir sur l'agenda de quelqu'un n'est sûr que si l'agenda qu'il peut toucher est celui que cette personne a relié, et rien d'autre. Le SDK encode cela directement : vinkius.user("yourUserId") construit une poignée paresseuse qui ne fait zéro appel réseau et ne résout ni ne conserve jamais un identifiant interne d'utilisateur. Il adresse la plateforme par votre identifiant externe, jusqu'au bout de l'exécution.
Chaque connecteur d'un utilisateur est une connexion isolée avec son propre jeton. Lister et exécuter les capacités se passe au runtime de cette connexion, alors le GitHub relié par un utilisateur ne peut jamais atteindre celui d'un autre. Chaque connexion est mesurée et peut être coupée indépendamment, et un jeton révoqué échoue fermé au lieu de se réémettre en silence. Quand un utilisateur délie un service, la capacité disparaît du jeu d'outils de cet utilisateur au moment où la prochaine requête liste. L'isolement n'est pas une promesse dans les docs. C'est la forme du chemin de données.
Le code, en trois mouvements
Voici le flux de connexion et d'identifiants, pris dans les propres exemples du SDK. Vous reliez le connecteur GitHub d'un utilisateur, lisez le schéma qu'il attend, écrivez le jeton, et vérifiez la disponibilité :
import { Vinkius } from '@vinkius/connect';

const vinkius = new Vinkius({
  appId: process.env.VINKIUS_APP_ID!,
  apiKey: process.env.VINKIUS_APP_KEY!,
});

async function connectGithub(userId: string, githubToken: string) {
  const github = vinkius.user(userId).connector('github');

  await github.connect();
  const schema = await github.credentials.schema();
  await github.credentials.set({ GITHUB_TOKEN: githubToken });

  const status = await github.status();
  console.log(`github status=${status} requires=${Object.keys(schema).join(',')}`);
}
status revient sous l'une de quatre valeurs : not_connected, needs_credentials, ready ou disabled. Les identifiants sont en écriture seule. credentials.schema() et credentials.status() disent quelles clés existent et quelles sont configurées, jamais les valeurs, et le seul chemin qu'un secret prend est vers l'intérieur, une fois, dans le coffre.
Le deuxième mouvement est l'agrégation. Un appel rend les capacités exécutables sur l'ensemble des connecteurs prêts de l'utilisateur, déjà éponymées pour que deux connecteurs qui livrent un outil create ne collisionnent pas :
const caps = await vinkius.user('alice_123').capabilities();
// caps is a CapabilitySet: an array of executable Capability objects
Le troisième mouvement est l'adaptateur. C'est la ligne qui paie pour la plateforme, parce que c'est la même forme de code quel que soit le modèle que vous exécutez :
import { toOpenAITools, runOpenAIToolCall } from '@vinkius/connect/openai';

const tools = toOpenAITools(caps);
// pass tools to your model, then dispatch each call back:
const result = await runOpenAIToolCall(caps, call, { idempotencyKey: `alice_123:${call.id}` });
Changez de modèle, changez l'import. Il y a neuf sous-chemins d'adaptateurs pour les grands frameworks de modèle, des SDKs d'OpenAI et d'Anthropic à LangChain, LlamaIndex, le Vercel AI SDK, OpenAI Agents et Cloudflare Workers AI, plus un dispatcheur JSON Schema neutre de framework pour le reste. Chacun est un convertisseur de type structurel à zéro dépendance. Il convertit les capacités reliées dans le dialecte d'outils de votre modèle, et inverse, et n'importe délibérément pas le SDK du fournisseur, de sorte que brancher Vinkius sur votre projet n'entraîne rien qu'il n'utilise déjà.
Un assistant multi utilisateurs qui marche
Voici l'implémentation que je livrerais. C'est un handler de chat qui répond pour un utilisateur en utilisant les connecteurs de cet utilisateur, avec la boucle d'outils complète : le modèle demande un outil, on l'exécute au runtime gouverné, on rend le résultat, et on borne la boucle pour qu'un modèle capricieux ne vous facture pas à l'infini.
import OpenAI from 'openai';
import { Vinkius } from '@vinkius/connect';
import { toOpenAITools, runOpenAIToolCall } from '@vinkius/connect/openai';

const openai = new OpenAI();
const vinkius = new Vinkius({
  appId: process.env.VINKIUS_APP_ID!,
  apiKey: process.env.VINKIUS_APP_KEY!,
});

// Any model your chosen provider serves. The integration is model agnostic:
// nothing below depends on a specific model name.
const MODEL = process.env.OPENAI_MODEL ?? 'your-model-id';

export async function assistantFor(userId: string, question: string) {
  // 1. What can this user's connectors actually do, right now?
  const caps = await vinkius.user(userId).capabilities();
  if (caps.length === 0) {
    return 'You have not connected a service yet. Connect one in the app and I can act on it.';
  }

  // 2. Hand the model this user's capabilities as its own tools.
  const messages = [{ role: 'user', content: question }];
  const tools = toOpenAITools(caps);

  // 3. The tool loop. The model picks, we execute at the runtime, we feed the result back.
  let reply;
  for (let step = 0; step < 4; step++) {
    reply = await openai.chat.completions.create({
      model: MODEL,
      messages,
      tools,
    });

    const msg = reply.choices[0]?.message;
    if (!msg || !msg.tool_calls || msg.tool_calls.length === 0) break;

    messages.push(msg);
    for (const call of msg.tool_calls) {
      // Tool level failures come back as isError results, not throws.
      // Transport level failures throw the SDK's typed error classes.
      const result = await runOpenAIToolCall(caps, call, {
        idempotencyKey: `${userId}:${call.id}`,
      });
      const text = result.content.map((c) => c.text).join('\n');
      messages.push({
        role: 'tool',
        tool_call_id: call.id,
        content: result.isError ? `The tool reported an error: ${text}` : text,
      });
    }
  }

  return reply?.choices[0]?.message?.content ?? '';
}
Quatre choses dans ce bloc méritent d'être pointées, parce que c'est là qu'une version naïve va se tromper en silence.
Première, la liste des capacités est cherchée par requête, par utilisateur, et seulement sur les connecteurs prêts. Un utilisateur qui relie un nouveau service l'obtient au tour suivant, sans déploiement, et un utilisateur qui révoque en perd les outils correspondants au même instant. Rien n'est mis en cache de façon à survivre à la relation de confiance.
Deuxième, l'idempotencyKey de l'appel d'exécution est ce qui rend le réessai sûr. Le SDK réessaye les réponses transitoires, mais un POST qui provoque un effet de bord n'est réessayé que si vous déclarez la clé, parce qu'alors le rejeu est dédupliqué côté serveur au lieu d'être doublé. La clé ci dessus est éponymée par utilisateur et par identifiant d'appel d'outil, alors deux utilisateurs agissant sur le même connecteur ne collident jamais.
Troisième, le plafond de la boucle. Un agent qui lit le résultat d'un outil, juge que ce n'est pas assez, et appelle l'outil suivant, c'est ainsi que le produit fait un travail utile. C'est aussi ainsi qu'un modèle perdu peut marcher très longtemps. Borne les étapes, borne la facture et le rayon de dégâts, et la réponse en texte brut du modèle au dernier tour est ce que vous rendez.
Quatrième, la séparation des erreurs. Une capacité qui échoue au niveau de l'outil (l'API qu'elle enveloppe a renvoyé une erreur) revient comme un résultat avec isError: true. Le modèle le lit, et peut se raccrocher, réessayer un autre outil, ou expliquer l'échec à l'utilisateur. Une défaillance de transport ou d'authentification lève l'une des classes d'erreurs typées du SDK. Deux formes d'échec, deux gestionnaires distincts, et ni l'un ni l'autre ne fait tomber toute la boucle.
Exécutez sur un autre framework et seule la ligne d'adaptateur change. Pour Anthropic, c'est toAnthropicTools et runAnthropicToolUse. Pour LangChain, vous injectez la fabrique d'outils du framework de sorte que le SDK ne livre aucune dépendance associée. Le côté capacité est identique.
Pourquoi c'est construit ainsi
Je reviens sans cesse à une règle que j'impose à l'équipe : le SDK ne doit pas faire porter à votre application un secret qu'elle ne peut ni voir ni révoquer. Toute la forme en découle. Les identifiants sont en écriture seule et chiffrés au repos, et la plateforme ne laisse pas même ses propres opérateurs les lire. Les jetons de connexion sont bornés à un connecteur unique, authentifiés par HMAC, et le texte brut n'est jamais stocké, alors le pire cas d'une fuite est un actif nommé, révocable, rattaché à un seul connecteur, pas un laissez-passer permanent sur tout le patrimoine. Les réessais sont plafonnés et à gigue, et un délai par requête fait courir la lecture du corps contre le même échéance pour qu'un flux bloqué ne fige pas un worker. Le même objet de transport pilote le plan de contrôle et le plan de données, et c'est pourquoi les sémantiques de réessai, de délai et de rédaction ne peuvent jamais diverger entre les deux.
Le seul endroit où je n'adoucis pas les termes : gardez les clés d'application côté serveur. C'est un client de backend. L'identifiant public d'application et la clé secrète appartiennent à votre environnement, pas à un bundle, et le design suppose que le bornage d'utilisateur que vous passez est quelque chose que votre serveur peut prouver être l'appelant. Si vous êtes tenté de l'embarquer dans le navigateur pour économiser un aller-retour, vous avez déplacé le problème du travail d'intégration au pilotage des secrets, qui est une affaire pire.
Ce que ça livre
npm install @vinkius/connect. C'est ESM et CJS avec des types complets, élagage des branches, et ça tourne sur Node 18 et au dessus et sur tout runtime qui a fetch. Aucune dépendance d'exécution à auditer, aucun gonflement du fichier de verrouillage, aucune chaîne d'approvisionnement transitive à discuter avec l'équipe de sécurité. La licence est Apache 2.0, alors le code est à vous de garder et de faire tourner où que soit votre application.
La couche de capacités qu'il pilote est couverte dans l'article sur la couche de capacités et le catalogue, et les garanties d'exécution sur lesquelles il s'appuie sont dans l'article sur le fait de faire tourner des serveurs MCP non fiables dans des isolates V8. Cet article est la surface développeur des deux : le client contre lequel votre équipe écrit.
Livrez la fonction, pas le projet d'intégration. C'est tout l'enjeu, et c'est pourquoi le SDK a un seul travail : remettre à votre modèle les outils que votre utilisateur a reliés, dans le dialecte que votre modèle parle déjà, et sortir du chemin.