
Publié 21 sept. 202619 min de lecture
Zéro cold start pour du code non fiable : comment Vinkius fait tourner les serveurs MCP dans des isolates V8
Pourquoi les isolates V8 battent les conteneurs pour du code edge multi-tenant : restauration de snapshot en ~15 ms, plafond dur de 128 MB par tenant, fetch verrouillé contre le SSRF, et un modèle d'intégrité du snapshot en quatre couches, où une entrée corrompue est un cache miss, pas un crash, au cœur du runtime Vinkius.

Par Renato Marinho
Founder · Vinkius
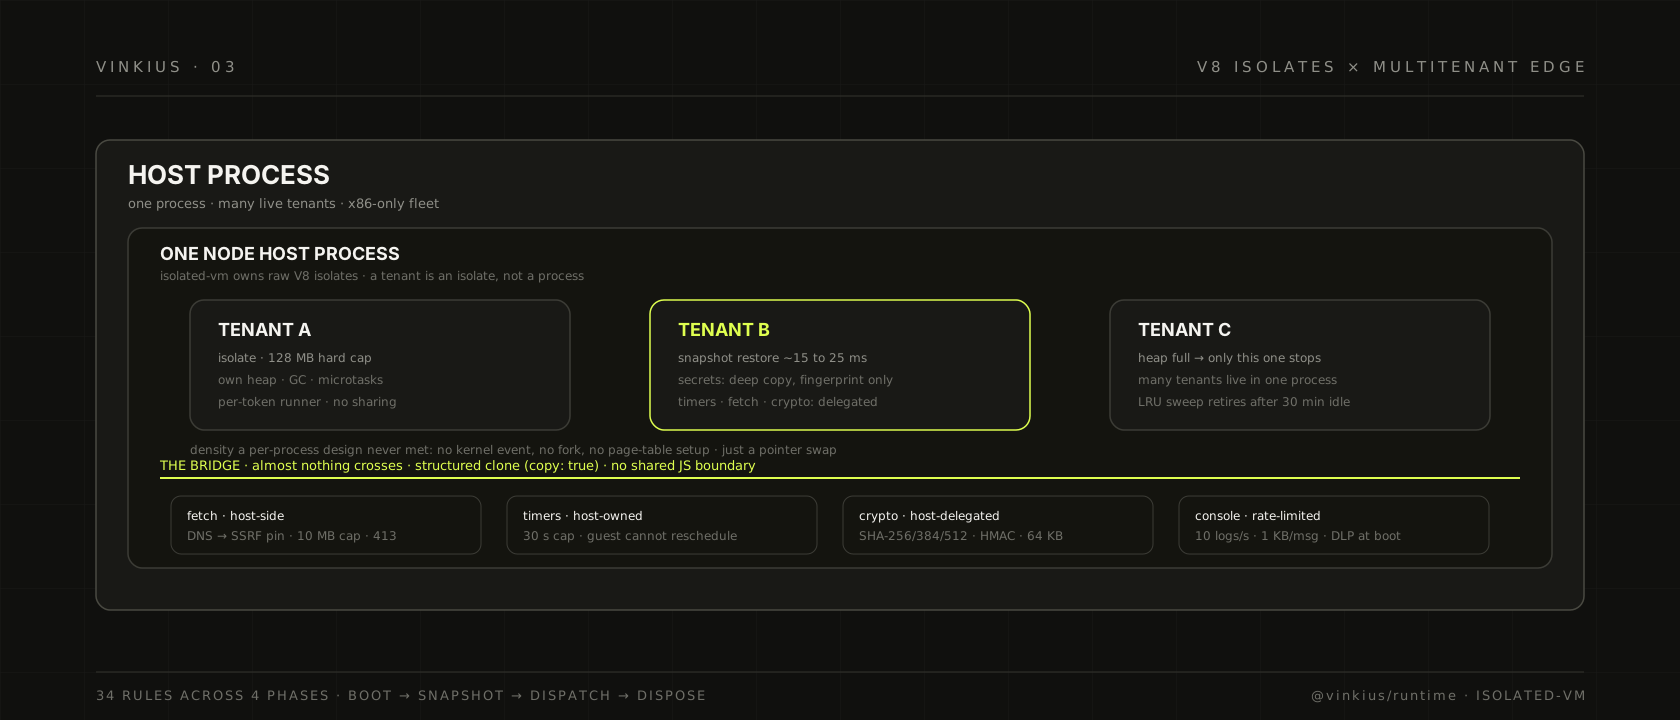
Chaque serveur MCP qu'un client déploie sur Vinkius Cloud est, tôt ou tard, du code tiers qui s'exécute sur notre infrastructure. Pas le nôtre. Pas une bibliothèque que nous contrôlons. Le sien. Un cloud pour agents IA n'est utile que si les clients peuvent apporter leur propre logique, leurs propres connecteurs, leur propre colle entre un LLM et leurs systèmes. Dès que cette capacité existe, la question qu'aucun deck produit ne répond devient tout le problème d'ingénierie : comment faire tourner du JavaScript non fiable pour des milliers de tenants sur une poignée de serveurs, sans offrir à aucun d'eux un chemin pour nuire aux autres, à la machine ou à leurs voisins ?
C'est la question derrière la couche d'isolates V8 du runtime Vinkius, et la partie de l'architecture dont je parle le moins en public, voilà pourquoi je l'écris ici. Ce qui suit décrit comment le système fonctionne aujourd'hui. Les chiffres sont ceux que le code impose, pas ceux que j'aurais souhaités.
Pourquoi pas un conteneur par serveur
La première réponse que toute plateforme multi-tenant saisit est le conteneur par serveur. C'est propre, c'est compris, et ça donne une vraie isolation au niveau du noyau. J'ai passé un temps sérieux de conception sur exactement ça.
Elle est morte sur la densité. Les clients de Vinkius Cloud branchent leurs serveurs MCP comme ils branchent des intégrations sur n'importe quel SaaS : des dizaines par workspace, bon marché à créer, bon marché à supprimer, la plupart inactifs des jours durant. Un processus Node.js qui a démarré un vrai runtime (framework, SDK, polyfills, pool de connexions) porte un coût fixe de dizaines de méga-octets avant de produire le moindre travail utile. Multipliez par quelques centaines de serveurs sur une même tâche, et vous luttez contre le plafond mémoire de la tâche avant même qu'un appel d'outil ne se soit produit. Multipliez par les cold starts, et vous avez construit une plateforme où démarrer son propre serveur prend des centaines de millisecondes.
La deuxième réponse, évidente elle aussi, est plusieurs processus dans un seul conteneur, un fork par tenant. C'est pire. On échange la frontière du noyau contre rien : chaque processus a toujours sa heap, ses tables de pages, son collecteur de garbage, et un crash dans un processus peut toujours emporter ses voisins par des descripteurs de fichiers partagés et le processus d'init. On a dépensé la même mémoire que la réponse conteneur, pour un mode de défaillance pire.
J'ai aussi fait le calcul sur le terrain intermédiaire : un processus Node par workspace, partagé entre les serveurs d'un tenant. Il bute sur les mêmes deux murs. L'empreinte fixe d'un runtime Node démarré est un coût par tenant, qu'on la partage ou non, et une fuite mémoire ou un fork bomb d'un workspace emporte avec lui tous les serveurs de ce workspace. Le rayon d'explosion ne se localise pas.
Ce que Cloudflare a démontré avec Workers, c'est la troisième option : ni un processus par tenant, ni un conteneur par tenant, mais un isolate. V8 a été conçu pour faire tourner de nombreux programmes non fiables dans un seul processus de navigateur, ce qui est exactement la forme de notre problème, car un onglet de navigateur est un tenant. Le runtime Workers s'appuie sur le même primitif : un isolate par requête, restauré depuis un snapshot V8, si bien que le cold start dont se plaignent les gens n'est en fait qu'une restauration de heap. Je n'ai pas adopté leur plateforme. Je ne peux pas : notre gateway est long-lived et stateful dans des dimensions qu'une fonction de page ne l'est pas, et nous hébergeons notre propre flotte sur AWS, où je contrôle le rythme des montées de version. J'ai adopté l'idée, et j'en ai construit la partie hôte sur Node.js avec isolated-vm, le binding C++ qui permet à un processus Node de posséder un isolate V8 brut.
Cette décision (un tenant est un isolate, pas un processus) est à l'origine du reste du runtime. Ce qui suit en découle.
Ce que l'isolate fournit réellement
Un isolate est une heap : une région de mémoire collectée, avec sa propre file de microtâches, ses propres globaux, et un plafond dur fixé à la création. L'isolate que isolated-vm crée pour un tenant reçoit 128 MB. Ce n'est pas un quota souple que nous appliquons dans le code applicatif en loggant un avertissement ; c'est un memoryLimit remis au moteur. Quand la heap d'un tenant l'atteint, l'isolate de ce tenant cesse d'être servi. Les autres tenants continuent de tourner. Le globalThis d'un tenant n'est accessible depuis l'isolate d'aucun autre, car il n'existe aucune frontière JavaScript partagée, tout court. Le seul trafic qui traverse la frontière est ce que nous faisons explicitement passer, et nous en faisons passer très peu.
Le coût de planification compte plus que les gens ne le croient. Spawner un processus est un événement du noyau ; un fork exige la mise en place des tables de pages, un exec, et un échauffement du collecteur. Basculer entre des isolates dans un même processus est un échange de pointeur. C'est pour cela que Cloudflare peut coller le mot zero à côté de ses cold starts, et pour cela que le plancher de latence de nos serveurs déployés en edge se mesure en millisecondes, pas dans la fourchette de 200 à 400 ms où tombe en général un démarrage Node neuf.
La couche de cycle de vie énonce la propriété d'isolation plus directement que je ne saurais le faire : un runner par token de connexion, aucun partage entre tokens. L'isolation des identifiants est absolue. Le runner qui possède une connexion possède son isolate, son snapshot de secrets et ses timers, et rien dans le graphe de processus ne franchit cette limite.
Le prix, c'est qu'un isolate est un environnement vide. V8 ne livre pas de bibliothèque standard. Il n'y a ni fetch, ni TextEncoder, ni console, ni setTimeout, ni process, ni Buffer. Le premier vrai travail du runtime n'est donc pas d'exécuter du code tenant. C'est de construire l'environnement dans lequel ce code tournera.
L'environnement vide
Démarrer un isolate tenant commence par ce que nous appelons la couche de survie : un bundle concaténé unique de polyfills qui restaure la surface d'API Web et Node que le code tenant attend. L'ordre de chargement est délibéré, car chaque couche dépend de celle en dessous. D'abord les shims console et process, puisque les polyfills qui les surmontent loggent et inspectent process. Puis TextEncoder et TextDecoder avec UTF-8 et prise en charge des paires de surrogats, car un emoji dans un argument d'outil n'est pas un cas limite. Puis URL et un URLSearchParams complet à 12 méthodes (l'entrée du changelog dit « axios, got et @octokit fonctionnent désormais correctement dans les bundles edge », et c'était tout l'enjeu). Puis la crypto, les timers, et la pile réseau : Headers, fetch, et un shim XMLHttpRequest asynchrone uniquement, pour que les vieilles bibliothèques HTTP que les gens collent dans leurs connecteurs ne meurent pas de xhr is not defined.
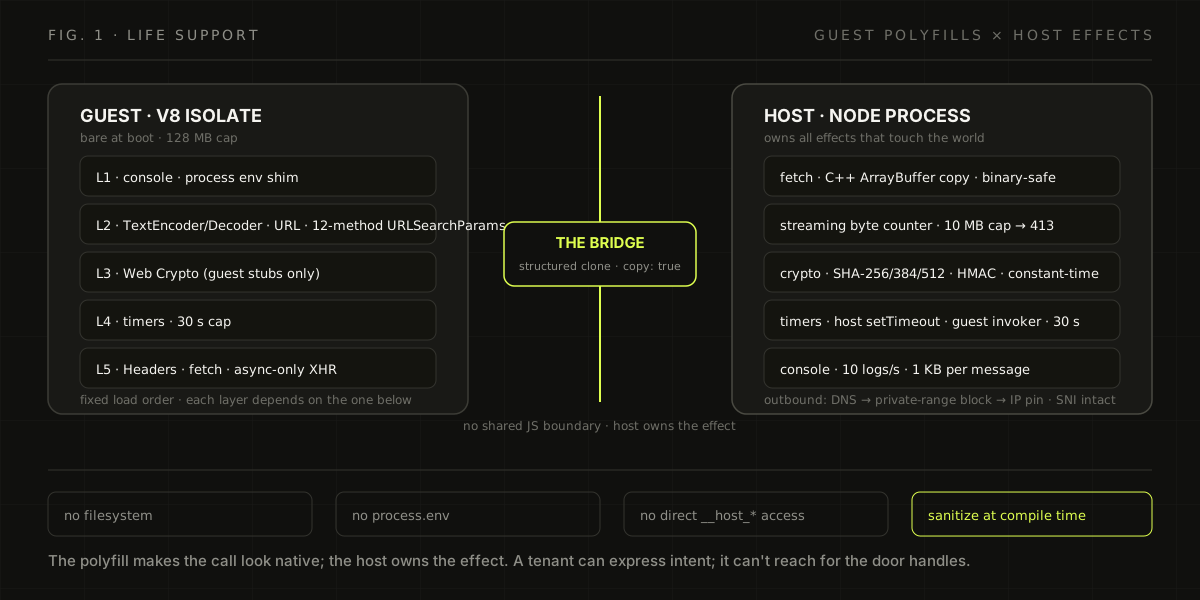
L'essentiel, c'est ce qui est réel et ce qui est délégué. Rien qui touche le monde extérieur n'existe à l'intérieur de l'isolate. Le fetch d'un bundle tenant est un polyfill côté guest, mais la requête elle-même se passe côté hôte, par __host_fetch, en une copie C++ d'ArrayBuffer à travers la frontière : sûre pour le binaire, pour qu'une image ou une réponse gzip ne se transforme pas en UTF-8 illisible. crypto.getRandomValues est le randomBytes côté hôte, plafonné à 64 Ko. crypto.subtle.digest et HMAC, ce que la vérification de JWT demande, sont côté hôte eux aussi, et l'hôte vérifie les signatures par une comparaison à temps constant. Les timers sont des appels setTimeout côté hôte qui rappellent vers le guest par un invoker enregistré, plafonnés à 30 s. La règle derrière tout ça : le polyfill rend l'appel apparemment natif, et l'hôte possède l'effet. Un tenant peut exprimer une intention. Il ne peut pas atteindre le système d'exploitation.
Les arguments et les résultats traversent la frontière par clonage structuré (copy: true dans l'API isolated-vm), pas par JSON.stringify. On paie la sérialisation une fois, en C++, et on conserve de vrais ArrayBuffer et des objets typés des deux côtés. On ne le voit pas tant qu'on ne profile un appel d'outil qui transporte un payload de 1 MB : l'aller-retour JSON était la deuxième partie la plus coûteuse, après le réseau.
Côté compilation, le code tenant n'atteint jamais le runtime en source. La pipeline de bundle prend la spécification du serveur, génère le point d'entrée et la passe à esbuild (IIFE, plateforme browser, cible ES2022, minifiée), si bien que ce qui arrive dans l'isolate est un fichier plat unique, sans imports dynamiques. Un sanitizeur d'analyse statique rejette les issues de secours avant que le bundle ne soit accepté : accès direct aux ponts __host_*, accès furtifs en notation crochet sur globalThis[...], motifs de contournement par Function.constructor. Les bundles sont gzippés et hashés SHA-256. L'API autorise jusqu'à 1,5 MB de bundle brut, et le runtime impose un plafond de décompression de 2 MB, avec un compteur d'octets en streaming qui interrompt avant qu'une bombe GZIP n'ait rempli la heap. Un détail que je défends : le bundle compilé est exécuté une fois dans un isolate jetable, tous les ponts étant stubbés, et c'est cette exécution qui extrait le manifeste des outils. Le programme est payé au moment de la compilation, pas de la requête.
Et voici ce que les développeurs ne voient jamais. Le bundle ne sait pas qu'il est dans le cloud. Le même appel startServer() qui démarre un serveur sur stdio sur le laptop d'un développeur détecte le global __vinkius_edge_interceptor du runtime, lui remet ses définitions d'outils par cet interceptor, et saute la configuration de transport normale. Une seule base de code, deux runtimes : on développe localement avec le framework et on déploie dans le cloud sans la moindre branche if (inCloud).
La version du protocole voyage avec le runtime, pas avec le bundle. Le gateway parle la release stateless MCP du 2026-07-28 comme dialecte principal, et négocie à la baisse via la release 2025 puis le transport SSE du 2024-11-05 en repli, si bien qu'un client vieux d'un an parvient encore à parler à un serveur déployé ce matin. Le dialecte sur lequel se pose une session est une poignée de main, pas une décision de déploiement.
Pourquoi le guest ne touche jamais au réseau
Le plus dangereux qu'un bundle tenant puisse faire est de passer une requête HTTP. fetch est une source universelle de SSRF : un bundle négligent ou malveillant qui pointe un outil vers http://169.254.169.254/, le service de métadonnées AWS, offre à l'agent IA d'un client un chemin de lecture vers les identifiants de l'instance. Tout le trafic sortant passe donc par le garde-fou SSRF, et le garde-fou repose sur un seul principe : une adresse n'est valable que le temps de la politique qui l'a approuvée. Il résout le DNS avant la requête et bloque net les plages privées (loopback, 10/8, 172.16/12, 192.168/16, link-local 169.254/16 (le service de métadonnées), 0/8, et leurs équivalents IPv6). Il fixe ensuite l'IP approuvée dans la connexion undici, pour qu'une attaque de rebinding ne puisse pas échanger l'adresse après le contrôle. Et il garde SNI et TLS alignés sur l'adresse fixée, car la fixer au niveau socket sans fixer le nom déclencherait CERT_ALTNAME_INVALID à chaque requête. Le cache DNS est plafonné à 4 096 entrées et ne vit pas plus longtemps que la connexion poolée à laquelle il appartient.
Le réglage keep-alive de cet agent poolisé est la correction la plus ennuyeuse que j'aie jamais livrée, et je suis content de l'écrire. Le timeout idle par défaut de undici est de 4 s, et il fermait les sockets poolisés entre deux tours de conversation, en arrière-plan : presque chaque appel d'outil réel payait un handshake TLS à froid. Nous le faisons tourner à 65 s, juste au-dessus de la fenêtre idle de 60 s de l'ALB, et le pool est plafonné à 100 sockets par cible. Le p50 des appels sortants a chuté d'un handshake. Une correction ennuyeuse qui se mesure au p50, c'est le rêve.
Les réponses streament dans l'isolate avec un compteur d'octets en cours, plafonné dur à 10 MB, et un AbortController branché sur tout le chemin de dispose : quand un isolate est retiré, ses requêtes en vol sont interrompues dans le même appel. Quand un dispatch expiré (le budget est de 30 s), l'erreur n'est pas un générique « la requête a pris trop de temps ». Un classifieur demande ce que l'isolate faisait au moment du dépassement : I/O amont en vol, le guest en train de calculer, ou pression mémoire ? Le tool_error renvoyé à l'agent porte la réponse, plus un indice de récupération. L'attribution d'une défaillance (l'API amont du tenant, le code du tenant, ou la plateforme) ne se règle pas en greppant des logs à trois heures du matin.
La sortie de ce classifieur alimente un anneau d'attribution amont de 32 slots, le plus récent d'abord. La vue opérationnelle montre alors non seulement que des dispatch échouent, mais quel est l'amont défaillant. Quand l'API CRM d'un tenant se dégrade à deux heures du matin, le runtime sait que c'est le CRM du tenant et non la plateforme, et l'anneau retient les preuves assez longtemps pour que le canal d'incident puisse les lire.
Provisionner une fois : le principe du snapshot
Un démarrage complet (compiler le bundle, exécuter la couche de polyfills, exécuter l'IIFE) coûte de 50 à 100 ms environ au premier contact avec un déploiement. C'est acceptable pour la requête numéro 1. Pas pour la requête numéro 4 000, c'est-à-dire toutes les autres.
Le principe, c'est qu'un environnement et un programme sont des artefacts différents, et que seul l'un change souvent. La couche de polyfills est statique pour un déploiement donné : même version V8, même surface d'hôte. Ce qui change par requête, c'est le code du tenant. Nous snapshottons donc l'environnement, pas le programme. L'hôte exécute le builder de snapshot d'isolated-vm sur l'environnement provisionné et met en cache le blob de heap résultant sur disque, indexé par ID de déploiement et marqué de la version V8 sous laquelle il a été construit. Au moment du restore, un isolate neuf est créé à partir de ce blob : une ou deux millisecondes pour le moteur, une ou deux de plus pour remplacer les ponts stubbés par les réels, puis l'IIFE lui-même s'exécute à nouveau dans le contexte restauré. Total : de 15 à 25 ms, contre 50 à 100 pour un démarrage complet, et le travail de polyfill ne se fait qu'une seule fois par déploiement. Le bundle est réexécuté plutôt que snapshotté, car Isolate.createSnapshot() est une méthode statique qui ne peut pas exécuter de code asynchrone, et nos IIFE ont le droit de await au niveau supérieur.
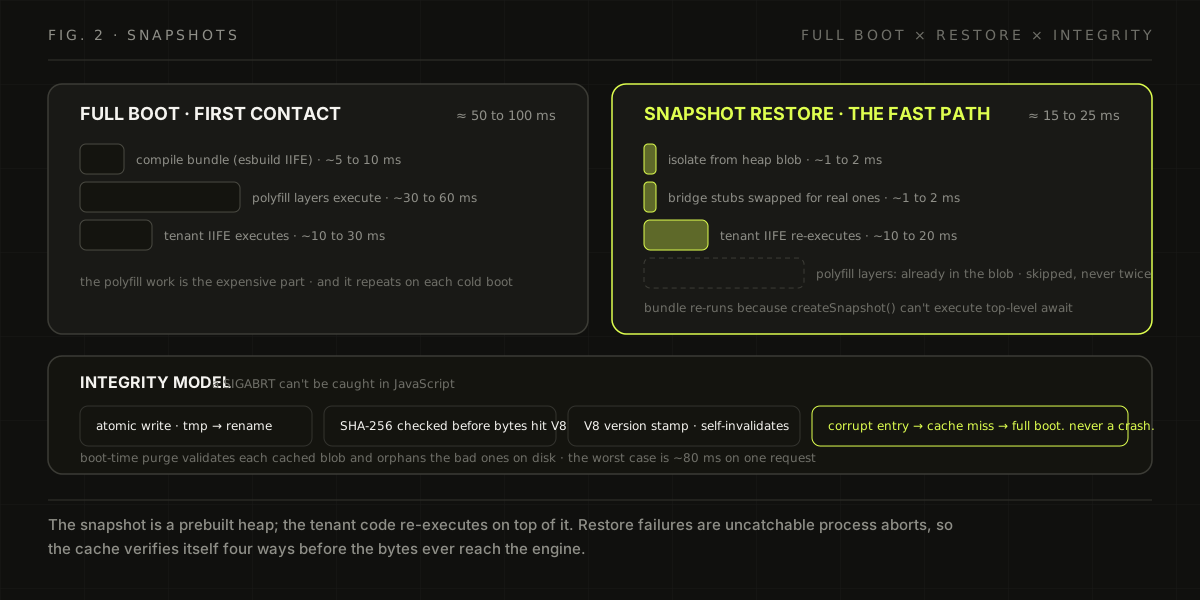
La partie difficile des snapshots n'est pas la vitesse. C'est le mode de défaillance. Un échec de désérialisation dans V8 est un SIGABRT : le processus meurt, JavaScript ne peut pas le catcher, et un blob corrompu posé sur disque, c'est une boucle de crash qui n'attend que son heure. Restore, abort, redémarrage, restore du même blob, abort de nouveau. Le modèle d'intégrité traite donc le cache comme une entrée non fiable. Quatre couches, dans l'ordre : les écritures sont atomiques (le blob arrive dans un fichier .tmp puis est renommé, les métadonnées d'abord, pour qu'un kill en pleine écriture laisse une paire vérifiablement incohérente, pas un demi-blob) ; chaque blob est hashé SHA-256 et le hash est vérifié avant que les octets n'arrivent à V8 ; le marquage de version V8 fait que le cache s'auto-invalide dès que Node est mis à niveau sur la flotte ; et au démarrage du processus, une passe de purge valide les snapshots en cache sur disque et supprime les mauvais. L'invariant de conception qui tient sous tout ça : une entrée de cache corrompue se dégrade en un démarrage à froid de 100 ms. Elle ne se dégrade jamais en crash. L'incident entier, c'est ça : 80 millisecondes de plus sur une requête.
La couche de snapshot sert aussi d'hibernation. Les bundles stateful exposent des hooks getState et setState avec un budget de sérialisation d'une seconde, pour qu'un tenant qui garde un working set en mémoire puisse voir son état extrait, son isolate retiré, et son état réinjecté à la requête suivante. Même mécanique, direction inversée.
Des invariants : ce qu'une phase doit à la suivante
La couche du dessus n'est honnête que jusqu'à ses invariants, et les invariants pourrissent quand ils ne vivent que dans les têtes. Le runner porte donc un contrat écrit : 34 règles réparties sur ses quatre phases (boot, snapshot, dispatch, dispose), posées à côté du code qu'elles gouvernent et relues à chaque revue qui touche ce fichier. Les phases sont le cycle de vie ; les règles sont ce qu'une phase doit à la suivante. La plupart sont des règles de « non ». Pas de pont dans un snapshot. Pas de timer d'hôte qui survit à son isolate. Pas de dispatch qui saute l'attribution du timeout.
C'est dans le dispose que le contrat paie, car le dispose est la seule phase où se tromper d'ordre fait fuir quelque chose. Retirer un isolate suit une séquence fixe de cinq étapes : d'abord aborter le AbortController, pour que le HTTP en attente meure avec l'abort ; effacer les timers côté hôte, pour que le guest ne puisse plus se replanifier ; relâcher les handles de référence isolated-vm dans l'ordre inverse de l'allocation ; relâcher le contexte et l'isolate ; et seulement là, mettre à nul la dernière référence JavaScript, pour que rien n'accroche une heap morte au processus. Le concept, c'est le transfert de propriété : aucun pont ne doit survivre à l'isolate qu'il pointe. On saute une étape, et on obtient une heap qui traîne, un timer qui se déclenche dans un cadavre, ou une requête qui survit à son propriétaire. L'ordre porte, et le contrat le dit noir sur blanc.
La prévention des pertes de données reçoit le même traitement à l'autre bout du cycle de vie. Avant qu'un payload n'atteigne le code du tenant, il passe une passe de redaction chargée au boot, pas en différé : un contrôle qui n'est pas encore chargé n'existe pas. Les identifiants en transit et tout ce qui ressemble à un secret sont masqués avant de toucher une ligne de log ou un argument de pont. Un DLP qui vit dans le code du tenant est un DLP que le tenant peut désactiver ; un DLP du côté hôte du pont, non.
Confinement par construction
Les limites du runtime ne sont pas un mur de nombres magiques. Elles vivent dans un seul fichier, Limits.ts, qui documente, à côté de chaque constante, d'où vient le nombre. Le budget de dispatch de 30 s vient du comportement des utilisateurs : les clients MCP mainstream abandonnent un appel d'outil quelque part dans l'intervalle de 30 à 60 s, si bien qu'au-delà de 30 nous dépensons des ressources pour un résultat que personne ne lira. Le keep-alive de 65 s fait miroir de la fenêtre idle de l'ALB. L'horizon du sweep appartient au palier idle de 30 min du suivi de connexions. Une limite est l'empreinte d'une politique, pas une constante : quand la politique change, un seul fichier change, et la dérivation reste consignée.
Les identifiants suivent la même discipline. La map de secrets déchiffrés d'un tenant est injectée dans l'isolate en copie profonde sur __vinkius_secrets : le guest la lit, il ne peut pas écrire de l'autre côté de l'hôte. Le runner conserve une empreinte SHA-256 de la map, pas les valeurs, ce qui rend la réinjection lors d'une requête ultérieure un no-op bon marché quand rien n'a changé. Chaque token a son runner et son isolate ; il n'existe aucun pooling qui partage l'état des identifiants entre tenants, point final.
La seule forme de token qui parvient jusqu'à un isolate est le token de connexion live, c'est-à-dire tout ce qui porte le préfixe vk_live_. Tokens de preview, tokens révoqués, tokens pour un autre déploiement : ils échouent à la frontière du runner, avant qu'un pont ne soit enregistré. La seule capacité que le guest possède vraiment est VINKIUS_TOKEN, exposée au code des outils du catalogue : elle authentifie un outil auprès de la plateforme en tant que l'utilisateur qui le possède, limitée au catalogue de cet utilisateur. Le modèle, ce sont des capacités, pas des mots de passe : chaque franchissement de frontière est un droit nommé, audité, révocable.
Ce qu'un bundle ne peut pas faire est documenté aussi positivement que ce qu'il peut. Pas de filesystem, pas de process.env, pas d'accès direct aux ponts (le sanitizeur le rejette à la compilation), 128 MB de heap, des timers de 30 s, 10 logs par seconde et 1 Ko par message à travers le pont console, un plafond fetch de 10 MB. Quand un tenant franchit la ligne financière, le circuit breaker ne renvoie pas un 429 en haussant les épaules. La couche de quota émet une erreur IA-native : un langage simple qui dit au LLM d'arrêter de retryer et de remonter le plafond de budget à l'utilisateur humain, avec un lien vers la console Vinkius Cloud où le propriétaire approuve la reprise. Une tempête de retry est le mode de défaillance natif des agents ; la plateforme doit répondre à l'agent, pas seulement à la personne derrière.
Ce que la plateforme possède
Tout ça tourne sur une petite flotte, délibérément x86-only. Le verrouillage x86 est une contrainte que j'assume : isolated-vm est un add-on natif, et ses builds ARM ont été notre dépendance la plus capricieuse. En x86 c'est ennuyeux, et l'ennuyeux est l'objectif dans la couche où tourne le code des autres.
Le processus démarre vide. Aucune configuration n'est chargée au démarrage ; la première connexion d'un token tire la configuration du serveur depuis l'API Laravel à la demande, démarre l'isolate de ce serveur juste au moment voulu, et un sweep LRU retire les entrées après 30 min d'inactivité, si bien qu'une seule tâche détient l'état live de nombreux tenants. Redis porte le plan de contrôle (invalidation, kill switches, notifications de changement d'outils, mises à jour de quota), pour qu'un changement de configuration dans la console atteigne toutes les tâches sans déploiement.
Une dernière pièce du récit sécurité repose à côté des isolates, et je termine dessus parce qu'elle montre la frontière que nous avons tracée délibérément : le chemin d'audit cryptographique. Chaque événement d'appel d'outil s'écoule vers un démon mono-thread en streaming qui forge une chaîne de hash SHA-256 et la signe avec une clé de session Ed25519, conservée en RAM pendant 24 h et certifiée par la clé maître au boot. Après un crash, le démon re-traite les événements non-ACKés, pour que la chaîne n'ait jamais de trou. Chaque maillon forgé est checkpointé dans un consumer group de Redis Streams, si bien qu'un crash repart du dernier événement ACKé au lieu de re-dériver la chaîne, et les adapters SIEM vident ce même stream derrière leurs propres circuit breakers : un sink défaillant est mis à l'écart, au lieu de laisser déborder le chemin d'audit. La règle qui a rendu le démon nécessaire tient en une ligne de source : V8 ne touche jamais à la crypto. Le code tenant peut calculer un hash à travers les ponts de l'hôte, mais il ne peut ni signer, ni certifier, ni forger quoi que ce soit. La piste d'audit est quelque chose que la plateforme fait au runtime, pas quelque chose que les tenants du runtime peuvent atteindre.
La direction
La couche d'isolates d'aujourd'hui, c'est le récit stateless, rapide, plafonné dur : démarrage en une ou deux millisecondes, plafond à 128 MB, retrait par sweep, et le snapshot qui porte le lourd. La direction ouverte est la stateful : des états de tenant plus long-lived portés par les hooks d'hibernation, un empaquetage plus dense d'isolates live par tâche, et, un jour, des équipes qui apportent leurs propres catalogues de connecteurs au marketplace sans attendre notre CI.
Je ne pense pas que les isolates V8 soient la réponse finale au code edge multi-tenant. Ils sont la réponse pour la forme que cette plateforme a, et c'est la forme que je veux qu'elle garde : des tenants bon marché, des plafonds durs, et un démarrage à l'échelle de la milliseconde, parce que la patience d'un agent se mesure en secondes, et la confiance aussi. Le « zero cold start » de Cloudflare est une phrase qu'on peut ingénier, pas un slogan qu'on peut seulement admirer. C'est un isolate, un snapshot, une chaîne d'intégrité, et une série de décisions sans éclat sur qui possède les timers. Le code de cet article est le runtime derrière les serveurs MCP de cloud.vinkius.com, et le travail de tracing qui relie ses spans d'outils aux traces distribuées est dans l'article MCP Fusion 5.1.0. La direction stateful vers laquelle se dirige cette plateforme est la couche de session elle-même : comment le SwarmGateway fusionne les sessions d'agent qui se chevauchent et applique une invalidation causale sur les états obsolètes. L'architecture complète est dans l'article sur les sessions SwarmGateway.
La sandbox V8 isolate et sa séquence de démarrage de 12 étapes sont couverts avec du code source dans Questions d'IA d'Entreprise.