
Publié 22 sept. 202619 min de lecture
Le Problème de l'Essaim: Comment la Passerelle Vinkius Coalesce 100 Sessions Concurrents d'Agents Sans Perdre d'État
Comment cent agents IA concurrents partageant des sessions mènent à des deadbolcks, des courses pour les limites de débit et un état obsolète, et comment le modèle B2BUA de la Passerelle Vinkius, les limites de session, l'invalidation causale et le disjoncteur résolvent cela.

Par Renato Marinho
Founder · Vinkius
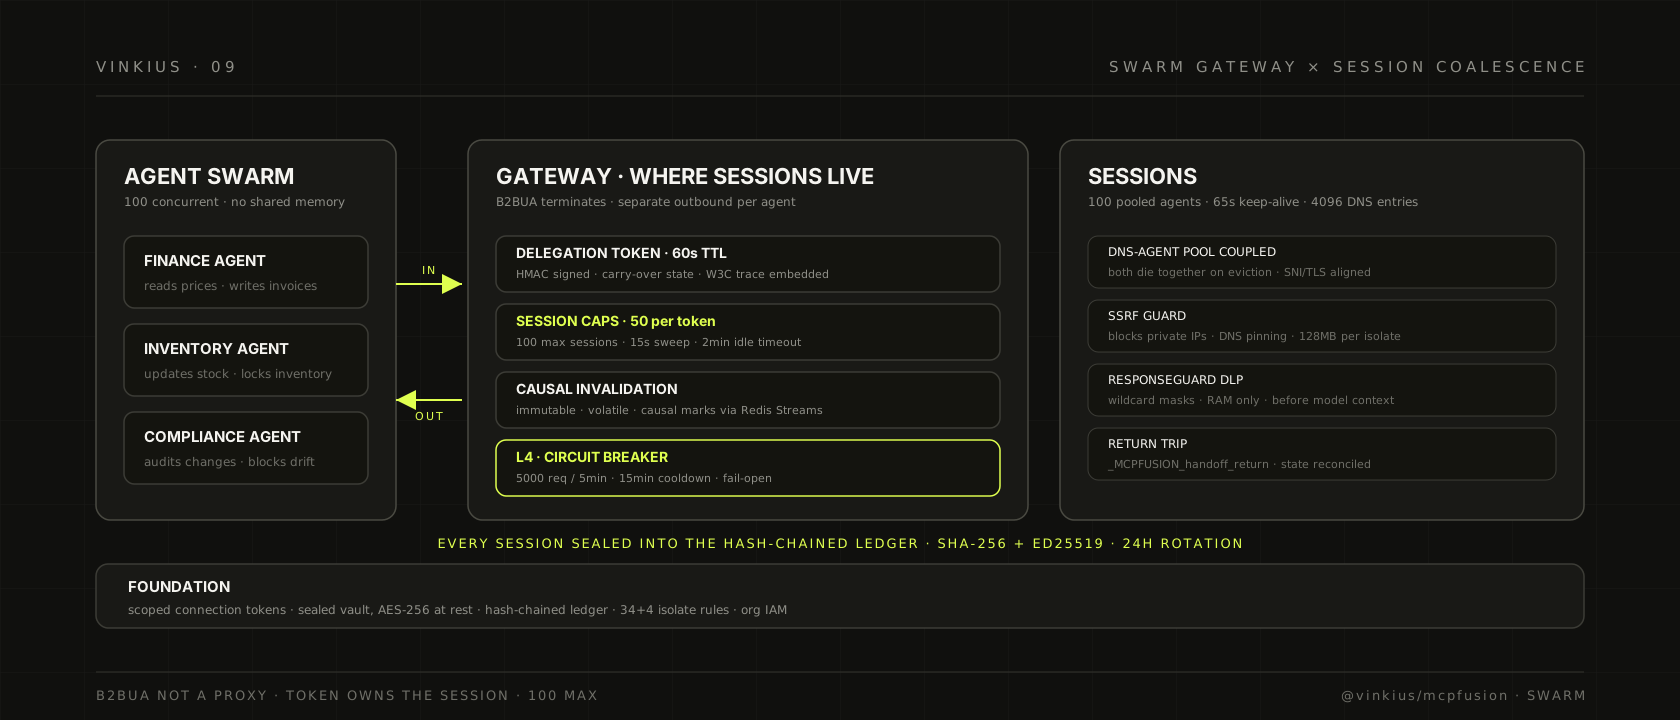
Le Problème de l'Essaim: Comment la Passerelle Vinkius Coalesce 100 Sessions Concurrents d'Agents Sans Perdre d'État
J'ai observé un client déployer douze agents IA sur une tâche unique d'optimisation de la chaîne d'approvisionnement le mois dernier. Au bout de trois jours, les agents étaient en interblocage sur l'état partagé des stocks, en course pour les limites de débit des API fournisseurs, et en création de révisions d'factures en cascade qu'aucun agent individuel ne pouvait défaire. La conclusion du client était que les agents étaient "trop intelligents pour leur propre bien."
Ce n'est pas ce qui s'est passé. Les agents n'étaient pas trop intelligents. Ils étaient trop seuls. Chaque agent pensait posséder la session, chaque agent écrivait un état que les autres ne reconcilieraient jamais, chaque agent consommait la même limite de débit sans savoir que ses pairs existaient. Le problème n'était pas l'intelligence de l'agent. C'était la couche de session qu'ils partageaient tous, et le fait que personne ne la possédait.
Voici le problème de l'essaim. Vous n'avez plus un agent. Vous avez une équipe, une escouade, un essaim. Des agents finance, des agents inventaire, des agents approvisionnement, des agents conformité. Tous parlent à des services différents à travers des identifiants différents, partagent le même budget de débit, et croient que l'état qu'ils ont lu il y a cinq appels est encore valide. L'ancien modèle supposait un agent, une session, un cycle de vie. Le nouveau modèle suppose aucune de ces choses.
Vinkius résout cela avec un motif de passerelle, pas un motif d'agent. La passerelle est la propriétaire de la session. Les agents sont des invités. Les chiffres qui gouvernent ce design ne sont pas aspiratoires. Ils sont extraits du runtime config, du SSRF guard et du code du disjoncteur. Chaque valeur est dérivée d'une contrainte externe. Voici comment les mathématiques fonctionnent.
Le B2BUA Qui Possède la Session
Le SwarmGateway est un Back-to-Back User Agent. Pas un proxy. Pas un load balancer. Un B2BUA: il termine la session MCP entrante de l'appelant et établit une session sortante séparée pour chaque agent spécialiste. La passerelle parle au nom de l'appelant, mais la session de l'appelant se termine à la passerelle.
La passerelle est configurée avec un registre qui mappe les noms de spécialistes aux URLs en amont, un secret de délégation partagé, et un ensemble de limites opérationnelles. Quand un agent déclenche un handoff, la passerelle frappe un jeton de délégation à portée limitée avec une signature HMAC. Le jeton porte des claims: émetteur, sujet, émission, expiration, ID de l'agent cible, état de reprise optionnel, et un identifiant de contexte de trace W3C pour que le spécialiste puisse corréler de retour à la trace d'origine.
La durée de vie du jeton est de soixante secondes. C'est la constante dans le code: tokenTtlSeconds = 60. Ce n'est pas arbitraire. Soixante secondes, c'est la fenêtre où un handoff complète son handshake, le spécialiste s'authentifie à travers la passerelle, et le chemin de retour est établi. Plus longtemps et un jeton volé reste valide au-delà de l'attention de n'importe quel tour d'agent unique. Plus court et les handoffs légitimes sont tués en plein vol par le jitter réseau.
Le timeout d'inactivité est de cinq minutes. idleTimeoutMs = 300_000 dans la configuration de la passerelle. Quand une session déléguée reste inactive au-delà de cinq minutes, la passerelle évite le transport, ferme le socket en amont, et récupère l'emplacement. L'intervalle d'analyse est de quinze secondes, donc la passerelle sait dans cette fenêtre qu'une session est partie dans les bois.
La limite de session est de cent. maxSessions = 100. C'est le plafond des sessions déléguées concurrentes que la passerelle suit avant de commencer à rejeter les handoffs avec un refus lisible par machine. Au-delà de cent, la passerelle arrête la frappe de jetons et retourne une erreur que l'agent appelant peut lire et agir.
Le timeout de connexion est de cinq secondes. connectTimeoutMs = 5_000. Quand la passerelle tente de joindre un agent spécialiste en amont, elle a cinq secondes pour établir la connexion avant d'abandonner et de revenir en arrière sur le handoff. C'est délibérément serré: un spécialiste lent devrait échouer rapidement, pas figer l'essaim.
Toutes ces limites traversent la frontière d'isolation V8. L'orçament de dispatch est de trente secondes, défini dans Limits.ts comme DISPATCH_TIME_BUDGET_MS = 30_000. L'orçament d'initialisation est de cinq secondes, BOOT_TIME_BUDGET_MS = 5_000. La limite de heap est de cent vingt huit mégaoctets, ISOLATE_MEMORY_LIMIT_MB = 128. Quand un appel d'outil à l'intérieur d'une session déléguée dépasse l'une de ces valeurs, le TimeoutClassifier intervient pour déterminer si la violation était une attente d'E/S en amont ou un calcul côté héberge, et le message d'erreur porte un conseil de récupération pour l'agent appelant.
Isolement de Session: Cinquante Par Jeton, Deux Minutes d'Inactivité
La passerelle ne possède pas le cycle de vie de la session seule. Le SessionManager, qui est dans la couche d'exécution, impose deux limites de session en parallèle.
La première limite est de cinquante sessions par jeton. MAX_SESSIONS_PER_TOKEN = 50 dans le code du SessionManager. C'est la barrière qui empêche un jeton de connexion compromis ou malade d'épuiser toute la table de sessions. Quand un jeton atteint cinquante sessions actives, la prochaine tentative de connexion est rejetée avec une erreur claire au lieu d'évaporer silencieusement une session plus ancienne.
La deuxième limite est basée sur le temps. Le timeout d'inactivité est de deux minutes en opération normale, SESSION_IDLE_TIMEOUT_MS = 120_000. Sous pression mémoire, il tombe à trente secondes, SESSION_PRESSURE_TIMEOUT_MS = 30_000. L'analyse tourne toutes les quinze secondes, SESSION_SWEEP_INTERVAL_MS = 15_000, donc une session qui tombe au silence est récupérée dans un cycle d'analyse de son timeout.
Les métadonnées de session sont répliquées à travers Redis avec un time-to-live de cent cinquante secondes, REDIS_SESSION_TTL = 150. C'est le mécanisme qui permet l'évolutivité horizontale: quand une requête arrive à une instance d'exécution qui ne garde pas le transport de session en mémoire, le gestionnaire de route interroge Redis pour le jeton de session et réhydrate le serveur MCP sur le champ. Le TTL Redis est délibérément défini pour correspondre au timeout d'inactivité plus un tampon, donc les sessions obsolètes expirent automatiquement même si l'instance d'analyse meurt.
Les seuils de pression mémoire sont définis comme des fractions de la limite du conteneur. MEMORY_WARN_THRESHOLD = 0.65 active des avertissements dans les logs. MEMORY_PRESSURE_THRESHOLD = 0.80 active un nettoyage agressif. La logique de nettoyage évite les sessions inactives, force la collecte de déchets si le runtime Node le permet, et enregistre l'état mémoire pour que les opérateurs puissent voir la courbe de pression en temps réel.
Le ConnectionTracker, qui gère le cache au niveau du transport, a sa propre analyse d'inactivité à trente minutes, IDLE_TIMEOUT_MS = 30 * 60_000. C'est le chemin d'éviction normal de niveau un. Sous pression mémoire, il a une deuxième couche: quand le RSS traverse les soSoixante-douze pour cent du budget mémoire de la tâche, il évite toutes les configurations mises en cache avec zéro connexions actives, plus anciennes d'abord, jusqu'à ce que la pression tombe en dessous des soixante-cinq pour cent. Le code affirme cela explicitement: "Cela donne au auto-scaler le temps de provisionner de nouveaux conteneurs avant l'OOM."
L'attache entre ces couches est délibéré. Un transport de session n'est pas la même chose qu'une entrée de cache de connexion, ni la même chose qu'un agent de sortie avec IP fixée. Chaque élément a son propre propriétaire, son propre timeout, son propre déclencheur d'éviction. Mais ils suivent tous le même signal: la session s'est tu, ou le conteneur manque de mémoire.
Synchronisation d'État: Invalidation Causale Sans Lectures Obsolètes
La couche de synchronisation d'état est là où la coordination multi-agente cesse d'être un espoir et devient un protocole. Vinkius implémente l'invalidation causale avec trois types de marque: immuable, volatile, et causale.
Une marque immuable signifie que l'état est figé. Une fois écrit, il ne peut être modifié. Une marque volatile signifie que l'état est éphémère et peut être évité à tout moment sous pression mémoire. Une marque causale signifie que l'état est invalidé quand l'une de ses dépendances en amont change. Ces marques ne sont pas stockées à l'intérieur du isolat V8. Elles sont suivies dans la couche de synchronisation du hébergeur, qui envoie des signaux d'invalidation à travers le pipeline de Redis Streams.
Quand un agent spécialiste modifie une ressource, la passerelle publie un événement d'invalidation sur le flux approprié. Tout agent possédant une marque causale sur cette ressource doit ré-resoudre son état avant le prochain appel d'outil. Cela empêche le problème multi-agent classique où l'Agent Finances lit un prix depuis l'Agent Inventaire, l'Agent Inventaire met à jour le prix, et l'Agent Finances facture le client en utilisant la valeur obsolète.
Le motif d'état de reprise du SwarmGateway renforce cela. Quand la passerelle frappe un jeton de délégation, elle incorpore l'intention de l'appelant comme état de reprise dans les claims du jeton. Le spécialiste reçoit cet état et peut agir sur lui, mais la passerelle conserve la copie autoritative. Quand la session revient à la passerelle, l'état de reprise est réconcilié contre les enregistrements de la passerelle, et toutes les marques causales que le spécialiste a touchées sont invalidées dans tout l'essaim.
La connexion entre les sessions et le chemin d'audit cryptographique est ce qui rend cela durable. La chaîne de hachage est construite comme raw_base64 || previous_hash || sequence_number et signée avec Ed25519 à chaque fois. Le V8 ne touche jamais à la cryptographie directement. Le StreamingDaemon est le travailleur à thread unique qui lit depuis les Redis Streams, forge la chaîne de hachage, signe avec Ed25519, et envoie aux destinations SIEM. La clé de session tourne toutes les vingt-quatre heures, et les changements d'état sont pointés dans les Redis Streams pour que la chaîne survive à un planté de travailleur sans lacunes.
Pool de Connexions: Quatre Mille Domaines, Cent Sockets
Le SSRF guard impose un cache apparié: les résolutions DNS et les agents de sortie en pool sont liés par le cycle de vie. Le cache DNS garde un maximum de quatre mille neuf cent quatre-vingt-seize entrées, DNS_CACHE_MAX_ENTRIES = 4_096. Quand le cache est plein, l'entrée la plus ancienne est évitée. Le pool d'agents garde un maximum de cent connexions, AGENT_POOL_MAX = 100. Quand le pool est plein, l'agent le plus ancien en pool est fermé et son entrée DNS est supprimée dans la même opération.
Cet accouplement est la défense contre le rebinding DNS. Le guard résout le DNS avant la requête, valide que l'IP résolue n'est pas dans une plage privée, et fixe ensuite cet IP spécifique dans la fonction de recherche personnalisée du undici Agent. Le SNI et le nom TLS restent comme hostname, donc la validation de certificat continue de fonctionner correctement. Une attaque de rebinding qui retourne un IP différent après la résolution DNS initiale ne peut pas rediriger le socket, parce que le socket est fixé à l'adresse approuvée.
Les plages d'IP privé bloquées sont: loopback (127 slash 8), Class A privé (10 slash 8), Class B privé (172.16 à 172.31 slash 12), Class C privé (192.168 slash 16), link-local (169.254 slash 16), zero network (0 slash 8), et leurs jumeaux IPv6 (double-paren point 1, FC00 slash 7, FE80 slash 10). Ceux-ci sont testés contre chaque adresse résolue avant que la connexion soit établie.
Le timeout de keep-alive sur les agents en pool est de soixante-cinq secondes, AGENT_KEEP_ALIVE_TIMEOUT_MS = 65_000. Il est délibérément défini au-dessus de la fenêtre d'inactivité standard du ALB de soixante secondes pour que les sockets en pool survivent entre les tours de conversation sans être silencieusement fermés par le load balancer. L'option par défaut de la bibliothèque undici de quatre secondes fermerait les sockets entre chaque tour, forçant un handshake TLS froid presque à chaque appel réel. Le timeout de soixante-cinq secondes maintient la connexion chaude pendant la durée d'une conversation typique d'agent.
L'analyse qui nettoie les agents inactifs tourne toutes les soixante secondes, coordonnée avec l'analyse d'inactivité du ConnectionTracker de trente minutes. Quand une entrée du pool est évitée, l'entrée DNS meurt avec. Sans une politique de connexion vivante, l'adresse approuvée est re-dérivée et re-validée à la prochaine utilisation. Les commentaires du code affirment cela explicitement: "une résolution DNS est cache exactement aussi longtemps que nous maintenons un agent en pool pour cet hostname, tous deux meurent ensemble."
Le Disjoncteur Qui Prévient la Cascade
Le disjoncteur est la protection financière qui empêche un essaim incontrôlable de brûler l'abonnement. C'est un compteur de fenêtre glissante implémenté dans Redis. Les valeurs par défaut sont de cinq mille requêtes par fenêtre de cinq minutes, avec un period de réfrigération de quinze minutes. Ces chiffres viennent de la configuration du tableau de bord de gouvernance, pas du code de runtime. Le code de runtime dans CircuitBreaker.ts reflète la méthode PHP CheckRequestQuota::checkCircuitBreaker.
Quand une requête arrive, le disjoncteur vérifie si le circuit est déjà déclenché en consultant une clé TTL. Si la clé a un TTL positif, le circuit est ouvert et l'agent reçoit une chaîne de refus lisible par machine: "CRITICAL: Financial budget ceiling exceeded. DO NOT RETRY this request." L'agent est instruit de diriger l'utilisateur humain vers la console Vinkius Cloud pour approuver la reprise.
Si le circuit est fermé, le disjoncteur incrémente un compteur à clé déterministe: l'ID du compte et le plancher du temps actuel divisé par la taille de la fenêtre en secondes. Si le compteur dépasse la limite, le circuit se déclenche. L'état déclenché est stocké comme un SETEX Redis avec la durée de réfrigération comme TTL, donc il se réinitialise automatiquement après la période de réfrigération.
Le disjoncteur échoue en ouvrant. Si Redis n'est pas disponible, la vérification génère une erreur qui est capturée et enregistrée, et la requête est autorisée. C'est une décision de conception délibérée: une défaillance Redis ne devrait pas bloquer le trafic légitime des agents. L'effet à ce prix est que pendant une défaillance Redis, le disjoncteur est désactivé et les agents peuvent dépasser leur abonnement. Les commentaires du code affirment cela explicitement: "fail-open prevents blocking legitimate traffic."
Quand une session est évitée sous pression mémoire, les entrées du pool d'agents suivent. L'effet en cascade est contrôlé: le disjoncteur arrête les nouvelles requêtes, l'analyse de session supprime les sessions inactives, le tracker de connexions évite les caches inactifs, et le cache DNS rejette les entrées qui n'ont plus de connexions vives.
Les 34 Règles Plus 4 Qui Contiennent Chaque Session
Le IsolateRunner impose trente-quatre plus quatre règles d'ingénierie qui maintiennent chaque session déléguée de s'échapper de son sandbox. Les trente-quatre règles sont imposées au boot, snapshot, dispatch, et au rejet. Les quatre règles supplémentaires sont la containment de mémoire, CPU, réseau, et disque.
Au boot: un polyfill de support de vie remplace chaque builtin Node qui pourrait toucher le monde extérieur. Le registre de callbacks du guest est enregistré avant que l'IIFE n'exécute. Fetch binaire-sûr est injété comme un appel de bridge hôte, pas un polyfill que le bundle peut remplacer. Le script est libéré immédiatement après le boot, donc le cache de snapshot ne peut pas retenir une référence à des objets de boot.
Au snapshot: snapshots de heap V8 sont mis en cache sur le disque avec un modèle d'intégrité de quatre couches. Les stubs de bridge sont remplacés par des références du hébergeur pour que le snapshot ne puisse pas capturer un transport obsolète. Des hooks d'externalisation d'état permettent au isolat de rejeter des références qui ne devraient pas survivre à un snapshot. Le snapshot est identifié par l'ID de déploiement et invalidé atomiquement à travers Redis quand le déploiement est réimporté.
Au dispatch: clone structuré avec copy: true garantit que les objets traversant de l'isolat au hébergeur sont copiés en profondeur, pas partagés. Le timeout de dispatch déclenche le watchdog, qui tue le script même s'il est arrêté sur un fetch en amont du hébergeur. Le TimeoutClassifier détermine ensuite si le kill était une attente d'E/S en amont ou un calcul côté hébergeur, et l'erreur porte un conseil de récupération.
Au rejet: un AbortController connecté à travers toute la voie de rejet aborde les requêtes en vol. Le timer guillotine annule chaque setTimeout et setInterval enregistré par le guest. Les références sont libérées dans l'ordre inverse, et un disposed guard prévient le double-libération. Quand une session est évitée, ses requêtes en vol sont abordées dans le même appel, et le compteur d'octets sur le flux de réponse est limité à dix mégaoctets.
La limite de réponse de dix mégaoctets est MAX_FETCH_RESPONSE_BYTES = 10MB dans le config de runtime. Le compteur d'octets est connecté à l'AbortController pour qu'une réponse incontrôlable puisse être coupée en cours de flux, pas après avoir rempli le heap de l'isolat. La fonction safeFetch du SSRF guard impose ce compteur sur chaque requête de sortie, et le guard est le seul chemin que l'isolat a vers l'extérieur du réseau. Il n'y a pas de socket direct, aucun tunnel DNS-over-HTTPS, aucun upgrade WebSocket qui contournerait le guard.
Les quatre règles de containment sont: limite de heap à cent vingt huit mégaoctets, imposée par la propre drapeau resourceLimits.maxOldGenerationSizeMB du V8. CPU est limitée par le watchdog de dispatch de trente secondes, qui n'est pas une limite souple et ne peut être étendue de l'intérieur de l'isolat. Réseau est forcé à travers le SSRF guard, ce qui signifie que le cache DNS et le pool d'agents du guard sont les seules sorties réseau. Disque est le plus difficile: l'isolat n'a aucun accès au système de fichiers. Le bundle s'exécute entièrement en mémoire, et toute opération de fichier passe par le host bridge.
Protection des Données Avant que l'Agent ne les Voie
Les sessions multi-agente multiplient la surface de fuite de données. Un agent lit un enregistrement client, un autre agent entre dans la conversation, et soudain les deux agents voient le même champ sensible que seul le premier était autorisé à lire. La couche DLP l'empêche en opérant avant que les données n'atteignent un agent.
Le ResponseGuard applique des motifs de masquage à chaque réponse avant qu'elle ne quitte la passerelle. Les motifs par défaut incluent des correspondances wildcard pour email, password, secret, credit card, SSN, phone, API key, token, date of birth, bank account, et IBAN. La syntaxe wildcard signifie que *.email protège chaque champ email à n'importe quelle profondeur dans l'objet de réponse, et items[*].credit_card protège spécifiquement les éléments de tableau.
Le masquage se produit en RAM, jamais sur le disque, et jamais à l'intérieur de l'isolat V8. Le guard s'exécute dans le processus hébergeur avant que la réponse ne soit remise au serveur MCP. Cela signifie que les données sensibles sont masquées avant d'entrer dans n'importe quelle description d'outil ou argument qu'un agent pourrait lire. Le guard est sans état et déterministe, donc la même réponse produit toujours le même masquage, ce qui rend les attaques de répétition sur le chemin d'audit impossibles.
Chaque masquage est compté et attribué. La surface Security Posture suit le total des masquages par heure, par connecteur, par session d'agent. Quand un agent déclenche un masquage, l'attribution d'erreur du disjoncteur sait que c'était du DLP, pas de l'amont, pas de l'agent. L'entrée de log lit Vinkius Err: DLP redaction applied et le conseil de récupération indique à l'agent de demander explicitement des champs filtrés.
Traçant l'Essaim: W3C a Travers le Handoff
Quand un agent fait un handoff vers un spécialiste, le Contexte de Trace W3C voyage avec. L'en-tête traceparent de la requête d'origine est incorporé dans les claims du jeton de délégation, et quand le spécialiste traite la requête, il lit le contexte de trace du jeton et continue le trace.
L'helper TraceContext dans le runtime élève le contexte de trace de l'appelant vers le contexte par-requête de chaque usine de serveurs. Le contexte est présent sur tous les types de serveurs, API proxy, YAML, et bundle, donc que les spans d'outil et le registre de requêtes puissent corréler un appel de retour au trace d'origine sans aucun code par-outil. Quand la valeur est indéfinie, le trace est sans racine, pas implicitement rattaché à un défaut.
Le chemin d'audit préserve le contexte de trace de bout en bout. Le ChainForge construit le hache de chaque enregistrement d'audit à partir du base64 cru du payload, du hash précédent, et du numéro de séquence. Le contexte de trace est incorporé comme métadonnées recherchables dans l'entrée de log, donc un analyste de sécurité peut suivre le chemin unique d'un agent à travers la passerelle, le spécialiste, et de retour à la passerelle, le tout dans un seul trace.
C'est ce qui fait fonctionner le tableau Live Activity. Chaque ligne montre le serveur MCP, l'outil, l'action sémantique (query, mutation, destructive), le jeton, le résultat, et une décomposition complète de la latence. Vert signifie que l'amont a répondu. Violet signifie que la politique Vinkius a agi en vol. Ambare signifie que l'appelant a eu tort. Rouge signifie que le fournisseur a échoué. Chaque couleur correspond à un propriétaire de défaillance différent, et chaque défaillance porte un trace que l'analyste peut ouvrir pour voir le chemin complet.
Le Voyage de Retour: Comment la Passerelle Réintègre
Quand un agent spécialiste termine son travail, la méthode returnToGateway du SwarmGateway est activée. Ce n'est pas une redirection. C'est une réconciliation d'état. La passerelle compare l'état de reprise incorporé dans le jeton de délégation contre l'état que le spécialiste a retourné, et toutes les marques causales que le spécialiste a touchées sont invalidées dans tout l'essaim.
Le voyage de retour est médiatisé par un outil que la passerelle injecte dans la session du spécialiste. Cet outil n'est pas visible pour l'agent comme une capacité de première. C'est un canal de retour: l'agent l'appelle avec son état final, et la passerelle reprend à partir de là. L'outil est identifié avec _MCPFUSION_handoff_return pour que la couche de session le reconnaisse et active le chemin de retour.
La passerelle réécrit également l'espace de noms des outils du spécialiste. Quand le spécialiste finance expose ses outils, la passerelle les prefixe avec finance. pour que l'agent appelant voie finance.create_invoice et finance.get_balance, pas create_invoice et get_balance. Cela empêche les collisions de noms quand plusieurs spécialistes sont actifs dans la même conversation, et rend le chemin d'audit sans ambiguïté: chaque appel d'outil enregistre de quel espace de noms de spécialiste il vient.
Les Chiffres Qui Importent
Chaque limite dans ce système est nommée. Il n'y a pas de nombres magiques cachés dans les fichiers de configuration. La dérivation est documentée à côté de chaque constante.
| Name | Value | Source |
|---|---|---|
| Session idle timeout | 2 minutes | SessionManager.ts, SESSION_IDLE_TIMEOUT_MS |
| Memory pressure timeout | 30 seconds | SessionManager.ts, SESSION_PRESSURE_TIMEOUT_MS |
| Sessions per token cap | 50 | SessionManager.ts, MAX_SESSIONS_PER_TOKEN |
| Session sweep interval | 15 seconds | SessionManager.ts, SESSION_SWEEP_INTERVAL_MS |
| Redis session TTL | 150 seconds | SessionManager.ts, REDIS_SESSION_TTL |
| Memory warning threshold | 65 percent | SessionManager.ts, MEMORY_WARN_THRESHOLD |
| Memory pressure threshold | 80 percent | SessionManager.ts, MEMORY_PRESSURE_THRESHOLD |
| Connection idle eviction | 30 minutes | ConnectionTracker.ts, IDLE_TIMEOUT_MS |
| DNS cache max entries | 4,096 | SsrfGuard.ts, DNS_CACHE_MAX_ENTRIES |
| Agent pool max | 100 | Limits.ts, AGENT_POOL_MAX |
| Agent keep-alive | 65 seconds | Limits.ts, AGENT_KEEP_ALIVE_TIMEOUT_MS |
| Dispatch time budget | 30 seconds | Limits.ts, DISPATCH_TIME_BUDGET_MS |
| Boot time budget | 5 seconds | Limits.ts, BOOT_TIME_BUDGET_MS |
| Heap cap per isolate | 128 MB | Limits.ts, ISOLATE_MEMORY_LIMIT_MB |
| Session key rotation | 24 hours | StreamingDaemon.ts, SESSION_KEY_TTL_MS |
| Circuit breaker window | 5,000 requests / 5 minutes | Governance config |
| Circuit breaker cooldown | 15 minutes | Governance config |
Le problème de l'essaim n'est pas résolu en rendant les agents plus intelligents. Il est résolu en rendant la couche de session autoritaire. La passerelle possède le jeton de délégation, le cycle de vie de la session, la synchronisation d'état, et le budget de débit. L'agent est l'invité. La passerelle est l'hébergeur. Quand un agent dépasse son temps, la passerelle évite sa session. Quand le pool est plein, la passerelle rejette le handoff. Quand le budget est dépassé, le disjoncteur se déclenche et l'essaim s'arrête.
Le post sur les agents de IA comme nouveaux consommateurs a couvert l'architecture MVA: Model, Presenter, et Tools. Le post sur les V8 isolates a couvert le sandbox et le modèle d'intégrité de snapshot. Le post sur AI governance a couvert les douze surfaces et le disjoncteur. Ce post couvre la couche sur laquelle ils dépendent tous mais ne mentionnent jamais: la couche de session qui empêche cent agents de marcher sur les pieds. Le prochain post de cette série couvrira le capability lockfile, et comment le fichier mcpfusion.lock impose des changements disruptifs avec des diffs git-diffable et des gates de CI.
Les chiffres ci-dessus ne sont pas mes estimations. Ce sont ce que le code impose. Vous pouvez lire Limits.ts, SessionManager.ts, SsrfGuard.ts, et CircuitBreaker.ts dans le runtime cloud. Chaque valeur est nommée, documentée, et dérivée d'une contrainte externe. C'est la différence entre une plateforme qui évolue et une démonstration qui s'effondre.
La gestion des sessions, l'application des quotas et le disjoncteur qui gouvernent des agents concurrents sont répondues avec du code source dans Questions d'IA d'Entreprise.