
Publié 21 sept. 202621 min de lecture
IA Governance: le plan de contrôle derrière chaque appel d'outil de vos agents
Vinkius IA Governance : le plan de contrôle qui attribue chaque appel d'outil MCP à une identité, protège les données en vol, budgétise la dépense des agents et scelle une attestation d'audit chaînée par hash pour le régulateur, l'équipe finance et le page de 3 h.

Par Renato Marinho
Founder · Vinkius
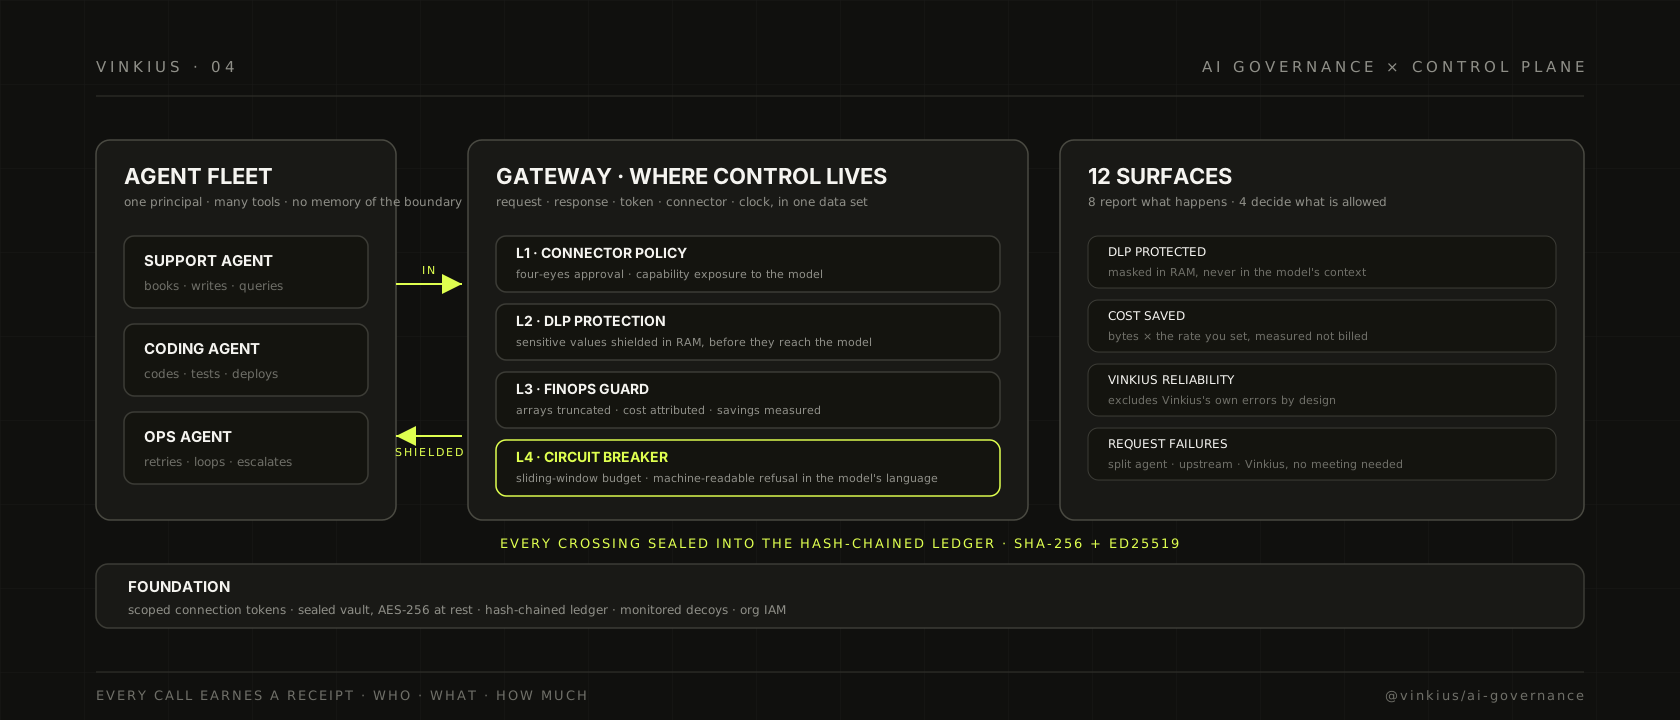
Il y a six mois, je regardais encore des équipes démontrer des agents. Aujourd'hui, j'observe des agents qui agissent. Quelque part entre les deux, le centre de gravité de l'infrastructure agentique a basculé de « le modèle est-il capable de faire la tâche » à « que se passe-t-il quand la réponse cesse d'être une réponse et devient une action ». Un appel d'outil est une écriture dans le monde. Un email part. Une ligne est mise à jour. Une commande est passée. Un fichier est supprimé. Ce qui décide est probabiliste, ce qui exécute ne l'est pas. Chaque incident dans les systèmes agentiques vit dans cet écart, et cet article est là pour le refermer.
J'ai construit Vinkius à partir d'une conviction : un cloud pour agents d'IA n'est jamais fini tant que vous ne pouvez pas répondre à quatre questions sur n'importe quel appel d'outil, à n'importe quel moment, avec la preuve à l'appui. Qui a appelé. Ce qui était permis de se produire. Ce qui a franchi le guichet, et ce qui a été protégé en chemin. Et combien cela a coûté. La réponse à ces quatre questions, c'est le plan de contrôle que nous livrons sous forme de douze surfaces : huit qui racontent ce qui se passe, et quatre qui décident de ce qui est permis. Tout ce qui suit est ce que la plateforme fait aujourd'hui. Les chiffres sont ceux que le système applique ou rapporte, pas ceux que j'aurais souhaité.
Le moment où les agents cessent de parler et commencent à agir
Dans l'entreprise, la gestion d'incidents était calme depuis des années, parce que ce qui cassait était construit par des humains et changeait lentement. Un service a un responsable, un journal de bord des changements, un post-mortem, et une population fixe d'appelants. Quand l'appelant est un modèle, tout cela s'évapore en une décision de conception. Le même agent peut réserver une réunion le matin, écrire du code à midi et interroger une base de production l'après-midi. C'est exactement à cela que servent les systèmes agentiques : un principal, beaucoup d'outils, et aucune mémoire de la frontière entre eux. Les catégories de défaillance changent avec.
Le monitoring classique demande « l'appel a-t-il échoué, et pourquoi ». Avec des agents, il faut poser quatre questions de plus, et chacune a sa propre forme de réponse. L'échec vient-il de l'agent, parce qu'il a envoyé une demande mal formée ou qu'il boucle sur un outil cassé ? Vient-il du service en amont, parce que l'API appelée a renvoyé un 500 ? Vient-il de la plateforme, parce que le guichet lui-même s'est mal comporté ? Et il y a celle que personne ne pose jusqu'à ce que la finance pose la question : tout cela a coûté combien, par appel, par connecteur, par agent, en dollars ?
J'ai lu assez de rapports d'incident, dans ce domaine et dans le mien, pour connaître le motif de la réponse. C'est presque toujours « nous ne savions pas quel agent avait fait quoi, et nous l'avons su après le dommage ». Un appelant non déterministe et un système de journalisation a posteriori forment un mauvais couple. Le journal est une photo des lieux, et le suspect a déjà quitté le bâtiment. La gouvernance est l'architecture qui fait que le suspect, l'arme et l'horodatage sont enregistrés au moment des faits, et pas après.
Ce que la gouvernance de l'IA est réellement
La gouvernance de l'IA, au sens dont l'industrie a besoin, c'est le plan de contrôle qui entoure le trafic des agents vers les outils. Ce n'est pas un moteur de règles au sens traditionnel d'OPA, qui décide au moment du déploiement quelles règles un service reçoit. Ce n'est pas du RBAC, qui décide quel humain peut se connecter. Ce n'est pas un SIEM, qui corrèle des journaux après coup. Tous ces systèmes ont été conçus pour un monde où celui qui agit est une personne ou un pipeline figé.
Ce que fait la gouvernance de l'IA est différent, et il vaut la précision. Elle décide, par appel, si l'action d'un principal non déterministe est autorisée à se produire, sur une machine, contre le système d'un tiers, sous un budget. Et elle garde, pour chaque appel, une attestation qui répond qui, quoi, et combien. Le mot « gouvernance » fait ici un vrai travail, et ce n'est pas un mot de conformité seulement. La conformité est la sortie. L'entrée est un plan de contrôle doté de deux propriétés : l'attribution à la granularité de l'identité, et l'exécution en vol, avant que l'appel ne sorte de votre infrastructure.
Dans Vinkius, ce plan de contrôle porte le nom de gouvernance de l'IA, et il s'organise en douze surfaces. Huit surfaces de rapport racontent ce qui se passe sur le parc de connecteurs que vos agents utilisent. Quatre surfaces de politique décident de ce qui est permis, et elles s'exécutent dans le runtime, sur le chemin de l'appel, pas dans un tableau de bord que vous ouvrez le lundi. La séparation est volontaire. Un tableau de bord sur lequel on ne peut rien faire est du théâtre, et une politique sans attestation est de la peur. Les deux moitiés sont nécessaires, et le produit est leur union.
Pourquoi le guichet est le seul endroit où le contrôle peut tenir
L'argument architectural est court. Vos agents n'appellent pas vos API en amont directement. Ils appellent des outils, et dans Vinkius ces outils sont des connecteurs, des serveurs MCP hébergés que chaque agent du parc atteint par un guichet unique. Le guichet est là où le trafic passe, donc c'est là que le contrôle doit vivre.
Le côté client n'est pas un endroit sûr pour cela. Les garde-fous au niveau du prompt sont fragiles par construction, parce que le modèle peut reformuler pour contourner une règle, et parce qu'un garde-fou qui vit dans le prompt est à une fenêtre de contexte de ne plus exister. Les filtres du fournisseur ne sont pas votre chemin de données, et vous ne pouvez pas tenir un fournisseur responsable du comportement de votre agent. L'analyse a posteriori, le SIEM qu'on greffe plus tard, est un registre de ce qui s'est passé, ce qui est utile, et trop tard pour arrêter ce qui se passe maintenant.
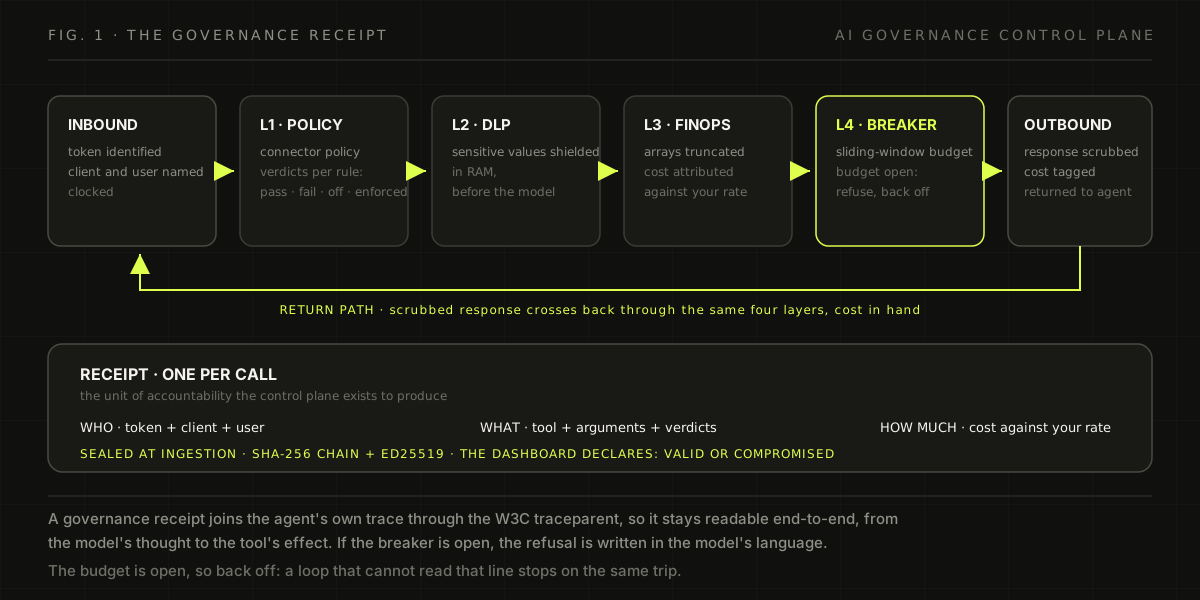
Le guichet voit tout d'un coup : l'appel, la réponse, le token qui a authentifié l'appel, le connecteur visé, et l'horloge. C'est le seul point du système où « qui, quoi, et combien » a une réponse dans un seul jeu de données, et aussi le seul point où une décision peut encore changer l'issue. Chaque appel du parc traverse le guichet deux fois, à l'aller et au retour, et ce sont ces deux traversées qui font la gouvernance.
Deux autres pièces de la plateforme complètent l'argument du guichet. Chaque connecteur tourne dans son propre isolate sandboxé, un design que j'ai détaillé dans comment Vinkius exécute chaque serveur MCP dans un isolate V8, pour qu'un outil hostile ou cassé n'agisse que par des effets que l'hôte possède. Et depuis la version 5.1.0 de notre framework open source, le contexte de trace distribué de l'agent traverse le guichet, si bien que chaque span d'outil s'ancre dans la trace de l'appelant. Ce travail est dans la publication du MCP Fusion 5.1.0 sur la corrélation des traces, et cela compte ici parce qu'une attestation de gouvernance qui ne se rattache pas à la trace de l'agent est une attestation que personne ne peut lire.
Une note d'honnêteté avant la visite : sur le plan gratuit, le tableau de bord de gouvernance de l'IA s'ouvre avec des données d'exemple clairement étiquetées. Vous explorez la forme du plan de contrôle avant de vous engager. L'exécution en direct, le disjoncteur et l'arrêt d'urgence tournent sur les plans payants. Je préfère le dire clairement que laisser le lecteur imaginer que le gratuit fait ce qui est payant.
Huit surfaces qui racontent ce qui se passe
La moitié rapports de la gouvernance de l'IA est celle où je veux passer le plus de temps, parce que c'est la partie que les entreprises testent en premier, et la partie où « nous avons instrumenté nos agents » se révèle souvent une phrase à propos de quatre tableaux de bord et d'une prière.
Mission Control
La surface du haut est la bande de KPIs de tout le parc : appels totaux, latence moyenne, une figure de fiabilité que nous appelons Vinkius Reliability, tokens totaux déplacés, le nombre de valeurs protégées par la prévention de perte de données et le coût économisé par le garde FinOps. En dessous, un thermogramme d'activité agentique sur 30 jours, un graphique du volume et de la latence des appels, et un AI Briefing : un digest généré par un modèle de langage sur ce qui a changé dans votre trafic sur la période. C'est la seule surface délibérément non déterministe dans un plan de contrôle déterministe, et c'est une fonction payante, parce que le briefing est un appel de modèle. Un détail sur lequel je tiens : la figure de fiabilité que vous voyez exclut les erreurs de Vinkius lui-même. Le chiffre répond « à quel point le parc est-il fiable pour vous », pas « à quel point nous sommes fiables ». Nous ne comptons pas nos erreurs contre votre disponibilité.
Agent Activity
La vue par client. Chaque token de connexion de votre organisation apparaît avec son activité : qui est le client, quand il a appelé pour la dernière fois, combien d'appels il a faits. C'est la surface qui répond « quel agent fait quoi ». Un agent qui devrait tourner à l'heure et qui appelle toutes les 90 secondes apparaît ici, et c'est souvent là qu'on repère une boucle déraillée, avant qu'elle ne devienne une facture.
Connector Traffic
La même décomposition, par connecteur. Lequel de vos outils est chaud, lequel est froid, où la latence se concentre. Quand un fournisseur en amont dégrade, c'est cette vue qui sépare le problème du fournisseur du problème de votre parc.
Access Tokens
Le parc de tokens comme inventaire. État, dernier usage, compte d'appels. Celle-ci rend service d'une façon qui surprend : un token de connexion inutilisé depuis 90 jours est une credential permanente que vous avez émise et oubliée, et cette surface existe pour rendre cet oubli visible et actionnable, avec révocation et rotation à un clic.
AI Spend
Le coût, rendu lisible. Dépense estimée, les économies mesurées par le garde FinOps, coût par appel, le retour sur les politiques FinOps, et un journal réparti par connecteur. Le garde attribue le coût à partir d'un tarif par million de tokens que vous fixez, et la valeur par défaut est de 3 dollars par million de tokens. L'enjeu de la surface n'est pas de vous facturer. C'est de montrer quel agent, sur quel connecteur, consomme quoi, parce que la dépense des agents n'a pas la forme d'un coût que vous avez l'habitude de tracer. Ce n'est ni par utilisateur ni par appel. C'est par raisonnement, et elle se multiplie avec chaque retry qu'une boucle ajoute.
Capability Reliability
La fiabilité au niveau de l'outil, pas du service. Chaque capacité qu'un connecteur expose a sa propre latence et son propre comportement de défaillance, et la Tool Health Matrix les trace ensemble : latence contre taux de défaillance, une bulle par outil. Un connecteur peut être parfaitement sain tandis qu'un outil précis à l'intérieur échoue en silence. C'est la différence entre surveiller un produit et surveiller ce que vos agents touchent réellement.
Security Posture
Deux séries chronologiques et un donut. Les séries suivent ce que la couche DLP a blindé et ce que la couche FinOps a tronqué, au fil du temps. Le donut est le Compliance Coverage : la part des politiques de gouvernance actives dans le parc, comptée par catégorie, DLP, FinOps et approbations. C'est le chiffre que le réviseur veut voir, et il est calculé depuis l'état des politiques, pas depuis un questionnaire que vous remplissez.
Request Failures
La chronologie des erreurs, découpée en trois caisses : erreurs Agent, où l'appelant a envoyé quelque chose que l'outil ne pouvait pas honorer, erreurs Upstream, où le tiers derrière le connecteur a échoué, et erreurs Vinkius, où c'est nous qui avons échoué. C'est l'attribution des défaillances dont le début de cet article parlait. Quand un appel échoue, on vous dit de qui c'est l'échec, dans la même vue, sur la même période, sans réunion.
Request Detail : l'attestation
Ouvrez n'importe quel appel individuel et vous tenez l'unité de responsabilité pour laquelle tout le plan de contrôle existe. L'attestation nomme l'identité qui a fait l'appel : le token, le client, et le humain ou utilisateur d'application derrière. Elle liste la politique en vigueur à cet instant, règle par règle, groupée par phase du cycle de vie de l'appel à laquelle chaque règle appartient, avec le verdict de chacune : pass, fail, off ou enforced. Elle montre l'entrée d'audit de l'appel, scellée à l'ingestion dans le registre chaîné par hachage que je décris plus bas. Elle montre la continuité de trace, le contexte W3C qui rattache cet appel à la trace distribuée de l'agent lui-même. Elle découpe la latence entre le temps pris par l'API en amont et le temps ajouté par la couche de gouvernance, si bien que vous savez toujours ce que coûte le plan de contrôle lui-même. Et elle se termine par des actions : bloquer une capacité pour tous les appelants, ou, en Business, l'arrêt d'urgence du connecteur. Un appel, un écran, toute l'histoire.
Quatre surfaces qui décident de ce qui est permis
Connector Policy
La première surface de politique concerne la manière dont un connecteur entre dans votre parc. Les déploiements peuvent exiger une approbation avant d'être actifs, et le produit rattache ce réglage au principe des quatre yeux que l'AI Act de l'UE attend des systèmes à haut risque à l'article 14(5) : une seule personne ne décide pas, toute seule, qu'un nouvel outil à conséquences réelles arrive aux agents. La même surface contrôle comment les capacités sont exposées au modèle, à plat ou groupées, avec un regroupement automatique quand la liste d'outils du connecteur s'allonge, parce que ce que le modèle voit est une surface, et la surface est une décision de design.
Et il y a la zone de danger, que je préfère que vous compreniez plutôt que découviez. Le Global Emergency Halt arrête tous les connecteurs actifs de votre organisation. Il les désactive tous, révoque tous les tokens, et termine toutes les sessions ouvertes, en une seule action synchrone, et la confirmation exige de taper HALT ALL, parce que c'est le bouton qu'on appuie quand quelque chose a très mal tourné et on préfère le parc entier arrêté plutôt que hors de contrôle. Après un arrêt, on peut restaurer, mais les tokens révoqués restent révoqués. Vous les réémettez délibérément. C'est une décision de design que je veux expliciter : la récupération est une nouvelle relation de confiance, pas un rejouage de l'ancienne.
DLP Protection
La prévention de perte de données, dessinée pour le chemin du modèle. Vous nommez des motifs pour des champs sensibles, un email n'importe où dans l'arbre de réponse, un numéro de carte, un champ sur un chemin précis que vous décidez de protéger, et le runtime les exécute sur le chemin de sortie, en masquant la valeur avant que la réponse n'atteigne l'agent. Le blindage se passe en mémoire, entre le service en amont et le modèle, ce qui est la différence entre des données qui ont été masquées et des données qui n'ont jamais été dans le contexte du modèle. Le KPI que vous voyez dans Mission Control, DLP Protected, compte les masquages par période, donc la couche n'est pas seulement là, elle est mesurée.
FinOps Guard
Des garde-fous de coût, pour les raisons de la section AI Spend. Le garde fait trois choses. Il tronque les tableaux au-delà d'un nombre maximum d'éléments, parce qu'une réponse qui renvoie dix mille enregistrements est une facture de tokens, pas une réponse. Il comprime les descriptions d'outils que le modèle lit avant d'agir, le réglage de Toon compression du tableau de bord. Et il attribue le coût à partir du tarif que vous fixez, pour que le garde vous dise, par période, ce qu'il a économisé, en octets et en dollars, face au tarif. La sortie n'est pas une facture. C'est la mesure de l'écart entre ce que l'outil a renvoyé et ce dont l'agent avait besoin, qui est le chiffre qui décide si votre agent peut encore appeler cet outil.
Circuit Breaker
Un budget d'appels en fenêtre glissante par connecteur, avec une valeur par défaut de 5 000 appels toutes les 5 minutes et un délai de refroidissement de 15 minutes, des valeurs que vous ajustez. Quand le budget d'un connecteur est dépassé, le disjoncteur saute, et le saut fait ce que la plupart des garde-fous ne font jamais : il prévient l'agent, dans un refus lisible par machine écrit pour un modèle, que la ressource est ouverte et qu'il doit reculer. Un bon agent respecte cela. Une boucle qui ne lit pas le refus est arrêtée par le même saut, et c'est le point. L'état du disjoncteur est partagé entre les instances du guichet, donc un budget reste un budget, pas une limite par processus qui se réinitialise quand le trafic bouge. Après le refroidissement, il se réinitialise tout seul, ou vous approuvez la reprise depuis le tableau de bord. Le disjoncteur est ce qui empêche un agent déraillé d'emmener l'API d'un tiers, et votre propre facture, avec lui. La couche de session qui maintient le swarm sous contrôle est le sujet de l'article sur les sessions SwarmGateway.
Les fondations : tokens à portée restreinte, coffre scellé, registre chaîné
Les douze surfaces reposent sur des fondations, et c'est dans les fondations que beaucoup de « gouvernance » sont en réalité fines.
La couche d'identité est le token de connexion. Chaque connecteur a ses propres tokens, générés par organisation, montrés une seule fois, signés, et restreints à ce connecteur uniquement. Le token du connecteur email ne touche pas le connecteur de paiement. Chaque attestation nomme le token qui a fait l'appel, donc l'identité n'est pas une théorie, c'est une colonne des données d'audit.
La couche de secrets est le coffre. Les credentials des connecteurs sont chiffrées au repos en AES-256, et la garantie que nous faisons est que même les opérateurs de la plateforme ne peuvent pas les lire au repos. Elles sont injectées seulement au moment de l'exécution, dans l'isolate où tourne le code de l'outil, et l'agent ne voit jamais le secret. C'est la séparation sur laquelle je m'attarde le plus : ce qui décide, le modèle, et ce qui prouve l'autorité, la credential, ne doivent jamais partager un contexte. Un modèle qui peut lire votre mot de passe en amont n'est pas un problème de gouvernance qu'on règle par l'audit. C'est le problème.
La couche d'audit est le registre. Chaque hachage d'appel est scellé à l'ingestion, et le registre est chaîné par hachage : chaque enregistrement porte le hachage précédent et sa position dans la séquence, et la chaîne est signée, SHA-256 avec Ed25519, si bien qu'une manipulation n'est pas un problème de confidentialité, c'est un événement détectable, et le tableau de bord dit si la chaîne est valide ou compromise. L'audit de déploiement est structuré autour de l'article 73 du RGPD, le droit d'accès de la personne concernée, donc quand un régulateur ou un client demande l'historique complet d'un connecteur, la réponse est une seule chaîne exportable et vérifiable, pas un projet.
Et une couche de plus, celle dont je suis le plus fier. Certains connecteurs de notre marketplace sont des leurres surveillés. Ils ressemblent à de vrais outils. Ils ne le sont pas, et ils sont surveillés. Quand un leurre est touché, la plateforme met l'outil en quarantaine, révoque le token, tue les connexions ouvertes et gèle le circuit de paiement, automatiquement. Si un outil devient incontrôlable, ou si un token fuit, le confinement n'attend pas que vous vous en rendiez compte.
Sous tout cela, la couche d'organisation : single sign-on, rôles et équipes personnalisés, comptes de service pour les identités non humaines qui tournent en CI et sur les workloads OIDC, clés API d'organisation, et un journal d'audit de sécurité pour les actions sur l'organisation elle-même. Le plan de contrôle repose sur un modèle d'identité qui sait la différence entre une personne et une machine, et c'est une différence sur laquelle chacune des douze surfaces compte.
Ce que la gouvernance change pour les agents eux-mêmes
Presque toute la conversation sur la gouvernance des agents traite l'agent comme un risque à contenir, et je ne vais pas faire semblant du contraire, parce qu'il l'est. Mais l'autre moitié de l'argument, celle que je mettrais dans un deck de vente, est celle qui, je crois, définit la décennie : la gouvernance est ce qui transforme l'agent de démo en collaborateur.
La confiance est accordée en proportion de la preuve. Un opérateur confiera le poste de nuit, la requête de production, la réconciliation des paiements à un agent, exactement dans la proportion où chaque action qu'il a prise peut être attribuée, budgétée, blindée et vérifiée a posteriori. L'attestation n'est pas un fardeau pour l'agent. C'est la credential qui lui ouvre la plus grande salle.
L'enveloppe d'un agent gouverné est connue. Une politique déterministe autour d'un modèle non déterministe est la seule forme saine pour la production : le modèle planifie dans une boîte, et la boîte est stable. Le refus du disjoncteur est écrit dans la langue du modèle, donc l'agent apprend le budget, et le respecte, au lieu de le découvrir sous forme de facture. La troncature du garde FinOps donne au modèle une réponse de taille raisonnable au lieu d'un bloc de 200 kilo-octets, ce qui est un problème de qualité d'intelligence, pas seulement de coût.
Et l'agent lui-même gagne la capacité qu'aucun système autonome n'a vraiment eu jusqu'ici : montrer son travail. Pour un agent qui va opérer dans des workflows régulés, la trace d'audit n'est pas du surcoût, c'est le produit. L'agent gouverné est le seul agent auquel on peut donner une vraie autorité, et l'agent non gouverné est, à jamais, une démo.
Une observabilité qui parle enfin la langue des agents
Si votre équipe fait déjà tourner Datadog ou Grafana, la forme des surfaces de gouvernance de l'IA vous sera familière, et c'est volontaire. Bandes de KPIs, thermogrammes, descentes au détail, attestations par appel. Ce qui ne l'est pas, c'est ce que le trafic agentique fait au modèle pour lequel ces outils ont été construits.
Datadog mesure un monde où les appelants sont des systèmes qu'on a écrits. La charge a une forme fixe, le coût s'échelonne avec les utilisateurs ou les appels, et une défaillance a un responsable. Le trafic agentique casse les trois hypothèses d'un coup. L'appelant est probabiliste. La charge a la forme du raisonnement, et une boucle de retry la multiplie. Et une défaillance a trois responsables possibles, agent, amont, plateforme, c'est pourquoi la chronologie des échecs se divise en trois caisses au lieu d'une.
Le plan de contrôle pour agents est donc une observabilité avec couche d'exécution, et la couche d'exécution est ce que les systèmes agentiques exigent et que les plateformes construites pour le monde des humains n'ont pas. Chaque appel d'outil est attribué à une identité, le coût est attribué à la granularité du token, les échecs sont attribués à un camp responsable, et la couche de politique agit en vol, avant que l'appel ne sorte du guichet. C'est l'élévation que je voulais dans cet article : prendre la discipline d'instrumentation des plateformes en lesquelles vous avez confiance, et y ajouter les deux propriétés que les systèmes agentiques exigent, l'attribution par appel et l'exécution en vol. Le résultat n'est pas une nouvelle catégorie d'outil. C'est la même catégorie, à la résolution que les systèmes agentiques exigent.
Questions fréquentes
La gouvernance de l'IA est-elle du RBAC avec des étapes en plus ?
Non, et la différence est l'unité de décision. Le RBAC décide quel humain, avec quel rôle, peut atteindre un système. C'est une porte sur l'identité, évaluée une fois. La gouvernance de l'IA décide ce qu'une action, menée par un principal non déterministe à travers un outil précis, est autorisée à faire, à chaque appel, sous un budget, avec la réponse enregistrée. L'un est une porte. L'autre est le tribunal du trafic où chaque action de vos agents est jugée.
Vinkius lit-il les prompts de mes agents ?
Non. Le guichet voit l'appel d'outil : le nom de l'outil, les arguments envoyés, la réponse reçue, l'identité derrière, et l'horloge. Les quatre surfaces de politique sont des couches déterministes de règles et de budget, pas un juge en langage. Si vous voulez qu'un modèle inspecte le modèle, c'est un autre produit, et je ne l'appellerais pas de gouvernance, je l'appellerais second avis.
Que se passe-t-il quand le disjoncteur saute ?
Le trafic du connecteur est refusé avec un avertissement lisible par machine qui dit à l'agent que le budget est ouvert et qu'il doit reculer, pendant une période de refroidissement. Après le refroidissement, le disjoncteur se réinitialise tout seul, ou un opérateur approuve la reprise depuis le tableau de bord. L'état est partagé entre les instances du guichet, donc le budget tient quelle que soit l'instance qui sert l'appel.
Peut-on exporter et vérifier la chaîne d'audit ?
Oui. L'audit de déploiement s'exporte en document, et la chaîne est vérifiable de bout en bout : chaque enregistrement porte le hachage précédent et sa position, la chaîne est signée, et le tableau de bord déclare si elle est valide ou compromise. Elle est structurée autour de l'article 73 du RGPD, donc une demande d'accès de la personne concernée se ramène à un seul artefact.
Qu'est-ce que j'obtiens sur le plan gratuit ?
Le tableau de bord complet, avec des données d'exemple clairement étiquetées, pour que vous appreniez la forme du plan de contrôle. L'exécution en direct, le disjoncteur et l'arrêt d'urgence sont sur les plans payants, et l'AI Briefing est une fonction payante. Je préfère être le fournisseur qui le dit dans un article plutôt que celui qui vous laisse le découvrir sur la page de tarifs.
Le plan de contrôle est le produit
L'écart entre la démo d'agent et l'agent que vous laisseriez agir pendant que vous dormez n'est pas le modèle. C'est le plan de contrôle. Douze surfaces, huit qui racontent et quatre qui décident, sur des tokens à portée restreinte, un coffre scellé, un registre chaîné, et une couche de leurres qui contient le dommage avant vous. Chaque appel reçoit une attestation, et l'attestation répond qui, quoi, et combien, dans l'ordre où un régulateur, une équipe finance ou une alerte à 3 heures du matin le demanderait.
Si vos agents agissent déjà sur vos systèmes, la question n'est plus de savoir si vous pouvez vous offrir la gouvernance. C'est de savoir si vous pouvez vous offrir le jour où vous découvrirez que vous ne l'avez pas.
Pour un aperçu plus approfondi de la manière dont Vinkius a construit le runtime qui rend cette gouvernance possible pour les agents IA, voir Les agents IA sont les nouveaux consommateurs.
Les douze surfaces de gouvernance définies ici sont appliquées avec du code source et des numéros de ligne dans Questions d'IA d'Entreprise.