
Publicado 21 de set. de 202619 min de leitura
Zero cold start para código não confiável: como o Vinkius roda servidores MCP em isolates V8
Por que isolates V8 vencem containers para código edge multi-tenant: restauração de snapshot em ~15 ms, teto duro de 128 MB por tenant, fetch com SSRF pinado e um modelo de integridade de snapshot em quatro camadas, em que uma entrada corrompida é cache miss, não crash, dentro do runtime do Vinkius.

Por Renato Marinho
Founder · Vinkius
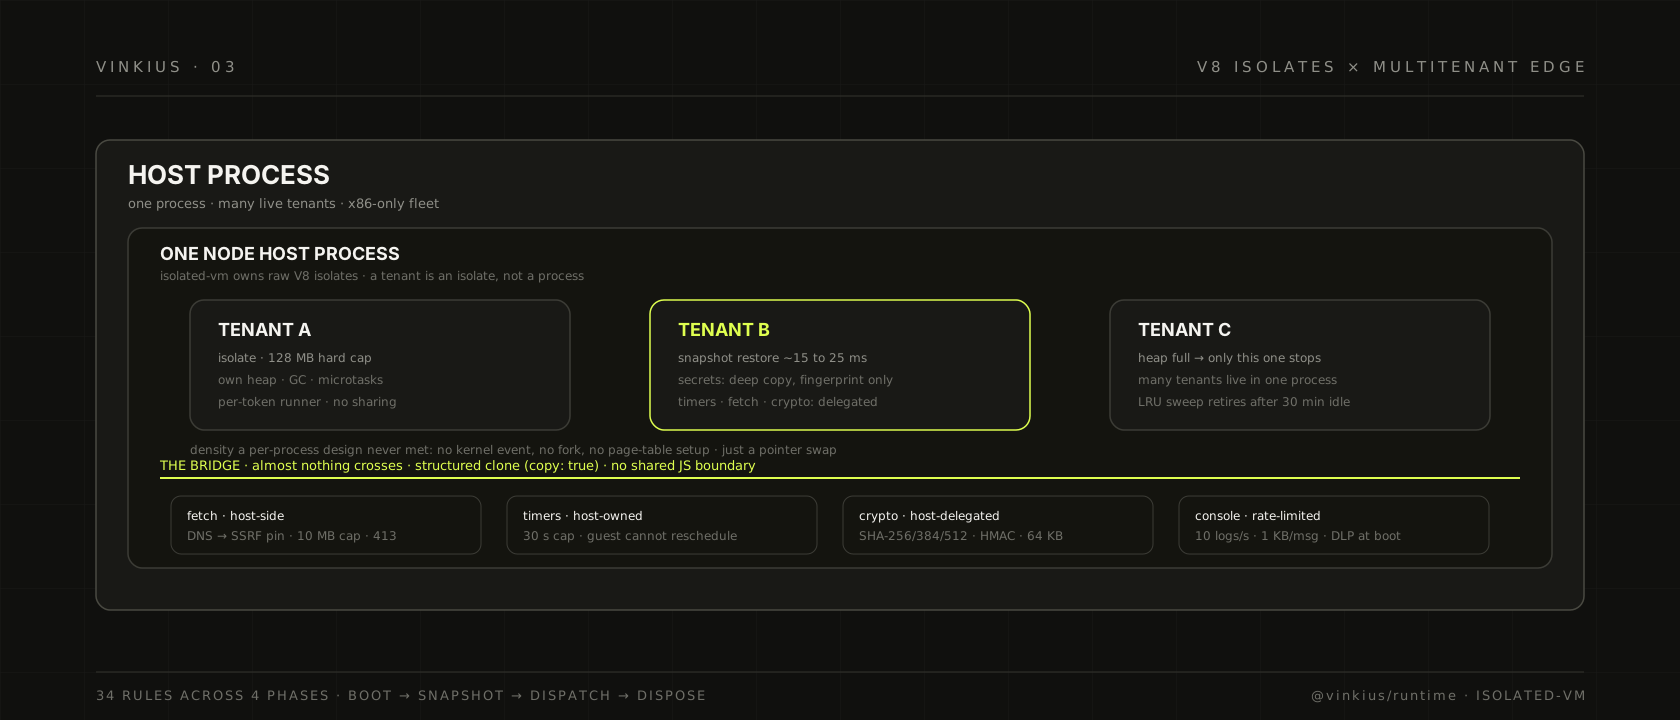
Todo servidor MCP que um cliente publica no Vinkius Cloud é, em algum momento, código de terceiros executando na nossa infraestrutura. Não nosso. Não uma biblioteca que controlamos. Dele. Uma nuvem para agentes de IA só é útil se o cliente puder trazer a própria lógica, os próprios conectores, o próprio glue entre um LLM e os sistemas dele. Com essa capacidade existindo, a pergunta que nenhum material comercial responde vira o problema inteiro de engenharia: como executar JavaScript sem confiança de milhares de tenants em poucos servidores sem dar a nenhum deles um caminho para machucar os outros, a máquina, os vizinhos?
Essa é a pergunta por trás da camada de isolates V8 do runtime da Vinkius, e a parte da arquitetura de que falo menos em público, por isso estou escrevendo aqui. O que segue é como o sistema funciona hoje. Os números são os que o código impõe, não os que eu gostaria que fossem.
Por que não um contêiner por servidor
A primeira resposta que qualquer plataforma multi-tenant alcança é um contêiner por servidor. É limpo, é compreendido e dá isolamento de kernel de verdade. Eu passei um tempo substancial de design desenhando exatamente isso.
Ela morreu na densidade. Clientes do Vinkius Cloud conectam servidores MCP do mesmo jeito que conectam integrações em qualquer SaaS: dezenas por workspace, baratos de criar, baratos de apagar, a maioria parada por dias. Um processo Node.js que botou um runtime de verdade (framework, SDK, polyfills, pool de conexões) carrega um custo fixo de dezenas de megabytes antes de fazer trabalho útil. Multiplique isso por algumas centenas de servidores em uma task e você está brigando com o teto de memória da task antes de uma tool call acontecer. Multiplique por cold starts e construiu uma plataforma onde botar o próprio servidor leva centenas de milissegundos.
A segunda resposta óbvia é muitos processos dentro de um contêiner, um fork por tenant. É pior. Você trocou o limite de kernel por nada: cada processo continua com heap próprio, páginas próprias, GC próprio, e um crash em um processo ainda derruba os irmãos pelo file descriptor compartilhado e pelo init. Gastou a mesma memória da resposta de contêiner e ganhou um modo de falha pior.
Rodei também as contas do meio-termo: um processo Node por workspace, compartilhado entre os servidores de um tenant. Ele cai nas mesmas duas paredes. O footprint fixo de um runtime Node botado é um custo por tenant, compartilhado ou não, e o vazamento de memória ou a fork bomb de um workspace derruba todos os servidores daquele workspace junto. O raio de dano não se localiza.
O que a Cloudflare demonstrou com Workers é a terceira opção: não um processo por tenant, não um contêiner por tenant, um isolate. O V8 foi feito para rodar muitos programas sem confiança dentro de um único processo de navegador, que é exatamente a forma do nosso problema, porque uma aba de navegador é um tenant. O runtime de Workers apoia no mesmo primitivo: um isolate por request, restaurado de um snapshot V8, então o cold start do qual se reclama é na prática só uma restauração de heap. Eu não adotei a plataforma deles. Não posso: nosso gateway é de vida longa e stateful de um jeito que uma página não é, e nós hospedamos a nossa própria frota na AWS onde eu controlo o ritmo de upgrade. Eu adotei a ideia, e construí o lado host sobre o Node.js com o isolated-vm, o binding C++ que deixa um processo Node possuir um isolate V8 cru.
Essa única decisão (um tenant é um isolate, não um processo) é de onde o resto do runtime sai. O que segue é consequência dela.
O que o isolate fornece de fato
Um isolate é um heap: uma região de memória com GC, fila de microtasks própria, globals próprios e um teto duro definido na criação. O isolate que o isolated-vm cria para um tenant recebe 128 MB. Isso não é cota mole que a aplicação força e loga um aviso; é memoryLimit entregue à engine. Quando o heap de um tenant bate nele, o isolate daquele tenant para de ser atendido. Os outros tenants seguem rodando. O globalThis de nenhum tenant é alcançável de outro isolate, porque não existe fronteira JS compartilhada nenhuma. O único tráfego que cruza a fronteira é o que pontemos explicitamente, e pontemos quase nada.
Custo de escalonamento importa mais do que se pensa. Spawn de processo é evento de kernel; fork exige montagem de páginas, um exec e um aquecimento de GC. Trocar isolates dentro de um processo é trocar um ponteiro. É por isso que a Cloudflare consegue colocar a palavra zero ao lado de cold start, e por isso o piso de latência dos servidores edge-deployed mede em milissegundos, não na faixa de 200 a 400 ms que um boot fresh de Node costuma entregar.
A camada de lifecycle diz a propriedade de isolamento mais direto do que eu consigo: um runner por token de conexão, e zero compartilhamento entre tokens. O isolamento de credencial é absoluto. O runner que tem a conexão tem o isolate, o snapshot de segredos e os timers, e nada no grafo do processo alcança atravessando ele.
A troca é que o isolate é um ambiente vazio. O V8 não embala standard library. Não tem fetch, não tem TextEncoder, não tem console, não tem setTimeout, não tem process, não tem Buffer. O primeiro trabalho real do runtime, portanto, não é rodar código de tenant. É construir o ambiente em que o código de tenant roda.
O ambiente vazio
Botar um isolate de tenant começa com o que chamamos de camada de suporte vital: um bundle concatenado de polyfills que restaura a superfície de API Web e Node que o código de tenant espera. A ordem de carga é deliberada, porque cada camada depende da de baixo. Shims de console e process vão primeiro, pois os polyfills de cima logam e inspecionam process. Depois TextEncoder e TextDecoder com UTF-8 e suporte a pares substitutos, porque emoji em argumento de tool não é caso de borda. Depois URL e um URLSearchParams completo de 12 métodos (a entrada do changelog diz que axios, got e @octokit agora funcionam corretamente em edge bundles, e era exatamente esse o ponto). Depois crypto, timers e a stack de rede: Headers, fetch e um shim async-only de XMLHttpRequest, para as bibliotecas HTTP mais antigas que as pessoas colam em conectores não morrerem de xhr is not defined.
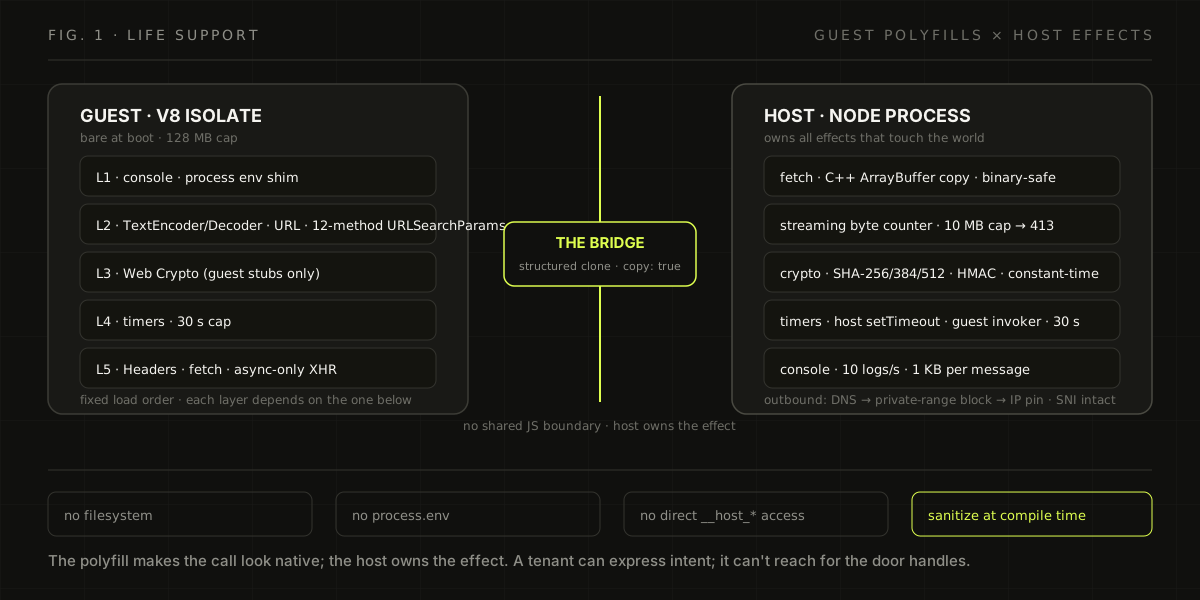
O ponto é o que é real e o que é delegado. Nada que toca o mundo exterior existe dentro do isolate. O fetch num bundle de tenant é polyfill no lado guest, mas o request de verdade acontece no lado host, através do __host_fetch, como uma cópia de ArrayBuffer em C++ pela fronteira: seguro para binário, então imagem ou resposta gzip não vira sem-sentido UTF-8. O crypto.getRandomValues é randomBytes no host, com teto de 64 KB. O crypto.subtle.digest e HMAC, os que a verificação de JWT precisa, também estão no host, e o host verifica assinatura com comparação em tempo constante. Timers são chamadas de setTimeout do host que invocam de volta para o guest por um invoker registrado, com teto de 30 segundos. A regra por trás de tudo: o polyfill deixa a chamada parecer nativa, e o host possui o efeito. Um tenant consegue expressar intenção. Não alcança o sistema operacional.
Argumentos e resultados cruzam a fronteira com clonagem estruturada (copy: true na API do isolated-vm) em vez de JSON.stringify. Você paga a serialização uma vez, em C++, e mantém ArrayBuffer de verdade e objetos tipados dos dois lados. Você não nota isso até perfilar uma tool call que move um payload de 1 MB: o round-trip JSON era a segunda parte mais cara depois da rede.
No lado de compilação, o código de tenant nunca chega ao runtime como fonte. A pipeline de bundle pega a spec do servidor, gera o entrypoint e roda por esbuild (IIFE, plataforma browser, alvo ES2022, minificado), então o que cai no isolate é um arquivo achatarado, sem imports dinâmicos. Um sanitizador de análise estática rejeita as escotilhas antes do bundle ser aceito: acesso direto a bridge __host_*, infiltrações por notação de colchetes em globalThis[...], padrões de bypass por Function.constructor. Bundles são gzipados e com SHA-256. A API permite até 1,5 MB de bundle raw, e o runtime impõe um teto de decompressão de 2 MB com um contador de bytes em streaming que aborta antes que uma bomba GZIP encha o heap. Um detalhe do qual eu me orgulho: o bundle compilado roda uma vez num isolate descartável com todas as bridges stubadas, e essa execução é o que extrai o manifest de tool. O programa se paga no tempo de compilação, não no tempo de request.
E aqui está a parte que desenvolvedor não vê. O bundle não sabe que está na nuvem. A mesma chamada startServer() que bota um servidor via stdio no notebook do desenvolvedor detecta o global __vinkius_edge_interceptor do runtime, entrega as definições de tool por esse interceptor e pula o setup de transporte normal. Um codebase, dois runtimes: você desenvolve local com o framework e publica na nuvem sem um único branch if (inCloud).
Versionamento de protocolo viaja com o runtime, não com o bundle. O gateway fala a release stateless de 2026-07-28 do MCP como dialeto primário e negocia para baixo pela release de 2025 e o transporte SSE de 2024-11-05 como fallback, para que um cliente com um ano de idade ainda fale com um servidor publicado hoje de manhã. O dialeto em que a sessão termina é um handshake, não uma decisão de deploy.
Por que o guest nunca toca a rede
A coisa mais perigosa que um bundle de tenant faz é um request HTTP. O fetch é fonte universal de SSRF: um bundle malicioso, ou só distraído, apontando uma tool para http://169.254.169.254/, o serviço de metadados da AWS, entrega ao agente de IA de um cliente um caminho de leitura para as credenciais da instância. Todo tráfego de saída passa pelo guard de SSRF, e o guard trabalha sobre um princípio: um endereço só é válido enquanto durar a política que o aprovou. Ele resolve DNS antes do request e bloqueia faixas privadas na hora (loopback, 10/8, 172.16/12, 192.168/16, link-local 169.254/16, que é o serviço de metadados, 0/8, e os gêmeos IPv6). Depois fixa o IP aprovado na conexão undici, para que um ataque de rebinding não troque o endereço depois do crivo. E mantém SNI e TLS alinhados com o endereço fixado, porque fixar no nível de socket sem fixar o nome lançaria CERT_ALTNAME_INVALID em cada request. A cache de DNS é limitada a 4.096 entradas e vive no máximo o tempo da conexão pool à qual pertence.
O setting de keep-alive daquela agent pool é a correção mais entediante que eu já publiquei, e fico feliz em escrevê-la. O tempo ocioso padrão da biblioteca undici é 4 segundos, e ela estava fechando sockets pool entre turnos de conversa em segundo plano, então quase toda tool call real pagava um handshake TLS frio. Rodamos em 65 segundos, logo acima da janela de 60 s de ocioso do ALB, e limitamos a pool a 100 sockets por alvo. O p50 das chamadas de saída caiu por um handshake. Correção entediante com p50 é o sonho.
As respostas são streamadas para o isolate com um contador de bytes correndo, teto duro de 10 MB, e um AbortController atravessando o caminho inteiro de dispose: quando um isolate se aposenta, seus requests em voo são abortados na mesma chamada. Quando um dispatch estoura o timeout (os 30 segundos do budget), o erro não é um genérico "o request demorou". Um classificador pergunta o que o isolate estava fazendo no momento do estouro: I/O de upstream em voo, o guest computando, ou pressão de memória? O tool_error que volta para o agente carrega a resposta, junto com uma dica de recuperação. Dono de uma falha (a API upstream do tenant, o código do tenant, ou a plataforma) não é algo que se descobre grepping logs às 3 da manhã.
A saída desse classificador alimenta um anel de atribuição upstream com 32 slots, o mais novo primeiro. O quadro operacional mostra então não só que dispatches estão falhando, mas de quem o upstream é. Quando a API de CRM de um tenant degrada às 2 da manhã, o runtime sabe que é o CRM do tenant, não a plataforma, e o anel segura a evidência o tempo suficiente para o canal de incidente ler.
Provisionar uma vez: o princípio do snapshot
Um boot completo (compilar o bundle, rodar a camada de polyfill, executar o IIFE) custa por volta de 50 a 100 ms no primeiro contato com um deploy. Para o request um, está bom. Para o request 4.000, que é o caso real, não está.
O princípio é que ambiente e programa são artefatos diferentes, e só um deles muda com frequência. A camada de polyfill é estática para um dado deploy: mesma versão de V8, mesma superfície do host. O que muda por request é o código do tenant. Então o snapshot cobre o ambiente, não o programa. O host roda o construtor de snapshot do isolated-vm sobre o ambiente provisionado e cacheia o blob de heap resultante em disco, chaveado por deploy ID e carimbado com a versão de V8 sob a qual foi construído. Na restauração, um isolate novo é criado a partir daquele blob: um ou dois milissegundos para a engine, mais um ou dois para trocar as bridges stubadas pelas verdadeiras, e o próprio IIFE reexecuta no contexto restaurado. Total: 15 a 25 ms, contra 50 a 100 de boot completo, e o trabalho de polyfill acontece exatamente uma vez por deploy. O bundle é reexecutado em vez de snapshotado porque Isolate.createSnapshot() é um método estático que não executa código assíncrono, e nossos IIFEs podem await em nível de topo.
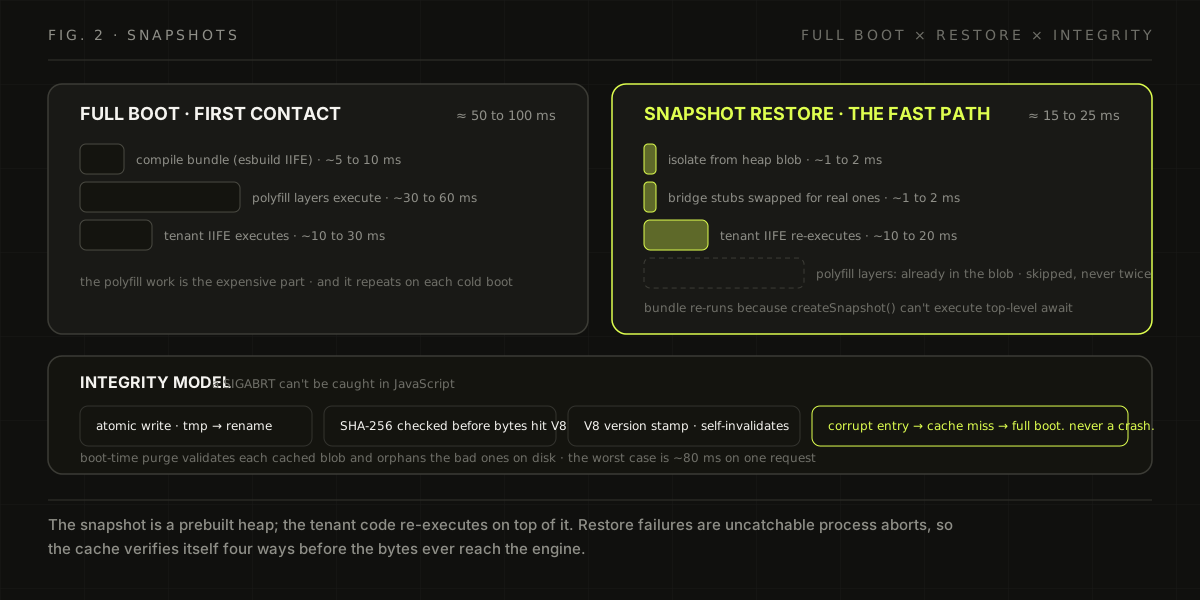
A parte difícil do snapshot não é a velocidade. É o modo de falha. Uma falha de desserialização no V8 é um SIGABRT: o processo morre, o JavaScript não consegue capturar, e um blob corrompido em disco é um crash loop esperando por hora. Restaurar, abortar, reiniciar, restaurar o mesmo blob, abortar de novo. Por isso o modelo de integridade trata a cache como entrada sem confiança. Quatro camadas, em ordem: as gravações são atômicas (o blob cai num arquivo .tmp e é renomeado, metadados primeiro, para que um kill no meio da gravação deixe um par com hash verificavelmente errado, não meio blob); cada blob recebe SHA-256 e o hash é conferido antes que os bytes alcancem o V8; o carimbo de versão V8 faz a cache se invalidar no instante em que o Node sobe na frota; e no boot do processo, uma passada de purge valida os snapshots em disco e apaga os ruins. O invariante de design por trás de tudo: uma entrada de cache corrompida degrada para um boot frio de 100 ms. Nunca para um crash. Esse é o incidente inteiro: 80 milissegundos extras em um request.
A camada de snapshot também é hibernação. Bundles stateful expõem hooks getState e setState com budget de 1 segundo de serialização, então um tenant que guarda um working set em memória pode ter o estado extraído, o isolate aposentado, e o estado injetado de volta no request seguinte. Mesmo mecanismo, direção invertida.
Invariantes: o que uma fase deve à próxima
A camada acima só é tão honesta quanto os invariantes, e invariante apodrece quando vive na cabeça das pessoas. O runner, então, carrega um contrato escrito: 34 regras atravessando as quatro fases (boot, snapshot, dispatch, dispose), ao lado do código que elas governam, lidas em cada review que toca aquele arquivo. As fases são o ciclo de vida; as regras são o que uma fase deve à próxima. A maioria são regras de "não". Não bridge em snapshot. Não timer do host sobrevivendo o isolate. Não dispatch que pula a atribuição de timeout.
O dispose é onde o contrato paga, porque dispose é a única fase em que errar a ordem vaza alguma coisa. Aposentar um isolate é uma sequência fixa de cinco passos: abortar o AbortController primeiro, para que o HTTP pendurado morra com o abort; limpar os timers do host, para que o guest não se reescalone; liberar os handles de referência do isolated-vm na ordem inversa de alocação; liberar o contexto e o isolate; só então apagar a última referência JavaScript, para que nada fixe um heap morto no processo. O conceito é transferência de propriedade: nenhuma bridge pode sobreviver ao isolate ao qual aponta. Pular um passo e sobra um heap vivo, um timer que dispara num cadáver, ou um request que vive mais que o dono. A ordem é carregante, e o contrato diz isso por escrito.
A prevenção de perda de dados recebe o mesmo tratamento na outra ponta do ciclo de vida. Antes de um payload alcançar o código de tenant ele passa num passo de redação carregado no boot, não lazy: um controle que ainda não carregou não existe. Credenciais em trânsito e qualquer coisa que pareça segredo são mascaradas antes de tocar uma linha de log ou um argumento de bridge. Um DLP dentro do código do tenant é um DLP que o tenant desliga; um DLP no lado host da ponte, não.
Contenção por construção
Os limites no runtime não são um muro de números mágicos. Vivem num arquivo, Limits.ts, que documenta, ao lado de cada constante, de onde o número sai. O budget de dispatch de 30 segundos vem de comportamento de usuário: clientes MCP mainstream abandonam tool call em algum lugar entre 30 e 60 segundos, então além de 30 estamos gastando recurso por um resultado que ninguém lê. O keep-alive de 65 segundos espelha a janela de ocioso do ALB. O horizonte de varredura pertence ao tier de 30 minutos de ocioso do connection tracker. Limite é o footprint de uma política, não uma constante: quando a política muda, um arquivo muda, e a derivação continua no registro.
Credenciais seguem a mesma disciplina. O mapa de segredos decodificado de um tenant é injetado no isolate como cópia profunda em __vinkius_secrets: o guest lê, não escreve de volta no host. O runner guarda uma pegada SHA-256 do mapa, não os valores, o que torna a reinjeção num request posterior um no-op barato quando nada mudou. Cada token tem o próprio runner e o próprio isolate; não existe pooling que compartilhe estado de credencial entre tenants, ponto final.
A única forma de token que chega a um isolate é o token de conexão ao vivo, qualquer coisa com prefixo vk_live_. Token de preview, token revogado, token de outro deploy: eles falham na fronteira do runner, antes que bridge alguma seja registrada. A única capacidade que o guest de fato segura é o VINKIUS_TOKEN, exposto ao código de tool do catálogo: ele autentica uma tool de volta na plataforma como o usuário que a possui, escopada para o catálogo daquele usuário. O modelo é capacidade, não senha: cada travessia da fronteira é um direito nomeado, auditado e revogável.
O que um bundle não pode é documentado tão positivamente quanto o que ele pode. Sem filesystem, sem process.env, sem acesso direto a bridge (o sanitizador rejeita em tempo de compilação), 128 MB de heap, timers de 30 segundos, 10 logs por segundo e 1 KB por mensagem na bridge de console, teto de fetch de 10 MB. Quando um tenant cruza a linha financeira, o circuit breaker não devolve um 429 encolhendo os ombros. A camada de quota emite um erro nativo para IA: linguagem simples mandando o LLM parar de tentar de novo e levar o teto de budget ao usuário humano, com um link para o console do Vinkius Cloud onde o dono aprova a retomada. Tempestade de retry é o modo de falha nativo de agentes; a plataforma deve responder ao agente, não só à pessoa atrás dele.
O que a plataforma possui
Tudo isso roda numa frota pequena, deliberadamente x86-only. O pin de x86 é uma restrição que eu assumo publicamente: isolated-vm é um addon nativo, e seus builds ARM são a dependência mais instável que embarcamos. Em x86 ele é entediante, e entediante é o objetivo na camada onde o código de outras pessoas roda.
O processo bota vazio. Nenhuma configuração carrega no start; a primeira conexão de um token puxa a configuração do servidor da API Laravel sob demanda, bota o isolate daquele servidor em JIT, e uma varredura LRU aposenta entradas após 30 minutos de ocioso, para que uma task segure o estado vivo de muitos tenants. O Redis carrega o plano de controle (invalidação, kill switches, notificações de mudança de tool, updates de quota), para que uma mudança de config no console chegue a todas as tasks sem deploy.
Uma última peça da história de segurança mora ao lado dos isolates, e eu fecho nela porque ela mostra a fronteira que desenhamos de propósito: o caminho de auditoria criptográfica. Cada evento de tool call flui para um daemon em streaming de thread única que forja uma cadeia de hash SHA-256 e assina com uma chave de sessão Ed25519, mantida em RAM por 24 horas e certificada pela chave mestra no boot. Após um crash o daemon reprocessa eventos não-ACKed, para que a cadeia nunca tenha lacuna. Cada elo forjado é checkpointado num consumer group de Redis Streams, para que um crash retome do último evento ACKed em vez de re-derivar a cadeia, e os adaptadores de SIEM drenam o mesmo stream atrás de seus próprios circuit breakers: um sink falho fica cercado em vez de entupir o caminho de auditoria. A regra que tornou o daemon necessária cabe numa linha do fonte: V8 nunca toca em cripto. Código de tenant consegue calcular hash através das bridges do host, mas não assina, certifica ou forja nada. A trilha de auditoria é algo que a plataforma faz ao runtime, não algo que os tenants do runtime alcançam.
A direção
A camada de isolates hoje é a história stateless, rápida, teto duro: botar em um ou dois milissegundos, teto em 128 MB, aposentar na varredura, e deixar o snapshot carregar a parte pesada. A direção aberta é a stateful: estado de tenant de vida mais longa nos hooks de hibernação, packing mais denso de isolates vivos por task, e equipes trazendo seus próprios catálogos de conectores para o marketplace sem esperar a nossa CI.
Eu não acho que isolates V8 são a resposta final para código multi-tenant edge. São a resposta para a forma que essa plataforma tem, e a forma é onde eu quero que ela continue: tenants baratos, tetos duros e boot em escala de milissegundos, porque a paciência de um agente é medida em segundos, e a confiança dele também. O cold start zero da Cloudflare é uma frase que dá para projetar, não um slogan que dá só para admirar. É um isolate, um snapshot, uma cadeia de integridade e uma série de decisões sem glamour sobre quem possui os timers. O código atrás deste post é o runtime que segura os servidores MCP no cloud.vinkius.com, e o trabalho de tracing que amarra os tool spans em traces distribuídos está no post do MCP Fusion 5.1.0. A direção stateful para a qual essa plataforma se move é a camada de sessões em si: como o SwarmGateway coalesce sessões de agentes sobrepostas e aplica invalidação causal a estado obsoleto. A arquitetura completa está no post sobre sessões do SwarmGateway.
O sandbox de isolate V8 e sua sequência de inicialização de 12 passos são abordados com código-fonte em Perguntas sobre AI Empresarial.