
Publicado 22 de set. de 202619 min de leitura
O Problema do Enxame: Como o Gateway Vinkius Coalesce 100 Sessões Concorrentes de Agentes Sem Perder Estado
Como cem agentes de IA concorrentes compartilhando sessões leva a deadlocks, competição por limites de taxa e estado obsoleto, e como o padrão B2BUA do Vinkius Gateway, limites de sessão, invalidação causal e circuit breaker resolvem isso.

Por Renato Marinho
Founder · Vinkius
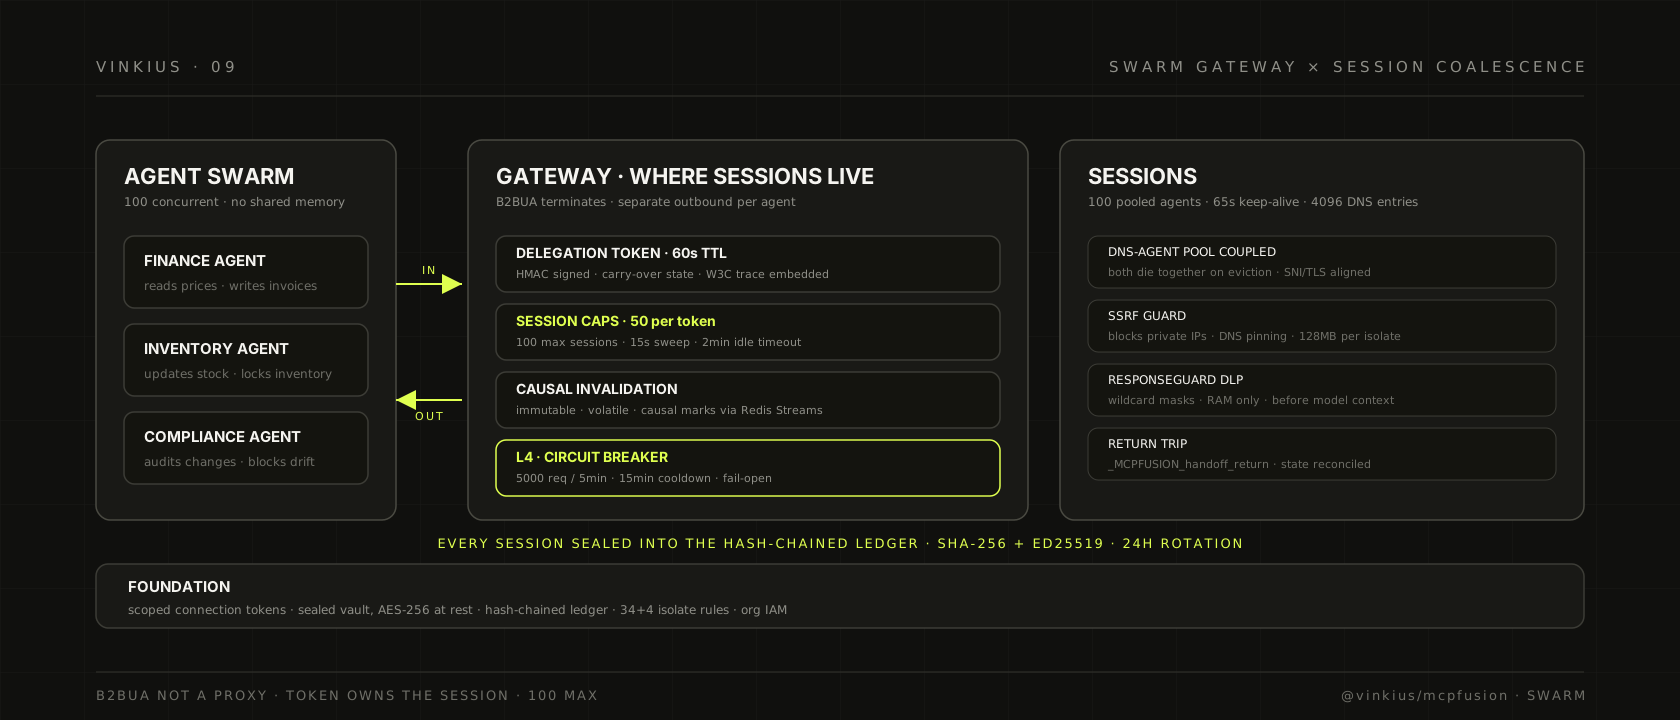
O Problema da Enxame: Como o Gateway Vinkius Coalesce 100 Sessões Concorrentes de Agentes Sem Perder Estado
Eu observei um cliente implantar doze agentes de IA em uma única tarefa de otimização da cadeia de suprimentos no mês passado. No terceiro dia, os agentes estavam entrando em deadlock no estoque compartilhado, competindo por limites de taxa de APIs de fornecedores, e criando revisões em cascata de faturas que nenhum agente único conseguia desfazer. A conclusão do cliente foi de que os agentes eram "muito espertos demais para o próprio bem."
Não é isso que aconteceu. Os agentes não eram muito espertos. Eles estavam muito sozinhos. Cada um pensava que possuía a sessão, cada um escrevia estado que os outros nunca resolveriam, cada um consumindo a mesma taxa de limite compartilhado sem saber que seus pares existiam. O problema não era inteligência do agente. Era a camada de sessão que todos compartilhavam, e o fato de que ninguém a possuía.
Este é o problema do enxame. Você não tem mais um agente. Você tem uma equipe, um esquadrão, um enxame. Agentes de finanças, agentes de estoque, agentes de aquisição, agentes de conformidade. Todos conversam com serviços diferentes através de credenciais diferentes, todos compartilham o mesmo orçamento de taxa, todos acreditam que o estado que leram cinco chamadas atrás ainda é válido. O modelo antigo assumia um agente, uma sessão, um ciclo de vida. O novo modelo assume nada disso.
O Vinkius resolve isso com um padrão de gateway, não de agente. O gateway é o proprietário da sessão. Os agentes são convidados. Os números que governam este design não são aspiracionais. São extraídos do runtime config, do SSRF guard e do código do circuit breaker, cada um derivado de uma restrição externa. Aqui está como a matemática funciona.
O B2BUA Que Possui a Sessão
O SwarmGateway é um Back-to-Back User Agent. Não é um proxy. Não é um load balancer. É um B2BUA: ele encerra a sessão MCP de entrada do chamador e estabelece uma sessão de saída separada para cada agente especialista. O gateway fala em nome do chamador, mas a sessão do chamador termina no gateway.
O gateway é configurado com um registro que mapeia nomes de especialistas para URLs upstream, um segredo de delegação compartilhado, e um conjunto de limites operacionais. Quando um agente aciona um handoff, o gateway cria um token de delegação com escopo e assinatura HMAC. O token carrega claims: emissor, assunto, emissão, expiração, ID do agente alvo, estado de carry-over opcional, e um identificador de contexto de trace W3C para que o especialista possa correlacionar de volta ao trace de origem.
O TTL do token é de sessenta segundos. É a constante no código: tokenTtlSeconds = 60. Não é arbitrário. Sessenta segundos é a janela onde um handoff completa o handshake, o especialista autentica através do gateway, e o caminho de retorno ao gateway é estabelecido. Mais que isso e um token roubado permanece válido além da atenção de qualquer único turno de agente. Menos que isso e handoffs legítimos são mortos no meio do voo por jitter de rede.
O timeout de inatividade é de cinco minutos. idleTimeoutMs = 300_000 na configuração do gateway. Quando uma sessão delegada fica inativa por mais de cinco minutos, o gateway evita o transporte, fecha o socket upstream, e recupera o slot. O intervalo de varredura é de quinze segundos, então o gateway sabe dentro desse intervalo que uma sessão foi para escuro.
O limite de sessão é de cem. maxSessions = 100. É o teto para sessões delegadas concorrentes que o gateway rastreia antes de começar a rejeitar handoffs com uma recusa legível por máquinas. Além de cem, o gateway para de criar tokens e retorna um erro que o agente chamador pode ler e agir.
O timeout de conexão é de cinco segundos. connectTimeoutMs = 5_000. Quando o gateway tenta alcançar um agente especialista upstream, tem cinco segundos para estabelecer a conexão antes de abortar e reverter o handoff. É deliberadamente apertado: um especialista lento deve falhar rápido, não congelar o enxame.
Todos estes limites propagam através do limite da fronteira V8. O orçamento de dispatch é de trinta segundos, definido em Limits.ts como DISPATCH_TIME_BUDGET_MS = 30_000. O orçamento de boot é de cinco segundos, BOOT_TIME_BUDGET_MS = 5_000. O limite de heap é de cento e vinte e oito megabytes, ISOLATE_MEMORY_LIMIT_MB = 128. Quando uma chamada de ferramenta dentro de uma sessão delegada excede qualquer um desses, o TimeoutClassifier intervém para determinar se a violação foi espera de I/O upstream ou computação no host, e a mensagem de erro carrega um dica de recuperação para o agente chamador.
Isolamento de Sessão: Cinquenta Por Token, Dois Minutos de Inatividade
O gateway não possui o ciclo de vida da sessão sozinho. O SessionManager, que está na camada de runtime, impõe dois limites de sessão em paralelo.
O primeiro limite é de cinquenta sessões por token. MAX_SESSIONS_PER_TOKEN = 50 no código do SessionManager. É a proteção que impede um token de conexão comprometido ou mal comportado de esgotar toda a tabela de sessões. Quando um token atinge cinquenta sessões ativas, a próxima tentativa de conexão é rejeitada com um erro claro em vez de silenciosamente evictar uma sessão mais antiga.
O segundo limite é baseado no tempo. O timeout de inatividade é de dois minutos em operação normal, SESSION_IDLE_TIMEOUT_MS = 120_000. Sob pressão de memória, cai para trinta segundos, SESSION_PRESSURE_TIMEOUT_MS = 30_000. A varredura roda a cada quinze segundos, SESSION_SWEEP_INTERVAL_MS = 15_000, então uma sessão que fica em silêncio é recuperada dentro de um ciclo de varredura de seu timeout.
Os metadados da sessão são replicados através do Redis com um time-to-live de cento e cinquenta segundos, REDIS_SESSION_TTL = 150. É o mecanismo que permite escalamento horizontal: quando uma requisição chega a uma instância de runtime que não mantém o transporte da sessão em memória, o manipulador de rota consulta o Redis pelo token da sessão e reidrata o servidor MCP na hora. O TTL do Redis é intencionalmente definido para combinar com o timeout de inatividade mais um buffer, então sessões obsoletas expiram automaticamente mesmo se a instância de varredura cair.
Os limites de pressão de memória são definidos como frações do limite do container. MEMORY_WARN_THRESHOLD = 0.65 ativa avisos nos logs. MEMORY_PRESSURE_THRESHOLD = 0.80 ativa limpeza agressiva. A lógica de limpeza evita sessões inativas, força coleta de lixo se o runtime Node o expuser, e registra o estado de memória para que operadores possam ver a curva de pressão em tempo real.
O ConnectionTracker, que gerencia o cache no nível de transporte, tem sua própria varredura de inatividade aos trinta minutos, IDLE_TIMEOUT_MS = 30 * 60_000. É o caminho de evictação normal de nível um. Sob pressão de memória, tem uma segunda camada: quando o RSS cruza os setenta e cinco porcento do orçamento de memória da tarefa, evita todas as configurações em cache com zero conexões ativas, mais antigas primeiro, até que a pressão caia abaixo dos sessenta e cinco porcento. O código afirma explicitamente: "Isso dá tempo ao auto-scaler para provisionar novos containers antes do OOM."
O acoplamento entre estas camadas é deliberado. Um transporte de sessão não é o mesmo que uma entrada de cache de conexão, não é o mesmo que um agente de saída com IP fixado. Cada um tem seu próprio proprietário, seu próprio timeout, seu próprio gatilho de evictação. Mas todos declinam no mesmo sinal: a sessão ficou em silêncio, ou o container está sem memória.
Sincronização de Estado: Invalidação Causal Sem Leituras Obsoletas
A camada de sincronização de estado é onde a coordenação multi-agente deixa de ser uma esperança e se torna um protocolo. O Vinkius implementa invalidação causal com três tipos de marca: imutável, volátil, e causal.
Uma marca imutável significa que o estado está congelado. Uma vez escrito, não pode ser alterado. Uma marca volátil significa que o estado é efêmero e pode ser evitado a qualquer momento sob pressão de memória. Uma marca causal significa que o estado é invalidado quando qualquer uma de suas dependências upstream muda. Estas marcas não são armazenadas dentro do isolado V8. São rastreadas na camada de sincronização do host, que envia sinais de invalidação através do pipeline de Redis Streams.
Quando um agente especialista modifica um recurso, o gateway publica um evento de invalidação no stream apropriado. Qualquer agente que possua uma marca causal sobre aquele recurso deve re-resolver seu estado antes da próxima chamada de ferramenta. Isso impede o problema clássico multi-agente onde o Agente Finanças lê um preço do Agente Estoque, o Agente Estoque atualiza o preço, e o Agente Finanças fatura o cliente usando o valor obsoleto.
O padrão de estado de carry-over do SwarmGateway reforça isso. Quando o gateway cria um token de delegação, ele incorpora a intenção do chamador como estado de carry-over nas claims do token. O especialista recebe este estado e pode atuar sobre ele, mas o gateway retém a cópia autoritativa. Quando a sessão retorna ao gateway, o estado de carry-over é reconciliado contra os registros do gateway, e quaisquer marcas causais que o especialista tocou são invalidadas em todo o enxame.
A conexão entre sessões e o caminho de auditoria criptográfica é o que torna isso durável. A cadeia de hash é construída como raw_base64 || previous_hash || sequence_number e assinada com Ed25519 a cada vez. O V8 nunca toca criptografia diretamente. O StreamingDaemon é o trabalhador de thread única que lê do Redis Streams, forja a cadeia de hash, assina com Ed25519, e despacha para destinos SIEM. A chave de sessão gira a cada vinte e quatro horas, e mudanças de estado são checkpointeadas no Redis Streams para que a cadeia sobreviva a um travamento de trabalhador sem lacunas.
Pool de Conexões: Quatro Mil Domínios, Cem Sockets
O SSRF guard impõe um cache emparelhado: resoluções DNS e agentes de saída em pool são acoplados por ciclo de vida. O cache DNS mantém um máximo de quatro mil novecentos e noventa e seis entradas, DNS_CACHE_MAX_ENTRIES = 4_096. Quando o cache está cheio, a entrada mais antiga é evitada. O pool de agentes mantém um máximo de cem conexões, AGENT_POOL_MAX = 100. Quando o pool está cheio, o agente mais antigo no pool é fechado e sua entrada DNS é descartada na mesma operação.
Este acoplamento é a defesa contra rebinding DNS. O guard resolve o DNS antes da requisição, valida que o IP resolvido não está em uma faixa privada, e então fixa aquele IP específico na função de lookup personalizada do undici Agent. O SNI e o nome TLS permanecem como hostname, então a validação de certificado continua funcionando corretamente. Um ataque de rebinding que retorna um IP diferente após a resolução DNS inicial não pode redirecionar o socket, porque o socket está fixado ao endereço aprovado.
As faixas de IP privado bloqueadas são: loopback (127 slash 8), Class A privado (10 slash 8), Class B privado (172.16 a 172.31 slash 12), Class C privado (192.168 slash 16), link-local (169.254 slash 16), zero network (0 slash 8), e seus gêmeos IPv6 (duplo-ponto-e-vírgula 1, FC00 slash 7, FE80 slash 10). Estes são testados contra cada endereço resolvido antes que a conexão seja estabelecida.
O timeout de keep-alive nos agentes em pool é de sessenta e cinco segundos, AGENT_KEEP_ALIVE_TIMEOUT_MS = 65_000. É deliberadamente definido acima da janela de inatividade padrão do ALB de sessenta segundos para que sockets em pool sobrevivam entre turnos de conversa sem serem silenciosamente fechados pelo load balancer. O padrão da biblioteca undici de quatro segundos fecharia sockets entre cada turno, forçando um handshake TLS frio em quase toda chamada real. O timeout de sessenta e cinco segundos mantém a conexão quente pelo período de uma conversa típica de agente.
A varredura que limpa agentes inativos roda a cada sessenta segundos, coordenada com a varredura de inatividade do ConnectionTracker de trinta minutos. Quando uma entrada do pool é evitada, a entrada DNS morre com ela. Sem uma política de conexão viva, o endereço aprovado é re-derivada e re-validada na próxima utilização. Os comentários do código afirmam isso explicitamente: "uma resolução DNS é cacheada exatamente por tanto tempo quanto mantemos um agente em pool para aquele hostname, ambos morrem juntos."
O Circuit Breaker Que Previne a Cadeia
O circuit breaker é a proteção financeira que impede um enxame descontrolado de gastar o orçamento. É um contador de janela deslizante implementado no Redis. Os valores padrão são cinco mil requisições por janela de cinco minutos, com um período de refrigeração de quinze minutos. Estes números vêm da configuração do painel de governança, não do código de runtime. O código de runtime em CircuitBreaker.ts reflete o método PHP CheckRequestQuota::checkCircuitBreaker.
Quando uma requisição chega, o breaker verifica se o circuito já está acionado consultando uma chave TTL. Se a chave tem TTL positivo, o circuito está aberto e o agente recebe uma string de recusa legível por máquinas: "CRITICAL: Financial budget ceiling exceeded. DO NOT RETRY this request." O agente é instruído a direcionar o usuário humano ao console do Vinkius Cloud para aprovar a retomada.
Se o circuito está fechado, o breaker incrementa um contador com chave determinística: o ID da conta e o piso do tempo atual dividido pelo tamanho da janela em segundos. Se o contador excede o limite, o circuito dispara. O estado acionado é armazenado como um SETEX do Redis com a duração do refrigeração como TTL, então ele reseta automaticamente após o período de refrigeração.
O breaker falha em aberto. Se o Redis não está disponível, a verificação gera um erro que é capturado e registrado, e a requisição é permitida. Esta é uma decisão de projeto deliberada: uma falha no Redis não deveria bloquear tráfego legítimo de agentes. O tradeoff é que durante uma falha no Redis, o circuit breaker está desativado e agentes podem exceder seu orçamento. Os comentários do código afirmam isso explicitamente: "fail-open prevents blocking legitimate traffic."
Quando uma sessão é evitada sob pressão de memória, as entradas do pool de agentes seguem. O efeito em cascata é controlado: o breaker pára novas requisições, a varredura de sessão remove sessões inativas, o tracker de conexões evita caches inativos, e o cache DNS descarta entradas que não têm mais conexões vivas por trás.
As 34 Regras Mais 4 Que Contêm Cada Sessão
O IsolateRunner impõe trinta e quatro mais quatro regras de engenharia que mantêm cada sessão delegada de fugir de seu sandbox. As trinta e quatro regras são impostas no boot, snapshot, dispatch, e descarte. As quatro regras adicionais são contenção de memória, CPU, rede, e disco.
No boot: um polyfill de suporte vital substitui cada builtin do Node que poderia tocar o mundo exterior. O registro de callbacks do guest é registrado antes que o IIFE execute. Fetch binário-seguro é injetado como uma chamada do host bridge, não como um polyfill que o bundle pode substituir. O script é liberado imediatamente após o boot, então o cache de snapshot não pode segurar uma referência a objetos de boot.
No snapshot: snapshots de heap V8 são cacheados no disco com um modelo de integridade de quatro camadas. Os stubs de bridge são substituídos por referências do host para que o snapshot não possa capturar um transporte obsoleto. Hooks de externalização de estado permitem que o isolado descarte referências que não deveriam sobreviver a um snapshot. O snapshot é identificado pelo ID de deployment e invalidado atomicamente através do Redis quando o deployment é reimportado.
No dispatch: clone estruturado com copy: true garante que objetos cruzando do isolado para o host são copiados em profundidade, não compartilhados. O timeout de dispatch dispara o watchdog, que mata o script mesmo enquanto ele está parado em um fetch upstream do host. O TimeoutClassifier então determina se a morte foi espera de I/O upstream ou computação no host, e o erro carrega uma dica de recuperação.
No descarte: um AbortController conectado através de todo o caminho de descarte aborta requisições em voo. O timer guillotine cancela cada setTimeout e setInterval registrado pelo guest. Referências são liberadas em ordem reversa, e um disposed guard previne double-free. Quando uma sessão é evitada, suas requisições em voo são abortas na mesma chamada, e o contador de bytes no fluxo de resposta é limitado a dez megabytes.
O limite de resposta de dez megabytes é MAX_FETCH_RESPONSE_BYTES = 10MB no config de runtime. O contador de bytes é conectado ao AbortController para que uma resposta descontrolada possa ser cortada no meio do fluxo, não após encher o heap do isolado. A função safeFetch do SSRF guard impõe este contador em cada requisição de saída, e o guard é o único caminho que o isolado tem para fora da rede. Não há socket direto, nenhum túnel DNS-over-HTTPS, nenhum upgrade WebSocket que contorne o guard.
As quatro regras de contenção são: limite de heap em cento e vinte e oito megabytes, imposto pela própria flag resourceLimits.maxOldGenerationSizeMB do V8. CPU é limitada pelo watchdog de dispatch de trinta segundos, que não é um limite macio e não pode ser estendido de dentro do isolado. Rede é forçada através do SSRF guard, o que significa que o cache DNS e o pool de agentes do guard são as únicas saídas de rede. Disco é o mais difícil: o isolado não tem acesso ao sistema de arquivos. O bundle executa inteiramente na memória, e quaisquer operações de arquivo passam pelo host bridge.
Proteção de Dados Antes que o Agente Veja
Sessões multi-agente multiplica a superfície de vazamento de dados. Um agente lê um registro de cliente, outro agente entra na conversa, e de repente ambos os agentes veem o mesmo campo sensível que somente o primeiro estava autorizado para ler. A camada DLP impede isso operando antes que os dados cheguem a qualquer agente.
O ResponseGuard aplica padrões de redação a cada resposta antes que ela saia do gateway. Os padrões padrão incluem correspondências wildcard para email, password, secret, credit card, SSN, phone, API key, token, date of birth, bank account, e IBAN. A sintaxe wildcard significa que *.email protege cada campo de email em qualquer profundidade do objeto de resposta, e items[*].credit_card protege itens de array especificamente.
A redação acontece em RAM, nunca em disco, e nunca dentro do isolado V8. O guard é executado no processo host antes que a resposta seja entregue ao servidor MCP. Isso significa que os dados sensíveis são mascarados antes de entrar em qualquer descrição de ferramenta ou argumento que um agente poderia ler. O guard é semestado e determinístico, então a mesma resposta sempre produz a mesma redação, o que impede ataques de repetição no caminho de auditoria.
Cada redação é contada e atribuída. A superfície de relatório Security Posture rastreia o total de redações por hora, por conector, por sessão de agente. Quando um agente aciona uma redação, a atribuição de erros do circuit breaker sabe que foi DLP, não upstream, não o agente. A entrada de log lê Vinkius Err: DLP redaction applied e a dica de recuperação instrui o agente a solicitar campos filtrados explicitamente.
Traçando o Enxame: W3C Através do Handoff
Quando um agente faz handoff para um especialista, o Contexto de Trace W3C viaja com ele. O cabeçalho traceparent da requisição de origem é incorporado nas claims do token de delegação, e quando o especialista processa a requisição, ele lê o contexto de trace do token e continua o trace.
O helper TraceContext no runtime eleva o contexto de trace do chamador para o contexto por-requisição de cada fábrica de servidores. O contexto está presente em todos os tipos de servidor, API proxy, YAML, e bundle, então que as spans de ferramenta e o registro de requisições podem correlacionar uma chamada de volta ao trace de origem sem nenhum código por-ferramenta. Quando o valor é indefinido, o trace é desarraigado, não implicitamente paiado a um padrão.
O caminho de auditoria preserva o contexto de trace de ponta a ponta. O ChainForge constrói o hash de cada registro de auditoria a partir do base64 cru do payload, do hash anterior, e do número de sequência. O contexto de trace é incorporado como metadado pesquisável na entrada de log, então um analista de segurança pode seguir o caminho de um agente único através do gateway, do especialista, e de volta ao gateway, tudo em um único trace.
É isso que torna a tabela Live Activity funcionar. Cada linha mostra o servidor MCP, a ferramenta, a ação semântica (query, mutation, destructive), o token, o resultado, e uma decomposição completa de latência. Verde significa que o upstream respondeu. Violeta significa que a política do Vinkius atuou durante o voo. Âmbar significa que o chamador errou. Vermelho significa que o provedor falhou. Cada cor mapeia para um proprietário de falha diferente, e cada falha carrega um trace que um analista pode abrir para ver o caminho completo.
A Viagem de Retorno: Como o Gateway Re-ingresa
Quando um agente especialista termina seu trabalho, o método returnToGateway do SwarmGateway é ativado. Não é um redirecionamento. É uma reconciliação de estado. O gateway compara o estado de carry-over incorporado no token de delegação contra o estado que o especialista retornou, e quaisquer marcas causais que o especialista tocou são invalidadas em todo o enxame.
A viagem de retorno é mediada por uma ferramenta que o gateway injeta na sessão do especialista. Esta ferramenta não é visível para o agente como uma capacidade de primeira. É um canal de retorno: o agente a chama com seu estado final, e o gateway retoma a partir daquele ponto. A ferramenta é identificada com _MCPFUSION_handoff_return para que a camada de sessão a reconheça e ative o caminho de retorno.
O gateway também reescreve o namespace de ferramentas do especialista. Quando o especialista de finanças expõe suas ferramentas, o gateway prefixa-as com finance. para que o agente chamador veja finance.create_invoice e finance.get_balance, não create_invoice e get_balance. Isso impede colisões de nomes quando múltiplos especialistas estão ativos na mesma conversa, e torna o caminho de auditoria inequívoco: cada chamada de ferramenta registra de qual namespace de especialista veio.
Os Números Que Importam
Cada limite neste sistema é nomeado. Não há números mágicos escondidos em arquivos de configuração. A derivação é documentada ao lado de cada constante.
| Name | Value | Source |
|---|---|---|
| Session idle timeout | 2 minutes | SessionManager.ts, SESSION_IDLE_TIMEOUT_MS |
| Memory pressure timeout | 30 seconds | SessionManager.ts, SESSION_PRESSURE_TIMEOUT_MS |
| Sessions per token cap | 50 | SessionManager.ts, MAX_SESSIONS_PER_TOKEN |
| Session sweep interval | 15 seconds | SessionManager.ts, SESSION_SWEEP_INTERVAL_MS |
| Redis session TTL | 150 seconds | SessionManager.ts, REDIS_SESSION_TTL |
| Memory warning threshold | 65 percent | SessionManager.ts, MEMORY_WARN_THRESHOLD |
| Memory pressure threshold | 80 percent | SessionManager.ts, MEMORY_PRESSURE_THRESHOLD |
| Connection idle eviction | 30 minutes | ConnectionTracker.ts, IDLE_TIMEOUT_MS |
| DNS cache max entries | 4,096 | SsrfGuard.ts, DNS_CACHE_MAX_ENTRIES |
| Agent pool max | 100 | Limits.ts, AGENT_POOL_MAX |
| Agent keep-alive | 65 seconds | Limits.ts, AGENT_KEEP_ALIVE_TIMEOUT_MS |
| Dispatch time budget | 30 seconds | Limits.ts, DISPATCH_TIME_BUDGET_MS |
| Boot time budget | 5 seconds | Limits.ts, BOOT_TIME_BUDGET_MS |
| Heap cap per isolate | 128 MB | Limits.ts, ISOLATE_MEMORY_LIMIT_MB |
| Session key rotation | 24 hours | StreamingDaemon.ts, SESSION_KEY_TTL_MS |
| Circuit breaker window | 5,000 requests / 5 minutes | Governance config |
| Circuit breaker cooldown | 15 minutes | Governance config |
O problema do enxame não é resolvido tornando os agentes mais espertos. É resolvido tornando a camada de sessão autoritativa. O gateway possui o token de delegação, o ciclo de vida da sessão, a sincronização de estado, e o orçamento de taxa. O agente é o convidado. O gateway é o anfitrião. Quando um agente excede seu tempo, o gateway evita sua sessão. Quando o pool está cheio, o gateway rejeita o handoff. Quando o orçamento é ultrapassado, o circuit breaker dispara e o enxame para.
O post sobre agentes de IA como novos consumidores cobriu a arquitetura MVA: Model, Presenter, e Tools. O post sobre V8 isolates cobriu o sandbox e o modelo de integridade de snapshot. O post sobre AI governance cobriu as doze superfícies e o circuit breaker. Este post cobre a camada que todos dependem mas nunca mencionam: a camada de sessão que impede cem agentes de pisar uns nos outros. O próximo post desta série cobrirá o capability lockfile, e como o arquivo mcpfusion.lock impõe mudanças disruptivas com diffs git-diffable e gates de CI.
Os números acima não são minhas estimativas. São o que o código impõe. Você pode ler Limits.ts, SessionManager.ts, SsrfGuard.ts, e CircuitBreaker.ts no runtime cloud. Cada valor é nomeado, documentado, e derivado de uma restrição externa. Essa é a diferença entre uma plataforma que escala e uma demonstração que colapsa.
O gerenciamento de sessões, a aplicação de cotas e o circuit breaker que regem agentes concorrentes são respondidos com código-fonte em Perguntas sobre AI Empresarial.