
Veröffentlicht 21. Sept. 202621 Min. Lesezeit
KI-Governance: die Control-Plane hinter jedem Tool-Call deiner Agenten
Vinkius KI-Governance: die Control-Plane, die jeden MCP-Tool-Call einer Identität zuordnet, Daten im Flug schützt, Agenten-Ausgaben budgetiert und einen hash-geketteten Audit-Beleg versiegelt, für den Regulator, die Finanzabteilung und den Alarm um drei Uhr morgens.

Von Renato Marinho
Founder · Vinkius
Vor sechs Monaten habe ich Teams noch beim Präsentieren von Agenten-Demos zugeschaut. Jetzt beobachte ich Agenten, die handeln. Irgendwo dazwischen hat sich der Schwerpunkt der Agenten-Infrastruktur von "Kann das Modell die Aufgabe lösen" auf "Kannst du den Moment überleben, in dem das Modell aufhört zu antworten und anfängt zu tun" verschoben. Ein Tool-Call ist ein Schreiben in die Welt. Eine Mail geht raus. Eine Zeile wird aktualisiert. Eine Bestellung wird ausgelöst. Eine Datei wird gelöscht. Das, was entscheidet, ist probabilistisch, und das, was ausführt, nicht. Jeder Vorfall in agenter Systeme lebt in dieser Lücke, und dieser Post handelt davon, wie man sie schließt.
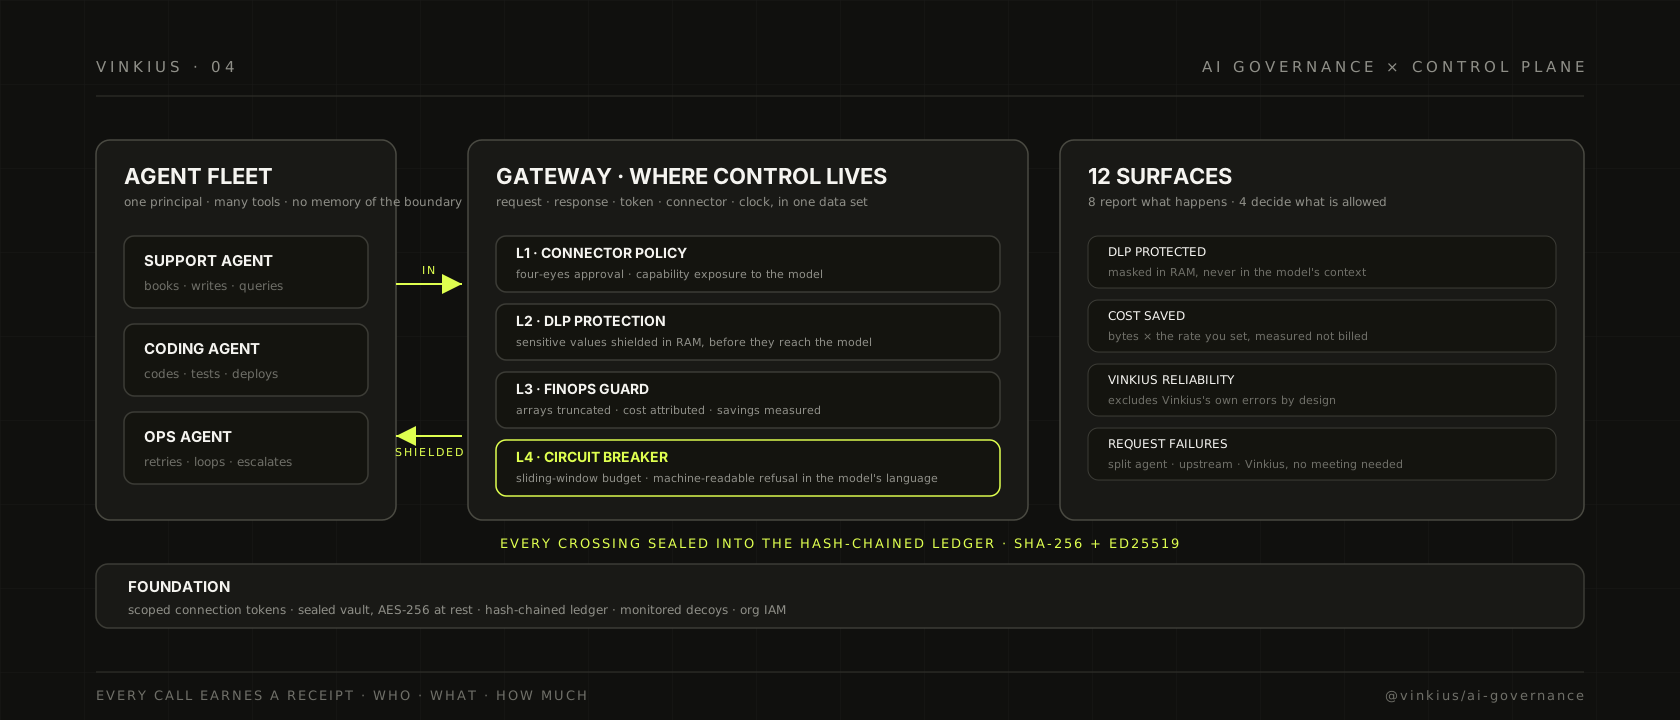
Vinkius habe ich um eine Überzeugung gebaut: Eine Cloud für KI-Agenten ist erst fertig, wenn man für jeden Tool-Call, zu jedem Moment, mit Beweislast, vier Fragen beantworten kann. Wer hat angerufen. Was durfte geschehen. Was ist durch das Tor gegangen, und was wurde auf dem Weg raus abgeschirmt. Und was hat es gekostet. Die Antwort auf diese vier Fragen ist die Control-Plane, die wir als zwölf Oberflächen ausliefern: acht, die erzählen, was passiert, und vier, die entscheiden, was erlaubt ist. Alles Folgende ist, was die Plattform heute tut. Die Zahlen sind die Zahlen, die das System durchsetzt oder berichtet, nicht die, die mir gefallen würden.
Der Moment, in dem Agenten aufhören zu reden und anfangen zu handeln
Das Vorfall-Management im Enterprise war jahrelang ruhig, denn was kaputtging, war von Menschen gebaut und änderte sich langsam. Ein Service hat einen Owner, ein Changelog, einen Post-Mortem und eine feste Population von Aufrufenden. Ist der Aufrufende ein Modell, verdampft all das mit einer einzigen Design-Entscheidung. Derselbe Agent kann morgens ein Meeting buchen, mittags Code schreiben und nachmittags eine Produktionsdatenbank abfragen. Dafür existieren agente Systeme: ein Principal, viele Tools, und keine Erinnerung an die Grenze zwischen ihnen. Die Fehlerkategorien ändern sich mit.
Klassisches Monitoring fragt: "Ist die Anfrage fehlgeschlagen, und warum?" Bei Agenten kommen vier Fragen dazu, und jede hat ihre eigene Antwortform. War der Fehler beim Agenten, weil er eine unzulässige Anfrage geschickt oder auf einem kaputten Tool in einer Schleife gestanden hat? War er beim Upstream, weil die API, die er aufrief, eine 500 zurückgegeben hat? War er bei der Plattform, weil das Gateway selbst sich falsch verhalten hat? Und die, die niemand fragt, bis die Finanzabteilung es tut: Was hat all das gekostet, pro Anfrage, pro Connector, pro Agent, in Dollar?
Ich habe genug Vorfall-berichte gelesen, in diesem Bereich und in meinem, um das Antwortmuster zu kennen. Fast immer lautet es: "Wir konnten nicht feststellen, welcher Agent was getan hatte, und wir haben es nach dem Schaden herausgefunden." Ein nicht-deterministischer Aufrufender und ein nachträgliches Log-System sind ein furchtbares Paar. Das Log ist ein Tatortfoto, und der Verdächtige hat das Gebäude bereits verlassen. Governance ist die Architektur, die man baut, damit Verdächtiger, Werkzeug und Zeitstempel im Moment der Tat erfasst werden, nicht danach.
Was KI-Governance tatsächlich ist
KI-Governance im Sinne, den die Branche braucht, ist die Control-Plane, die den Verkehr von Agenten zu Tools umgibt. Sie ist kein Policy-Engine im traditionellen OPA-Sinn, das zur Deploy-Zeit entscheidet, welche Regeln ein Service bekommt. Sie ist kein RBAC, das entscheidet, welcher Mensch sich anmelden darf. Sie ist kein SIEM, der Logs nachträglich korreliert. All diese Systeme wurden für eine Welt entworfen, in der das, was handelt, ein Mensch oder eine feste Pipeline ist.
Was KI-Governance tut, ist anders, und es lohnt sich, präzise zu sein. Sie entscheidet pro Aufruf, ob eine Handlung eines nicht-deterministischen Principals auf einer Maschine, gegen das System eines Dritten, unter einem Budget, erlaubt ist. Und sie verwahrt für jeden Aufruf einen Beleg, der Wer, Was und Wie viel beantwortet. Der Begriff "Governance" leistet hier echte Arbeit, und er ist nicht nur ein Compliance-Wort. Compliance ist die Ausgabe. Die Eingabe ist eine Control-Plane mit zwei Eigenschaften: Zuordnung auf Identitätsgranularität, und Durchsetzung im Flug, bevor der Aufruf die eigene Infrastruktur verlässt.
Bei Vinkius ist diese Control-Plane das, was wir KI-Governance nennen, und sie ist als zwölf Oberflächen organisiert. Acht Berichts-Oberflächen erzählen, was in der Flotte der Connectoren passiert, die deine Agenten benutzen. Vier Policy-Oberflächen entscheiden, was passieren darf, und sie werden im Runtime durchgesetzt, auf dem Pfad der Anfrage, nicht in einem Dashboard, das man am Montag prüft. Die Aufteilung ist absichtlich. Ein Dashboard, auf dem man nicht handeln kann, ist Theater, und eine Policy ohne Beleg ist Angst. Man braucht beide Hälften, und das Produkt ist ihre Vereinigung.
Warum nur das Gateway der Ort ist, an dem Kontrolle leben kann
Das architektonische Argument ist kurz. Deine Agenten rufen deine Upstream-APIs nicht direkt an. Sie rufen Tools auf, und bei Vinkius sind diese Tools Connectors, gehostete MCP-Server, zu denen jeder Agent in der Flotte durch ein einziges Tor gelangt. Dorthin muss der Verkehr, also muss dorthin die Kontrolle.
Die Client-Seite ist kein sicherer Ort dafür. Guardrails auf Prompt-Ebene sind von der Konstruktion her fragil, weil das Modell seinen Weg um eine Regel herum formulieren kann und weil eine Guardrail, die im Prompt lebt, einen Kontextfenster von der Nichtexistenz entfernt ist. Providerseitige Filter sind nicht dein Datenpfad, und man kann einen Vendor nicht für das Verhalten deines Agenten haftbar machen. Nachträglich Analytics, der SIEM, den man später andrahtet, sind eine Aufzeichnung dessen, was passierte, nützlich, und zu spät, um das aufzuhalten, was gerade geschieht.
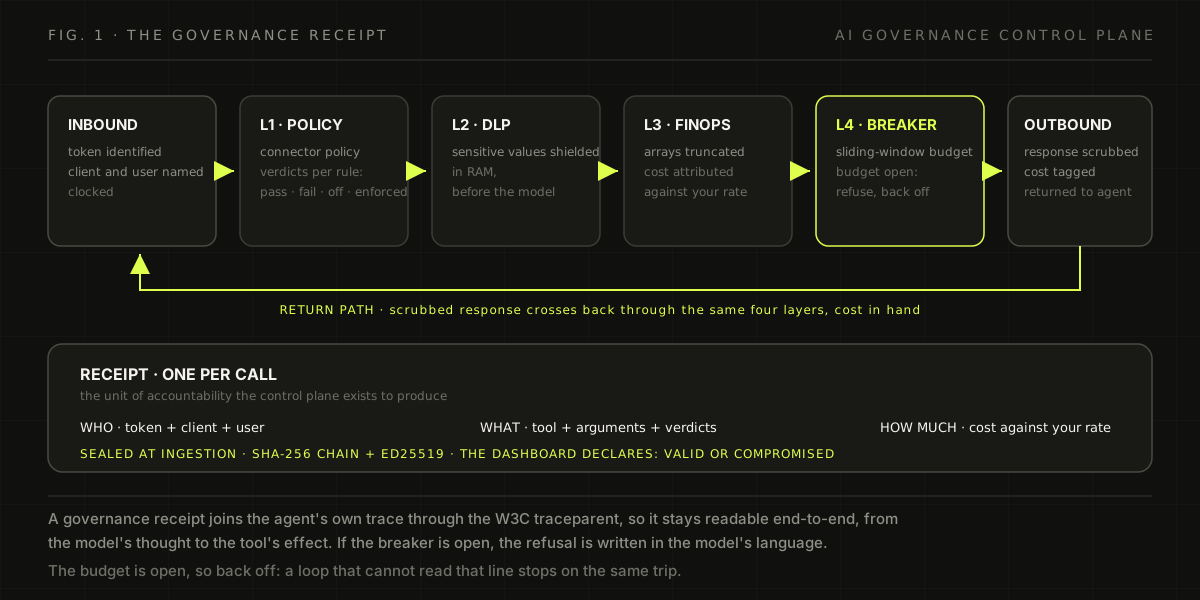
Das Gateway sieht alles auf einmal: die Anfrage, die Antwort, das Token, das den Aufruf authentifiziert hat, den Connector, den er traf, und die Uhr. Das ist der einzige Punkt im System, an dem "Wer, Was und Wie viel" mit einem einzigen Datensatz beantwortbar ist, und zugleich der einzige Punkt, an dem eine Entscheidung das Ergebnis noch verändern kann. Jeder Tool-Call in deiner Flotte passiert das Tor zweimal, eingehend und ausgehend, und an beiden Durchfahrten geschieht Governance.
Zwei weitere Teile der Vinkius-Plattform machen das Gateway-Argument vollständig. Jeder Connector läuft in seinem eigenen gesandboxten Isolate, ein Design, über das ich separat in wie Vinkius jeden MCP-Server in einem V8-Isolate betreibt geschrieben habe, damit ein feindseliges oder kaputtes Tool immer nur durch Effekte handeln kann, die dem Host gehören. Und seit der 5.1.0-Release unseres offenen Frameworks wird der verteilte Trace-Kontext des Agenten über das Gateway getragen, sodass jeder Tool-Span als Kind an den Trace des Aufrufenden angehängt wird. Diese Arbeit ist in dem MCP-Fusion-5.1.0-Post zur Trace-Korrelation, und sie zählt hier, denn ein Governance-Beleg, der sich nicht an den eigenen Trace des Agenten anschließen lässt, ist ein Beleg, den niemand lesen kann.
Ein Hinweis mit offenem Visier vor dem Rundgang: Im Free-Plan öffnet sich das KI-Governance-Dashboard mit klar gekennzeichneten Beispieldaten. Man erkundet die Form der Control-Plane, bevor man sich festlegt. Live-Durchsetzung, der Circuit-Breaker und der Notstopp laufen auf bezahlten Plänen. Ich sage es lieber offen, als dass ein Leser annimmt, die Free-Stufe tue, was die bezahlte tut.
Acht Oberflächen, die erzählen, was passiert
Die Bericht-Seite der KI-Governance ist der Ort, an dem ich am meisten Zeit verbringen möchte, denn hier testen Unternehmen zuerst, und hier stellt sich heraus, dass "Wir haben unsere Agenten instrumentiert" im Normalfall ein Satz über vier Dashboards und ein Gebet ist.
Mission Control
Die oberste Schicht ist die KPI-Leiste der ganzen Flotte: Gesamtanfragen, mittlere Latenz, eine Zuverlässigkeitszahl, die wir Vinkius Reliability nennen, verschiebene Token, die Zahl der von der Datenverlust-Prävention geschützten Werte und die geschätzte Ersparnis des FinOps-Guards. Darunter liegt eine 30-tägige Aktivitäts-Hitzekarte des Agenten-Verhaltens über den Monat, ein Diagramm von Anfragesatz und Latenz, und ein AI Briefing: eine vom Sprachmodell erzeugte Kurzfassung dessen, was sich im eigenen Verkehr in dieser Zeit geändert hat. Es ist die eine bewusst nicht-deterministische Oberfläche in einer deterministischen Control-Plane, und es ist eine Bezahl-Funktion, denn das Briefing ist ein Modellaufruf. Ein Detail, auf dem ich bestehe: Die Zuverlässigkeitszahl, die man sieht, schließt die eigenen Fehler von Vinkius aus. Die Zahl beantwortet "Wie zuverlässig ist die Flotte für euch", nicht "Wie zuverlässig sind wir". Wir buchen unsere Fehler nicht gegen eure Betriebszeit auf.
Agent Activity
Die pro-Client-Ansicht. Jedes Verbindungstoken der Organisation erscheint mit seiner Aktivität: Wer der Client ist, wann er zuletzt aufgerufen hat, wie viele Anfragen er gestellt hat. Diese Oberfläche beantwortet "Welcher Agent tut was". Ein Agent, der stündlich laufen soll, aber alle 90 Sekunden aufruft, taucht hier auf, und genau hier wird eine durchlaufende Schleife normalerweise zuerst bemerkt, bevor sie zur Rechnung wird.
Connector Traffic
Die gleiche Zerlegung, pro Connector. Welches der eigenen Tools ist heiß, welches ist kalt, wo sich Latenz konzentriert. Wenn ein Upstream-Provider nachlässt, ist das die Ansicht, die das Problem des Providers vom Problem der eigenen Flotte trennt.
Access Tokens
Die Token-Flotte als Inventar. Status, letzte Nutzung, Anfragesätze. Diese rechtfertigt sich auf eine Weise, die Menschen überrascht: ein Verbindungstoken, das seit 90 Tagen nicht verwendet wurde, ist ein stehender Credential, den man ausgestellt und vergessen hat, und diese Oberfläche existiert, um genau diese Vergesslichkeit sichtbar und handelbar zu machen, mit Revoke und Rotate einen Klick entfernt.
AI Spend
Kosten, lesbar gemacht. Geschätzte Ausgaben, die Ersparnis, die der FinOps-Guard gemessen hat, Kosten pro Anfrage, die Rendite der FinOps-Policies und ein Ledger, zerlegt pro Connector. Der Guard ordnet Kosten einem pro-Million-Token-Satz zu, den man selbst setzt, der Standardwert ist 3,00 USD pro Million Token. Der Punkt der Oberfläche ist nicht, selbst zu verrechnen. Er ist, zu zeigen, welcher Agent auf welchem Connector was konsumiert, denn Agenten-Ausgaben haben keine Form wie Kosten, die man je in ein Diagramm gebracht hat. Nicht pro Nutzer, nicht pro Anfrage. Pro Gedanke, und jede Retry-Schleife, die eine Schleife dazuaddiert, erhöht sie erneut.
Capability Reliability
Zuverlässigkeit auf Tool-Ebene, nicht auf Service-Ebene. Jede Fähigkeit, die ein Connector exponiert, hat ihre eigene Latenz und ihr eigenes Fehleverhalten, und die Tool Health Matrix bringt sie zusammen: Latenz gegen Fehlerquote, eine Blase pro Tool. Ein Connector kann vollkommen gesund sein, während ein bestimmtes Tool darin leise versagt. Das ist der Unterschied zwischen einem Produkt zu überwachen und dem zu überwachen, was die eigenen Agenten tatsächlich berühren.
Security Posture
Zwei Zeitreihen und ein Donut. Die Zeitreihen verfolgen, wie viel Daten die DLP-Ebene über die Zeit abgeschirmt und wie viel die FinOps-Ebene abgeknipst hat. Der Donut ist Compliance Coverage: der Anteil aktiver Governance-Policies über die Flotte, gezählt pro Kategorie, DLP, FinOps und Genehmigungen. Es ist die Zahl, die ein Prüfer sehen will, und sie wird aus dem Policy-Zustand berechnet, nicht aus einem Fragebogen, den man ausfüllt.
Request Failures
Die Fehler-Zeitleiste, aufgeteilt in drei Körbe: Agent errors, wenn der Aufrufende etwas geschickt hat, das das Tool nicht honorieren konnte, Upstream errors, wenn der Dritte hinter dem Connector versagt hat, und Vinkius errors, wenn wir versagt haben. Das ist die Fehlerzuordnung, auf die der Anfang dieses Posts abzielte. Wenn ein Aufruf scheitert, erfährt man, wessen Fehler es war, in derselben Ansich, im selben Zeitraum, ohne Meeting.
Request Detail: der Beleg
Zoomt man in eine einzelne Anfrage, bekommt man die Einheit der Verantwortung, die die ganze Control-Plane dazu existiert zu produzieren. Der Beleg benennt die Identität, die den Aufruf getätigt hat: Token, Client, und der Mensch oder App-Benutzer dahinter. Er listet die in jenem Moment gültige Policy auf, Regel für Regel, gruppiert nach der Phase des Anfraglebenszyklus, zu der jede Regel gehört, mit dem Urteil jeder: pass, fail, off, enforced. Er zeigt den Audit-Eintrag für den Aufruf, versiegelt bei der Aufnahme in das unten behandelte hash-gekettete Ledger. Er zeigt die Trace-Kontinuität, den W3C-Trace-Kontext, der diesen Aufruf an den eigenen verteilten Trace des Agenten anbindet. Er zerlegt die Latenz in die Zeit, die die Upstream-API gebraucht hat, und die Zeit, die die Governance-Ebene dazugefügt hat, damit man immer die Kosten der Control-Plane selbst kennt. Und er endet mit Aktionen: eine Fähigkeit für jeden Aufrufenden blockieren oder, in der Business-Stufe, den Notstopp des Connectors. Eine Anfrage, eine Bildschirmebene, die ganze Geschichte.
Vier Oberflächen, die entscheiden, was erlaubt ist
Connector Policy
Die erste Policy-oberfläche handelt davon, wie ein Connector in die eigene Flotte eingeführt wird. Deployments können eine Genehmigung vor dem Live-Betrieb verlangen, und die Einstellung ist am Vier-Augen-Prinzip ausgerichtet, das der EU AI Act von Hochrisiko-Systemen nach Artikel 14(5) erwartet: Eine einzelne Person entscheidet nicht allein, dass ein neues Tool mit realen Konsequenzen die Agenten erreicht. Dieselbe Oberfläche steuert, wie Fähigkeiten dem Modell exponiert werden, flach oder gruppiert, mit einer automatischen Gruppierungsschwelle, wenn die Tool-Liste eines Connectors lang wird, denn was das Modell sieht, ist eine Oberfläche, und Oberfläche ist eine Design-Entscheidung.
Und dann ist da die Gefahrenzone, die man verstehen, nicht entdecken sollte. Der Global Emergency Halt stoppt jeden aktiven Connector der Organisation. Er deaktiviert sie alle, widerruft jedes Token und beendet jede offene Sitzung, in einer einzigen synchronen Aktion, und die Bestätigung verlangt das Eintippen von HALT ALL, denn das ist der Knopf, den man drückt, wenn etwas arg schiefgegangen ist und man die ganze Flotte lieber tot als falsch haben will. Nach dem Halt kann man wiederherstellen, aber die widerrufenen Tokens bleiben widerrufen. Man stellt sie bewusst aus. Das ist eine Design-Entscheidung, die ich explizit machen will: Wiederherstellung ist eine neue Vertrauensbeziehung, nicht eine Wiederaufspieldung der alten.
DLP Protection
Datenverlust-Prävention, gemacht für den Modellpfad. Man benennt Muster für sensible Felder, eine E-Mail irgendwo im Antwortbaum, eine Kreditkartennummer, ein Feld an einem bestimmten Pfad, das man schützen will, und das Runtime setzt sie auf dem ausgehenden Pfad durch, schirmt den Wert ab, bevor die Antwort den Agenten erreicht. Die Schirmung geschieht im Speicher, auf dem Pfad zwischen Upstream und Modell, und das ist der Unterschied zwischen Daten, die maskiert wurden, und Daten, die nie im Kontext des Modells waren. Die KPI DLP Protected in Mission Control zählt die Redaktionen pro Periode, also ist die Ebene nicht nur da, sie ist gemessen.
FinOps Guard
Kosten-Guardrails, aus den Gründen, die im AI-Spend-Abschnitt erklärt sind. Der Guard tut drei Dinge. Er knipst Arrays über einer maximalen Eintragszahl ab, denn eine Antwort, die zehntausend Datensätze zurückgibt, ist eine Token-Rechnung, keine Antwort. Er komprimiert die Tool-Beschreibungen, die das Modell vor seinem Handeln liest, die Toon-Kompression-Einstellung im Dashboard. Und er ordnet Kosten dem Satz zu, den man gesetzt hat, sodass der Guard pro Periode mitteilt, wie viel er gespart hat, in Bytes und in Dollar, gemessen am Satz. Die Ausgabe ist keine Rechnung. Sie ist ein Maß der Lücke zwischen dem, was das Tool zurückgab, und dem, was der Agent brauchte, und das ist die Zahl, die entscheidet, ob der eigene Agent dieses Tool überhaupt weiter aufrufen kann.
Circuit Breaker
Ein Schiebfenster-Anfragebudget pro Connector, im Standard 5.000 Anfragen alle 5 Minuten und eine 15-minütige Kühlzeit, einstellbare Zahlen. Übersteigt ein Connector sein Budget, löst der Breaker aus, und der Auslöser tut etwas, das die meisten Guardrails nie tun: Er sagt dem Agenten, in einer maschinenlesbaren Absage, die für ein Modell geschrieben ist, dass die Ressource offen ist und er zurückfahren soll. Ein guter Agent respektiert das. Eine Schleife, die die Absage nicht lesen kann, wird vom selben Auslöser gestoppt, und genau darum geht es. Der Breaker-Zustand wird über die Flotte der Gateway-Instanzen geteilt, also ist ein Budget ein Budget, keine pro-Prozess-Schranke, die zurücksetzt, wenn der Verkehr umzieht. Nach der Kühlzeit setzt er von selbst aus, oder man genehmigt die Fortsetzung im Dashboard. Der Breaker ist das, was verhindert, dass ein einzelner außer Kontrolle geratener Agent die API eines Dritten, und die eigene Rechnung, mit sich reißt.
Die Grundlagen: scoped Tokens, ein versiegeltes Vault, ein gekettetes Ledger
Die zwölf Oberflächen stehen auf Grundlagen, und bei den Grundlagen sind viele "Governance"-Produkte tatsächlich dünn.
Die Identitätsebene ist das Verbindungstoken. Jeder Connector hat eigene Tokens, erzeugt pro Organisation, einmal angezeigt, signiert und nur für diesen Connector scoped. Ein Token des E-Mail-Connectors kann den Zahlungsverkehr-Connector nicht berühren. Jeder Beleg benennt das Token, das den Aufruf getätigt hat, also ist Identität keine Theorie, sondern eine Spalte in den Audit-Daten.
Die Geheimnisebene ist das Vault. Connector-Credentials werden im Ruhezustand mit AES-256 verschlüsselt, und die Zusage, die wir machen, ist, dass selbst die Betreiber der Plattform sie im Ruhezustand nicht lesen können. Sie werden nur zur Laufzeit in die Umgebung injiziert, in das Isolate, in dem der Tool-Code läuft, und der Agent sieht das Secret nie. Diese Trennung ist die, über die ich am meisten nachdenke, wenn ich Designe: das, was entscheidet, das Modell, und das, was Autorität beweist, die Credentials, dürfen nie denselben Kontext teilen. Ein Modell, das das Upstream-Passwort lesen kann, ist kein Governance-Problem, das man weg-Auditen kann. Es ist das Problem.
Die Audit-Ebene ist das Ledger. Jeder Anfrage-Hash wird bei der Aufnahme versiegelt, und das Ledger ist hash-gekettet: jeder Eintrag trägt den vorherigen Hash und seine Position in der Sequenz, und die Kette ist signiert, SHA-256 mit Ed25519, sodass eine Manipulation keine Privatsphärenfrage ist, sondern ein detektierbares Ereignis, und das Dashboard sagt, die Kette ist gültig oder kompromittiert. Das Deployment-Audit ist um GDPR Artikel 73, das Auskunftsrecht der betroffenen Person, herumgebaut, sodass wenn ein Regulator oder ein Kunde die vollständige Historie eines Connectors verlangt, die Antwort eine einzelne exportierbare, verifizierbare Kette ist, kein Projekt.
Und eine Ebene mehr, die, auf die ich am stolzesten bin. Einige der Connectors auf unserem Marktplatz sind überwachte Köder. Sie sehen aus wie echte Tools. Sie sind es nicht, und sie werden beobachtet. Wird ein Köder berührt, isoliert die Plattform das Tool, widerruft das Token, kapp die offenen Verbindungen und friert den Auszahlungspfad ein, automatisch. Geht ein Tool außer Kontrolle, oder ist ein Token in die Welt hinausgelangt, wartet die Eindämmung nicht darauf, dass man es bemerkt.
Darunter liegt die Organisationsebene: Single Sign-On, eigene Rollen und Teams, Service-Accounts für die nicht-menschlichen Identitäten, die in CI und OIDC-Workloads laufen, Organisations-API-Keys und ein Security-Audit-Log für Aktionen an der Organisation selbst. Die Control-Plane sitzt auf einem Identitätsmodell, das den Unterschied zwischen einer Person und einer Maschine kennt, und das ist ein Unterschied, auf den jede der zwölf Oberflächen angewiesen ist.
Was Governance für die Agenten selbst ändert
Der Großteil der Gespräche über Agenten-Governance behandelt den Agenten als ein Risiko, das es einzudämmen gilt, und das werde ich nicht leugnen, denn es ist eines. Aber die andere Hälfte des Arguments ist die, die man in die Sales-Präsentation setzen würde: Governance ist das, was einen Agenten aus einer Demo in einen Arbeiter verwandelt.
Vertrauen wird im Verhältnis zum Beweis erteilt. Ein Operator gibt einem Agenten die Nachtschicht, die Produktionsabfrage, die Zahlungs-Ausgleichung, im direkten Verhältnis dazu, wie gut jede seiner Handlungen zuordenbar, budgetierbar, abschirmlbar und nachträglich verifizierbar ist. Der Beleg ist keine Last für den Agenten. Er ist die Bescheinigung, die ihm den größeren Raum verschafft.
Die Ummantelung eines governed Agenten ist bekannt. Eine deterministische Policy um ein nicht-deterministisches Modell ist die einzig sinnbare Form für den Produktivbetrieb: Das Modell plant in einer Box, und die Box ist stabil. Die Absage des Circuit-Breakers ist in der Sprache des Modells geschrieben, also lernt der Agent das Budget und respektiert es, statt es in Form einer Rechnung zu entdecken. Die Abknipfung im FinOps-Guard bedeutet, dass das Modell eine maßlich passende Antwort bekommt statt eines 200-Kilobyte-Blobs, und das ist ein Intelligenzproblem, nicht nur ein Kostenproblem.
Und der Agent selbst bekommt die Fähigkeit, die kein autonomes System je in der Praxis hatte: Er kann seine Arbeit zeigen. Für einen Agenten, der in regulierten Workflows operieren wird, ist der Audit-Verlauf keine Überhead, er ist das Produkt. Der governed Agent ist die einzige Art von Agenten, dem man echte Vollmacht geben kann, und der ungoverned Agent bleibt, für immer, eine Demo.
Observability, die endlich die Sprache der Agenten spricht
Wenn dein Team bereits Datadog oder Grafana betreibt, fühlt sich die Form der KI-Governance-Oberflächen vertraut an, und das ist beabsichtigt. KPI-Leisten, Hitzekarten, Drill-Downs, Beleg pro Anfrage. Was nicht vertraut ist, ist das, was Agenten-Verkehr mit dem Modell tut, auf dem diese Tools gebaut wurden.
Datadog misst eine Welt, in der die Aufrufenden Systeme sind, die jemand geschrieben hat. Die Last hat eine feste Form, Kosten skalieren mit Nutzern oder Anfragen, und ein Fehler hat eine verantwortliche Partei. Agenten-Verkehr bricht alle drei Annahmen gleichzeitig. Der Aufrufende ist probabilistisch. Die Last ist vom Denken geformt, und eine Retry-Schleife vermehrt sie. Und ein Fehler hat drei Kandidaten der Verantwortung, Agenten, Upstream, Plattform, weshalb die Fehler-Zeitleiste sich in drei Körbe aufteilt statt in einen.
Die Control-Plane für Agenten ist also Observability mit einer Durchsetzungsebene, und die Durchsetzungsebene ist das, was Datadog, gebaut für eine von Menschen gebaute Welt, nicht hat. Jeder Tool-Call wird einer Identität zugeordnet, Kosten werden auf Token-Granularität zugeordnet, Fehler werden der verantwortlichen Seite zugeordnet, und die Policy-Ebene wirkt im Flug, bevor der Aufruf das Tor verlässt. Das ist der Sprung, um den es in diesem Post geht: die Instrumentierungsdisziplin der Plattformen, denen man bereits vertraut, übernehmen und die beiden Eigenschaften dazu, die Agenten-Systeme brauchen, Zuordnung pro Aufruf und Durchsetzung im Flug. Das Ergebnis ist keine neue Kategorie von Werkzeugen. Es ist dieselbe Kategorie, bei der Auflösung, die Agenten-Systeme verlangen.
Häufige Fragen
Ist KI-Governance nur RBAC mit zusätzlichen Schritten?
Nein, und der Unterschied ist die Einheit der Entscheidung. RBAC entscheidet, welcher Mensch, mit welcher Rolle, auf ein System zugreifen darf. Es ist ein Tor an der Identität, einmal bewertet. KI-Governance entscheidet, was eine Handlung, vollbracht von einem nicht-deterministischen Principal durch ein bestimmtes Tool, bei jedem Aufruf, unter einem Budget, tun darf, mit der Antwort aufgezeichnet. Das eine ist eine Tür. Das andere ist ein Verkehrgericht für die Handlungen der eigenen Agenten.
Liest Vinkius die Prompts meiner Agenten?
Nein. Das Tor sieht den Tool-Call: den Tool-Namen, die gesendeten Argumente, die empfangene Antwort, die Identität dahinter und die Uhr. Die vier Policy-oberflächen sind deterministische Regel- und Budget-Ebenen, keine Sprachmodell-Richterin. Wenn man will, dass ein Modell ein Modell prüft, ist das ein anderes Produkt, und ich würde das nicht Governance nennen, ich würde es eine Zweitmeinung nennen.
Was passiert, wenn der Circuit-Breaker auslöst?
Der Verkehr des Connectors wird für eine Kühlperiode abgewiesen, mit einem maschinenlesbaren Hinweis, der dem Agenten sagt, dass das Budget offen ist und er zurückfahren soll. Nach der Kühlzeit setzt der Breaker von selbst aus, oder ein Operator genehmigt die Fortsetzung aus dem Dashboard. Der Zustand wird über die Gateway-Flotte geteilt, also bleibt das Budget bestehen, unabhängig davon, welche Instanz den Aufruf bedient. Die Session-Ebene, die den Schwarm unter Kontrolle hält, ist Thema des SwarmGateway-Sessions-Artikels.
Kann ich die Audit-Kette exportieren und verifizieren?
Ja. Das Deployment-Audit wird als Dokument exportiert, und die Kette ist von Ende zu Ende verifizierbar: jeder Eintrag trägt den vorherigen Hash und seine Position, die Kette ist signiert, und das Dashboard stellt fest, ob die Kette gültig oder kompromittiert ist. Sie ist um GDPR Artikel 73 gebaut, sodass die Auskunftsanfrage einer betroffenen Person auf ein einzelnes Artefakt abbildet.
Was bekomme ich im Free-Plan?
Das vollständige Dashboard, mit klar gekennzeichneten Beispieldaten, damit man die Form der Control-Plane lernen kann. Live-Durchsetzung, Circuit-Breaker und Notstopp liegen auf bezahlten Plänen, und das AI Briefing ist eine Bezahl-Funktion. Ich möchte lieber der Anbieter sein, der einem das in einem Blog-Post sagt, als der, der es einem auf der Preisseite entdecken lässt.
Die Control-Plane ist das Produkt
Die Lücke zwischen dem Agenten-Demo und dem Agenten, den man im Schlaf handeln lassen würde, ist nicht das Modell. Sie ist die Control-Plane. Zwölf Oberflächen, acht die erzählen und vier die entscheiden, gegründet auf scoped Tokens, ein versiegeltes Vault, ein gekettetes Ledger und eine Köder-Ebene, die den Schaden eindämmt, bevor man ihn selbst tut. Jeder Aufruf bekommt einen Beleg, und der Beleg beantwortet Wer, Was und Wie viel, in der Reihenfolge, in der ein Regulator, eine Finanzabteilung oder ein Alarm um drei Uhr morgens ihn fragen würde.
Wenn deine Agenten bereits in deinen Systemen handeln, lautet die Frage nicht mehr, ob man sich Governance leisten kann. Ob man sich den Tag leisten kann, an dem man herausfindet, dass man sie nicht hat.
Um einen tieferen Einblick darauf, wie Vinkius den Runtime aufgebaut hat, der diese Governance für KI-Agenten möglich macht, siehe AI-Agenten sind die neuen Consumer.
Die zwölf hier definierten Governance-Oberflächen werden mit Quellcode und Zeilennummern durchgesetzt in Unternehmens-KI-Fragen.