
Veröffentlicht 22. Sept. 202619 Min. Lesezeit
Das Schwarm-Problem: Wie Vinkius Gateway Hundert gleichzeitige Sitzungen konsolidiert ohne Status zu verlieren
Wie einhundert gleichzeitige KI-Agenten, die Sitzungen teilen, zu Deadlocks, Rate-Limit-Rennen und veralteten Status führen, und wie das B2BUA-Muster des Vinkius Gateway, Sitzungsbegrenzungen, kausale Invalidierung und der Circuit-Breaker dies lösen.

Von Renato Marinho
Founder · Vinkius
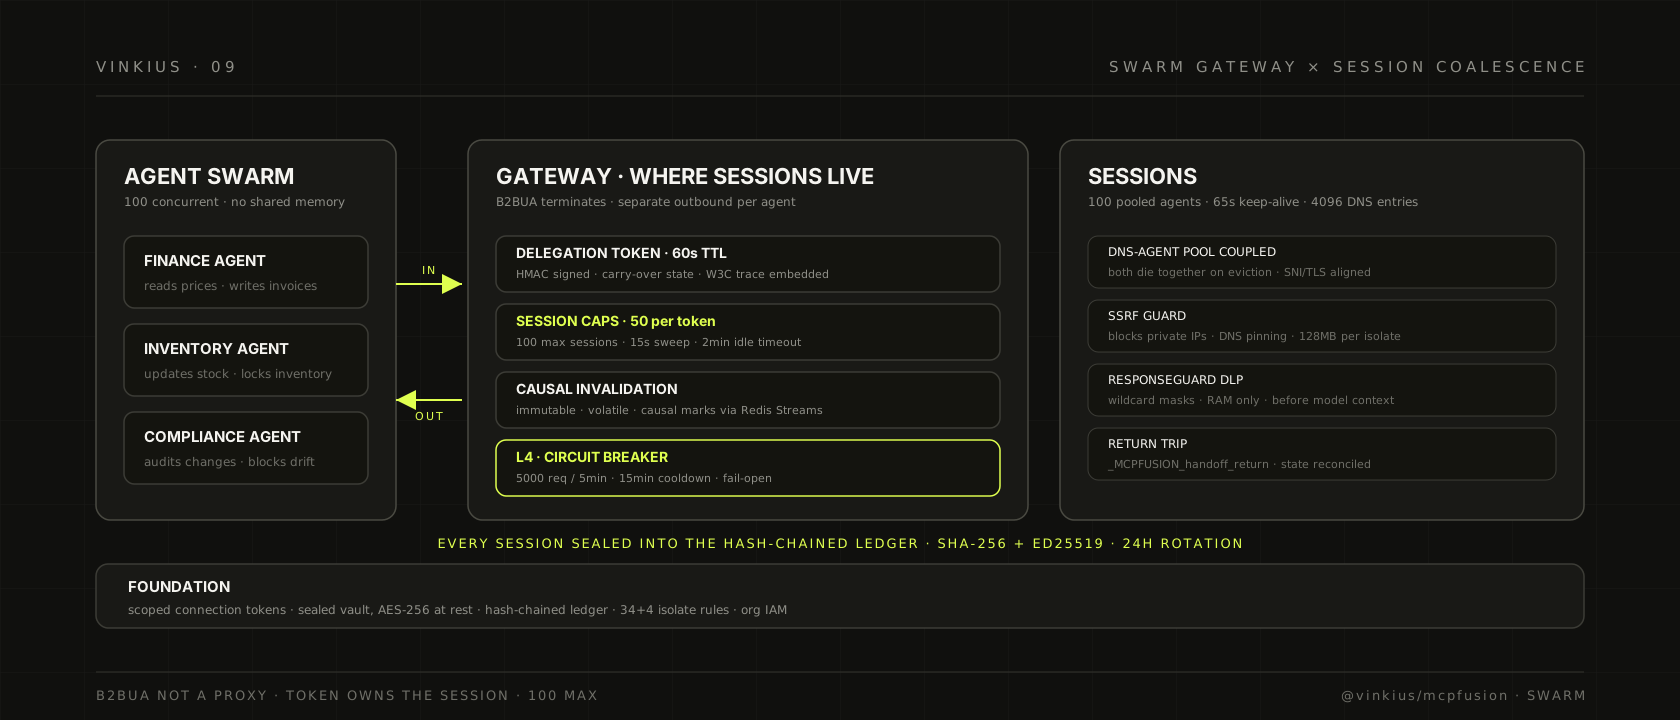
Das Schwarm-Problem: Wie Vinkius Gateway Hundert gleichzeitige Sitzungen konsolidiert ohne Status zu verlieren
Ich sah einen Kunden, der zwölf KI-Agenten auf eine einzige Aufgabe zur Optimierung der Lieferantenkette deployte. Innerhalb von drei Tagen waren die Agenten in einem Deadlock über den gemeinsamen Status der Lagerbestände, um Sie mit den API-Rate-Limits der Lieferanten zu rennen, und erstellten Kaskaden von Rechnungsänderungen, die kein einzelner Agent rückgängig machen konnte. Die Schlussfolgerung des Kunden war, dass die Agenten "zu intelligent für ihr eigenes Wohl" seien.
Das war nicht passiert. Die Agenten waren nicht zu intelligent. Sie waren zu einsam. Jeder Agent glaubte, die Sitzung zu besitzen, jeder Agent schrieb einen Status, den die anderen nie abgleichen würden, jeder Agent verbrauchte die gleiche Bandbreite ohne zu wissen, dass seine Peer existiert. Das Problem war nicht die Intelligenz des Agenten. Es war die Sitzungsschicht, die alle teilten, und die Tatsache, dass niemand sie besaß.
Hier ist das Schwarm-Problem. Du hast nicht mehr einen Agenten. Du hast ein Team, eine Gruppe, einen Schwarm. Finanz-Agenten, Lager-Agenten, Beschaffungs-Agenten, Compliance-Agenten. Alle sprechen mit verschiedenen Diensten über verschiedene Anmeldeinformationen, teilen sich das gleiche Bandbreitenbudget und glauben, der Status, den sie vor fünf Aufrufen gelesen haben, sei immer noch gültig. Das alte Modell setzte einen Agenten, eine Sitzung, einen Lebenszyklus voraus. Das neue Modell setzt keines davon voraus.
Vinkius löst dieses Problem mit einem Gateway-Muster, nicht mit einem Agenten-Muster. Das Gateway ist der Besitzer der Sitzung. Die Agenten sind Gäste. Die Zahlen, die dieses Design bestimmen, sind nicht ambitioniert. Sie stammen aus der Laufzeitkonfiguration, dem SSRF-Schutz und dem Circuit-Breaker-Code. Jeder Wert leitet sich von einer externen Einschränkung ab. So funktionieren die Mathematik.
Der B2BUA, der die Sitzung besitzt
Der SwarmGateway ist ein Back-to-Back User Agent. Kein Proxy. Kein Lastverteiler. Ein B2BUA: Er beendet die eingehende MCP-Sitzung des Anrufers und etabliert eine separate ausgehende Sitzung für jeden Fachmann-Agenten. Das Gateway spricht im Namen des Anrufers, aber die Sitzung des Anrufers endet am Gateway.
Das Gateway ist mit einem Verzeichnis konfiguriert, das Fachmann-Namen an Upstream-URLs zuordnet, einem gemeinsamen Delegationsgeheimnis und einer Reihe operativer Grenzen. Wenn ein Agent einen Handoff auslöst, erzeugt das Gateway ein delegationsbegrenztes Token mit einer HMAC-Signatur. Das Token trägt Claims: Emittent, Subjekt, Ausstellung, Ablauf, Ziel-Agenten-ID, optionale Wiederaufnahmezustand und einen W3C-Trace-Kontext-Bezeichner, damit der Fachmann zurück zum Original-Trace korrelieren kann.
Die Lebensdauer des Tokens beträgt sechzig Sekunden. Das ist die Konstante im Code: tokenTtlSeconds = 60. Das ist nicht willkürlich. Sechzig Sekunden ist das Fenster, in dem ein Handoff seinen Handshake vervollständigt, der Fachmann sich über das Gateway authentifiziert und der Rückweg etabliert ist. Länger und ein gestohlenes Token bleibt gültig über die Aufmerksamkeit eines einzelnen Agenten-Tours hinaus. Zu kurz und legitimate Handoffs werden vom Netz-Jitter getötet.
Der Inaktivitäts-Timeout beträgt fünf Minuten. idleTimeoutMs = 300_000 in der Gateway-Konfiguration. Wenn eine delegiert Sitzung mehr als fünf Minuten inaktiv ist, schließt das Gateway den Transport, schließt den Upstream-Socket und räumt den Platz auf. Das Scan-Intervall beträgt fünfzehn Sekunden, also weiß das Gateway innerhalb dieses Fensters, dass eine Sitzung im Wald verschwunden ist.
Die Sitzungsbegrenzung beträgt einhundert. maxSessions = 100. Das ist das Limit gleichzeitiger delegierter Sitzungen, das das Gateway verfolgt, bevor es beginnt, Handoffs mit einer maschinenlesbaren Ablehnung abzulehnen. Über hundert legt das Gateway die Token-Emission ein und gibt einen Fehler zurück, den der anrufende Agent lesen und handeln kann.
Der Verbindungs-Timeout beträgt fünf Sekunden. connectTimeoutMs = 5_000. Wenn das Gateway versucht, einen Upstream-Fachmann-Agenten zu erreichen, hat es fünf Sekunden, um die Verbindung herzustellen, bevor es aufgibt und den Handoff rückgängig macht. Das ist absichtlich knapp: ein langsamer Fachmann muss schnell fehlschlagen, nicht den Schwarm blockieren.
Alle diese Grenzen durchdringen die V8-Isolierungsschranke. Das Dispatch-Budget beträgt dreißig Sekunden, definiert in Limits.ts als DISPATCH_TIME_BUDGET_MS = 30_000. Das Boot-Budget beträgt fünf Sekunden, BOOT_TIME_BUDGET_MS = 5_000. Das Heap-Limit beträgt 128 Megabyte, ISOLATE_MEMORY_LIMIT_MB = 128. Wenn ein Tool-Aufruf innerhalb einer delegierten Sitzung einen dieser Werte überschreitet, greift der TimeoutClassifier ein, um zu bestimmen, ob die Verletzung ein Upstream-E / S-Warten oder eine Host-seitige Berechnung war, und die Fehlermeldung trägt einen Erholungstipp für den anrufenden Agenten.
Sitzungs-Isolation: Fünfzig pro Token, zwei Minuten Inaktivität
Das Gateway besitzt den Sitzungs-Lebenszyklus nicht allein. Der SessionManager, der in der Ausführungschicht liegt, erzwingt zwei parallele Sitzungsbegrenzungen.
Die erste Begrenzung beträgt fünfzig Sitzungen pro Token. MAX_SESSIONS_PER_TOKEN = 50 im SessionManager-Code. Das ist die Barriere, die verhindert, dass ein kompromittierter oder kranker Verbindungstoken die gesamte Sitzungstabelle erschöpft. Wenn ein Token fünfzig aktive Sitzungen erreicht, wird der nächste Verbindungsversuch mit einem klaren Fehler abgelehnt, anstatt eine ältere Sitzung stillschweigend zu entfernen.
Die zweite Begrenzung basiert auf der Zeit. Der Inaktivitäts-Timeout beträgt zwei Minuten im Normalbetrieb, SESSION_IDLE_TIMEOUT_MS = 120_000. Unter Speicherdruck sinkt er auf dreißig Sekunden, SESSION_PRESSURE_TIMEOUT_MS = 30_000. Der Bereinigungslauf läuft alle fünfzehn Sekunden, SESSION_SWEEP_INTERVAL_MS = 15_000, sodass eine Sitzung, die in den Wald verschwindet, innerhalb eines Bereinigungszyklus ihres Timeouts wieder aufgenommen wird.
Sitzungs-Metadaten werden über Redis mit einem Time-to-Live von 150 Sekunden repliziert, REDIS_SESSION_TTL = 150. Das ist der Mechanismus, der die horizontale Skalierung ermöglicht: Wenn eine Anfrage bei einer Ausführungseinheit eintrifft, die die Sitzungs-Session nicht im Speicher hält, fragt der Routen-Manager Redis nach dem Sitzungstoken und hydriert den MCP-Server sofort neu. Das Redis-TTL ist absichtlich auf das Inaktivitäts-Timeout plus Puffer eingestellt, sodass veraltete Sitzungen automatisch ablaufen, selbst wenn die Bereinigungseinheit stirbt.
Speicherdruck-Schwellwerte sind als Bruchteile des Behälter-Limits definiert. MEMORY_WARN_THRESHOLD = 0.65 aktiviert Warnungen in den Logs. MEMORY_PRESSURE_THRESHOLD = 0.80 aktiviert eine aggressive Bereinigung. Die Bereinigungslogik vermeidet inaktive Sitzungen, erzwingt die Speicherbereinigung, wenn der Node-Laufzeitumgebung dies zulässt, und protokolliert den Speicherdruck, damit Betreiber die Druckkurve in Echtzeit sehen können.
Der ConnectionTracker, der den Cache auf Transport-Ebene verwaltet, hat seinen eigenen Inaktivitäts-Scan von dreißig Minuten, IDLE_TIMEOUT_MS = 30 * 60_000. Das ist der normale Eviktionsweg der Ebene Eins. Unter Speicherdruck hat er eine zweite Schicht: Wenn der RSS siebzig fünf Prozent des Speicherbudgets der Aufgabe überschreitet, werden alle im Cache befindlichen Konfigurationen mit null aktiven Verbindungen, älteste zuerst, vermieden, bis der Druck unter neunundfünfzig Prozent fällt. Der Code sagt dies ausdrücklich: "Das gibt dem Auto-Scaler Zeit, neue Container bereitzustellen, bevor der OOM eintritt."
Die Verbindung zwischen diesen Schichten ist absichtlich. Ein Sitzungs-Transport ist nicht dasselbe wie eine Cache-Verbindungseintragung, noch dasselbe wie ein ausgehender Agent mit fester IP. Jedes Element hat seinen eigenen Besitzer, sein eigenes Timeout, seinen eigenen Eviktionsauslöser. Aber sie folgen alle demselben Signal: Die Sitzung hat sich zurückgezogen, oder der Behälter braucht mehr Speicher.
Status-Synchronisation: kausale Invalidierung ohne veraltete Lesungen
Die Status-Synchronisationschicht ist dort, wo die Multi-Agenten-Koordination von einer Hoffnung zu einem Protokoll wird. Vinkius implementiert kausale Invalidierung mit drei Marktypen: unveräußerbar, flüchtig und kausal.
Eine unveräußerliche Marke bedeutet, dass der Status eingefroren ist. Einmal geschrieben, kann er nicht geändert werden. Eine flüchtige Marke bedeutet, dass der Status vorübergehend ist und jederzeit unter Speicherdruck eliminiert werden kann. Eine kausale Marke bedeutet, dass der Status invalidiert wird, wenn eine seiner Abhängigkeiten nach oben ändert. Diese Marken werden nicht innerhalb der V8-Isolation gespeichert. Sie werden in der Hostsynchronisationschicht verfolgt, die Invalidierungssignale über den Redis-Streams-Kanal sendet.
Wenn ein Fachmann-Agent eine Ressource ändert, veröffentlicht das Gateway ein Invalidierungereignis auf dem entsprechenden Stream. Jeder Agent, der eine kausale Marke für diese Ressource hält, muss seinen Status vor dem nächsten Tool-Aufruf erneut auflösen. Das verhindert das klassische Multi-Agenten-Problem, bei dem der Finance-Agent einen Preis vom Inventory-Agent liest, der Inventory-Agent den Preis aktualisiert und der Finance-Agent den Kunden mit dem veralteten Wert in Rechnung stellt.
Das Aufnahmezustandsmuster des SwarmGateway stärkt das. Wenn das Gateway ein Token generiert, kodiert es die Absicht des Anrufers als Wiederaufnahmezustand in die Claims des Tokens. Der Fachmann erhält diesen Status und kann darauf handeln, aber das Gateway behält die autoritative Kopie. Wenn die Sitzung zurückkehrt, reconciliert das Gateway den Wiederaufnahmezustand gegen die Gateway-Records, und alle kausalen Marken, die der Fachmann berührt hat, werden im gesamten Schwarm invalidiert.
Die Verbindung zwischen den Sitzungen und dem kryptographischen Audit-Pfad ist es, was dies haltbar macht. Die Hash-Kette wird aufgebaut als raw_base64 || previous_hash || sequence_number und mit Ed25519 signiert. V8 berührt die Kryptografie nie direkt. Der StreamingDaemon ist der Single-Thread-Worker, der von den Redis-Streams liest, die Hash-Kette schmiedet, mit Ed25519 signiert und an die SIEM-Ziele sendet. Der Sitzungsschlüssel rotiert alle 24 Stunden, und Statusänderungen werden in den Redis-Streams markiert, sodass die Kette auch bei einem Absturz des Workers ohne Lücken überlebt.
Verbindungspool: Vier Tausend Domänen, einhundert Sockets
Der SSRF-Schutz erzwingt ein gekoppeltes Cache-Modell: DNS-Auflösungen und ausgehende Pool-Agents sind im Lebenszyklus miteinander verbunden. Der DNS-Cache hält höchstens 4.096 Einträge, DNS_CACHE_MAX_ENTRIES = 4_096. Wenn der Cache voll ist, wird der älteste Eintrag eliminiert. Der Agent-Pool hält höchstens einhundert Verbindungen, AGENT_POOL_MAX = 100. Wenn der Pool voll ist, wird der älteste poolende Agent geschlossen und seine DNS-Eintrag wird in derselben Operation gelöscht.
Diese Kopplung ist die Verteidigung gegen DNS-Rebinding. Der Guard löst den DNS vor der Anfrage auf, validiert, dass die aufgelöste IP nicht in einem privaten Bereich liegt, und fixiert dann diese spezifische IP in der benutzerdefinierten Suchfunktion des undici-Agenten. SNI und TLS-Name bleiben als Hostname erhalten, sodass die Zertifikatsprüfung weiterhin korrekt funktioniert. Ein Rebinding-Angriff, der nach der initialen DNS-Auflösung eine andere IP zurückgibt, kann den Socket nicht umleiten, weil der Socket an die genehmigte Adresse gebunden ist.
Blockierte private IP-Bereiche sind: Loopback (127/8), privates Class A (10/8), privates Class B (172.16 to 172.31/12), privates Class C (192.168/16), Link-Local (169.254/16), Null-Netz (0/8) und ihre IPv6-Zwillinge (::1, FC00/7, FE80/10). Diese werden gegen jede aufgelöste Adresse geprüft, bevor die Verbindung hergestellt wird.
Der Keep-Alive-Timeout für gepoolte Agents beträgt 65 Sekunden, AGENT_KEEP_ALIVE_TIMEOUT_MS = 65_000. Er ist absichtlich höher als das Standard-Inaktivitätsfenster des ALB von 60 Sekunden, damit Sockets im Pool zwischen Agenten-Gesprächen überleben, ohne vom Lastverteiler stumm zu fallen. Der Standard von vier Sekunden in der undici-Bibliothek würde Sockets zwischen jedem Zug schließen und praktisch bei jedem echten Aufruf einen kalten TLS-Handshake erzwingen. Der 65-Sekunden-Timeout hält die Verbindung während einer typischen Agenten-Unterhaltung warm.
Der Scan, der inaktive Agents reinigt, läuft alle 60 Sekunden, koordiniert mit dem 30-Minuten-Inaktivitätsscan des ConnectionTrackers. Wenn ein Pool-Eintrag eliminiert wird, stirbt der DNS-Eintrag mit. Ohne eine lebendige Verbindungspolitik wird die genehmigte Adresse beim nächsten Gebrauch erneut aufgelöst und validiert. Die Code-Kommentare sagen dies ausdrücklich: "Eine DNS-Auflösung wird für genau so lange im Cache gehalten, wie wir einen Agenten im Pool für diesen Hostnamen halten, und beide sterben gemeinsam."
Der Circuit-Breaker, der Kaskaden verhindert
Der Circuit-Breaker ist der finanzielle Schutz, der verhindert, dass ein unkontrollierter Schwarm das Abonnement verbrennt. Er ist ein gleitendes Fenster mit Zähler, implementiert in Redis. Die Standardwerte sind fünf tausend Anfragen pro fünf Minuten, mit einer Kühlzeit von fünfzehn Minuten. Diese Zahlen stammen von der Governance-Konfiguration, nicht vom Laufzeitcode. Der Laufzeitcode in CircuitBreaker.ts spiegelt die PHP-Methode CheckRequestQuota::checkCircuitBreaker wider.
Wenn eine Anfrage eintrifft, prüft der Circuit-Breaker, ob der Kreis bereits geöffnet ist, indem er einen TTL-Schlüssel abfragt. Wenn der Schlüssel eine positive TTL hat, ist der Kreis geöffnet und der Agent erhält eine maschinenlesbare Ablehnungsmeldung: "CRITICAL: Financial budget ceiling exceeded. DO NOT RETRY this request." Der Agent wird angewiesen, den menschlichen Benutzer zur Vinkius Cloud-Konsole zu leiten, um eine Wiederaufnahme zu genehmigen.
Wenn der Kreis geschlossen ist, erhöht der Circuit-Breaker einen deterministischen Schlüsselzähler: die Konto-ID und den abgerundeten aktuellen Zeitstempel dividiert durch die Fenstergröße in Sekunden. Wenn der Zähler das Limit überschreitet, öffnet der Kreis. Der geöffnete Status wird als SETEX mit der Kühlzeit als TTL in Redis gespeichert, sodass er sich automatisch nach der Kühlzeit zurücksetzt.
Der Circuit-Breaker schlägt fehl, indem er öffnet. Wenn Redis nicht verfügbar ist, wird der Fehler abgefangen und protokolliert, und die Anfrage wird genehmigt. Das ist eine bewusste Design-Entscheidung: ein Redis-Ausfall sollte keinen legitimen Agentenverkehr blockieren. Der Preis dafür ist, dass während eines Redis-Ausfalls der Circuit-Breaker deaktiviert ist und die Agenten ihr Abonnement überschreiten können. Die Code-Kommentare sagen dies ausdrücklich: "fail-open prevents blocking legitimate traffic."
Wenn eine Sitzung unter Speicherdruck eliminiert wird, folgen die Pool-Einträge. Die Kaskade ist kontrolliert: Der Circuit-Breaker stoppt neue Anfragen, der Sitzungs-Scan eliminiert inaktive Sitzungen, der ConnectionTracker vermeidet inaktive Caches, und der DNS-Cache weist Einträge zurück, die keine lebendigen Verbindungen mehr haben.
Die 34 plus 4 Regeln, die jede Sitzung enthält
Der IsolateRunner erzwingt 34 plus 4 Ingenieur-Regeln, die jede delegierte Sitzung daran halten, aus ihrer Sandbox zu entkommen. Die 34 Regeln gelten für Boot, Snapshot, Dispatch und Reject. Die vier zusätzlichen Regeln sind Speicher-, CPU-, Netz- und Speichermedien-Duelle.
Beim Boot: Ein life-support Polyfill ersetzt jede Node-Eingebaut-Funktion, die den externen Zustand berühren könnte. Die Callback-Registrierung des Gastgebers wird vor dem IIFE ausgeführt registriert. Binär-sicherer Fetch wird als Host-Bridge-Aufruf injiziert, nicht als Polyfill, den das Bundle ersetzen könnte. Das Skript wird unmittelbar nach dem Boot freigegeben, sodass der Snapshot-Cache keine Referenzen auf Boot-Objekte halten kann.
Beim Snapshot: V8-Heap-Snapshots werden auf Festplatte mit einem vierstufigen Integritätsmodell zwischengespeichert. Bridge-Stubs werden durch Host-Referenzen ersetzt, damit der Snapshot keinen veralteten Transport erfassen kann. Externalisierungs-Hooks ermöglichen dem Isolat, Referenzen abzulehnen, die nicht überleben sollten. Der Snapshot wird durch eine Deployment-ID identifiziert und atomisch über Redis invalidiert, wenn das Deployment neu importiert wird.
Beim Dispatch: Strukturierter Klon mit copy: true stellt sicher, dass Objekte, die vom Isolat zum Host reisen, tief kopiert und nicht geteilt werden. Der Dispatch-Timeout aktiviert den Watchdog, der das Skript tötet, selbst wenn es im Upstream-Fetch des Hosts hängt. Der TimeoutClassifier bestimmt dann, ob der Kill auf eine Upstream-E / S-Warte oder eine Host-seitige Berechnung zurückzuführen ist, und der Fehler trägt einen Erholungstipp.
Beim Reject: Ein AbortController, das über die gesamte Reject-Pipeline verbunden ist, bricht laufende Anfragen ab. Der Guillotine-Timer storniert jeden setTimeout und setInterval, der vom Gast registriert wurde. Referenzen werden in umgekehrzten Reihenfolge freigegeben, und ein disposed-Wächter verhindert Double-Free. Wenn eine Sitzung eliminiert wird, werden ihre laufenden Anfragen in derselben Operation abgebrochen, und der Byte-Zähler auf der Antwort-Stream wird auf zehn Megabyte begrenzt.
Das Antwortlimit von zehn Megabyte ist MAX_FETCH_RESPONSE_BYTES = 10MB in der Runtime-Konfiguration. Der Byte-Zähler ist mit dem AbortController verbunden, sodass eine unkontrollierte Antwort mitten im Stream statt nach dem Vollschreiben des Heaps abgeschnitten werden kann. Die Funktion safeFetch des SSRF-Schutzes erzwingt diesen Zähler bei jeder ausgehenden Anfrage, und der Guard ist der einzige Weg, dass das Isolat das externe Netzwerk verlässt. Es gibt keine direkten Sockets, keine DNS-over-HTTPS-Tunnel und keine WebSocket-Upgrades, die den Guard umgehen könnten.
Die vier Containment-Regeln sind: Heap-Limit auf 128 MB, erzwungen durch das V8-Flag resourceLimits.maxOldGenerationSizeMB. CPU limitiert durch den 30-Sekunden-Dispatch-Watchdog, der kein weicher Schwellwert ist und nicht aus dem Inneren des Isolats verlängert werden kann. Netz erzwungen durch den SSRF-Schutz, was bedeutet, dass der DNS-Cache und der Agent-Pool des Guards die einzigen ausgehenden Netzwerke sind. Speichermedium ist am schwierigsten: Das Isolat hat keinen Dateisystemzugriff. Das Bundle läuft vollständig im Speicher, und jede Dateioperation läuft über die Host-Bridge.
Datenschutz vor dem Agenten
Multi-Agenten-Sitzungen vervielfachen die Datendiebsmaterialfläche. Ein Agent liest einen Kundenrecord, ein anderer Agent tritt in die Konversation ein, und plötzlich sehen beide Agenten dasselbe sensible Feld, das nur der erste lesen durfte. Die DLP-Schicht verhindert das, indem sie vor dem Erreichen eines Agenten aktiv ist.
Der ResponseGuard wendet Maskierungsmuster auf jede Antwort an, bevor sie das Gateway verlässt. Die Standardmuster umfassen Wildcard-Übereinstimmungen für E-Mail, Passwort, Secret, Kreditkarte, SSN, Telefon, API-Schlüssel, Token, Geburtsdatum, Bankkonto und IBAN. Die Wildcard-Syntax bedeutet, dass *.email jedes E-Mail-Feld in beliebiger Tiefe im Antwortobjekt schützt, und items[*].credit_card speziell Array-Elemente schützt.
Maskierung findet im RAM statt, nie auf Festplatte, und nie innerhalb der V8-Isolation. Der Guard läuft im Host-Prozess, bevor die Antwort an den MCP-Server übergeben wird. Das bedeutet, dass sensible Daten maskiert sind, bevor sie in eine Tool-Beschreibung oder Argument eintragen, die ein Agent lesen könnte. Der Guard ist zustandlos und deterministisch, sodass dieselbe Antwort immer dieselbe Maskierung erzeugt und Wiederholungsangriffe auf dem Audit-Pfad unmöglich macht.
Jede Maskierung wird gezählt und zugewiesen. Die Sicherheitsvorschrift-Verfolgung folgt der Gesamtzahl der Maskierungen pro Stunde, pro Konnektor, pro Agent-Sitzung. Wenn ein Agent eine Maskierung auslöst, weiß die Fehlerzuteilung des Circuit-Breakers, dass es sich um DLP handelt, nicht um Upstream, nicht um den Agenten. Das Log liest Vinkius Err: DLP redaction applied und der Erholungstipp weist den Agenten an, gefilterte Felder explizit anzufordern.
Tracing des Schwarmes: W3C durch den Handoff
Wenn ein Agent einen Handoff zu einem Fachmann auslöst, reist der W3C-Trace-Kontext mit. Der traceparent-Header der ursprünglichen Anfrage wird in die Claims des Delegations-Tokens kodiert, und wenn der Fachmann die Anfrage verarbeitet, liest er den Trace-Kontext aus dem Token und setzt den Trace fort.
Der TraceContext-Hilfscode im Runtime hebt den Trace-Kontext des Anrufers auf den pro-Anfrage-Kontext jeder Serverfabrik. Der Kontext ist auf allen Server-Typen vorhanden: API-Proxy, YAML und Bundle, sodass sowohl Tool-Spans als auch Anfrage-Logs einen Rückkehrtrace zum ursprünglichen Trace ohne Code pro Tool korrelieren können. Wenn der Wert undefiniert ist, ist der Trace wurzellos, nicht implizit an einen Standard gebunden.
Der Audit-Pfad bewahrt den Trace-Kontext von Ende zu Ende. Der ChainForge baut den Hash jedes Audit-Records aus dem rohen Base64-Payload, dem vorherigen Hash und derSequenznummer. Der Trace-Kontext wird als suchbare Metadaten im Log-Eintrag kodiert, sodass ein Sicherheitsanalyst den eindeutigen Weg eines Agenten durch das Gateway, den Fachmann und zurück zum Gateway in einem einzigen Trace verfolgen kann.
Das ist, was das Live-Activity-Dashboard zum Leben erweckt. Jede Zeile zeigt den MCP-Server, das Tool, die semantische Aktion (query, mutation, destructive), das Token, das Ergebnis und eine vollständige Latenz-Aufteilung. Grün bedeutet, dass der Upstream geantwortet hat. Lila bedeutet, dass die Vinkius-Politik war hat gehandelt. Ambra bedeutet, dass der Anrufer sich irren hat. Rot bedeutet, dass der Anbieter fehlgeschlagen ist. Jede Farbe entspricht einem anderen Fehler-Eigentümer, und jeder Fehler trägt einen Trace, den der Analyst öffnen kann, um den vollständigen Weg zu sehen.
Der Rückweg: Wie das Gateway sich wieder integriert
Wenn ein Fachmann-Agent seine Arbeit beendet, wird die Methode returnToGateway des SwarmGateway aktiviert. Das ist keine Umleitung. Das ist eine Status-Reconciliation. Das Gateway vergleicht den in den Delegations-Claims kodierten Wiederaufnahmezustand mit dem, was der Fachmann zurückgegeben hat, und alle kausalen Marken, die der Fachmann berührt hat, werden im gesamten Schwarm invalidiert.
Der Rückweg wird durch ein Tool vermittelt, das das Gateway in die Sitzung des Fachmanns injiziert. Dieses Tool ist nicht als primäre Fähigkeit für den Agenten sichtbar. Es ist ein Rückkanal: Der Agent ruft es mit seinem Endstatus auf, und das Gateway nimmt von dort aus auf. Das Tool ist als _MCPFUSION_handoff_return gekennzeichnet, damit die Sitzungsschicht es erkennt und den Rückweg aktiviert.
Das Gateway schreibt auch den Namensraum der Tools des Fachmanns neu. Wenn der Finance-Fachmann seine Tools offenlegt, prefixt das Gateway sie mit finance., sodass der Anrufer finance.create_invoice und finance.get_balance sieht, nicht create_invoice und get_balance. Das verhindert Namenskollisionen, wenn mehrere Fachleute gleichzeitig in einer Konversation aktiv sind, und macht den Audit-Pfad eindeutig: Jeder Tool-Aufruf registriert, aus welchem Fachmann-Namensraum er kommt.
Die Zahlen, die zählen
Jede Grenze in diesem System ist benannt. Es gibt keine magischen Zahlen in den Konfigurationsdateien. Die Herleitung ist neben jeder Konstante dokumentiert.
| Name | Value | Source |
|---|---|---|
| Session idle timeout | 2 minutes | SessionManager.ts, SESSION_IDLE_TIMEOUT_MS |
| Memory pressure timeout | 30 seconds | SessionManager.ts, SESSION_PRESSURE_TIMEOUT_MS |
| Sessions per token cap | 50 | SessionManager.ts, MAX_SESSIONS_PER_TOKEN |
| Session sweep interval | 15 seconds | SessionManager.ts, SESSION_SWEEP_INTERVAL_MS |
| Redis session TTL | 150 seconds | SessionManager.ts, REDIS_SESSION_TTL |
| Memory warning threshold | 65 percent | SessionManager.ts, MEMORY_WARN_THRESHOLD |
| Memory pressure threshold | 80 percent | SessionManager.ts, MEMORY_PRESSURE_THRESHOLD |
| Connection idle eviction | 30 minutes | ConnectionTracker.ts, IDLE_TIMEOUT_MS |
| DNS cache max entries | 4,096 | SsrfGuard.ts, DNS_CACHE_MAX_ENTRIES |
| Agent pool max | 100 | Limits.ts, AGENT_POOL_MAX |
| Agent keep-alive | 65 seconds | Limits.ts, AGENT_KEEP_ALIVE_TIMEOUT_MS |
| Dispatch time budget | 30 seconds | Limits.ts, DISPATCH_TIME_BUDGET_MS |
| Boot time budget | 5 seconds | Limits.ts, BOOT_TIME_BUDGET_MS |
| Heap cap per isolate | 128 MB | Limits.ts, ISOLATE_MEMORY_LIMIT_MB |
| Session key rotation | 24 hours | StreamingDaemon.ts, SESSION_KEY_TTL_MS |
| Circuit breaker window | 5,000 requests / 5 minutes | Governance config |
| Circuit breaker cooldown | 15 minutes | Governance config |
Das Schwarm-Problem wird nicht gelöst, indem die Agenten intelligenter gemacht werden. Es wird gelöst, indem die Sitzungsschicht autoritativ gemacht wird. Das Gateway besitzt das Delegations-Token, den Sitzungs-Lebenszyklus, die Status-Synchronisation und das Bandbreitenbudget. Der Agent ist der Gast. Das Gateway ist der Gastgeber. Wenn ein Agent seinen Zeitraum überschreitet, vermeidet das Gateway seine Sitzung. Wenn der Pool voll ist, lehnt das Gateway den Handoff ab. Wenn das Budget überschritten wird, öffnet der Circuit-Breaker und der Schwarm stoppt.
Der Post über KI-Agenten als neue Verbraucher hat die MVA-Architektur abgedeckt: Model, Presenter und Tools. Der Post über V8-Isolates hat den Sandbox und das Snapshot-Integritätsmodell abgedeckt. Der Post über AI-Governance hat die zwölf Oberflächen und den Circuit-Breaker abgedeckt. Dieser Post deckte die Schicht ab, von der alle abhängen, aber die niemand erwähnt: die Sitzungsschicht, die verhindert, dass einhundert Agenten sich gegenseitig den Weg überqueren. Der nächste Post in dieser Serie wird das Capability-Lockfile abdecken, und wie die Datei mcpfusion.lock disruptive Änderungen mit git-diffbare diffs und CI-Gates erzwingt.
Die Zahlen oben sind nicht meine Schätzungen. Sie sind das, was der Code vorschreibt. Sie können Limits.ts, SessionManager.ts, SsrfGuard.ts und CircuitBreaker.ts im Cloud-Runtime lesen. Jeder Wert ist benannt, dokumentiert und leitet sich von einer externen Einschränkung ab. Das ist der Unterschied zwischen einer Plattform, die sich entwickelt, und einer Demonstration, die zusammenbricht.
Die Sitzungsverwaltung, Kontrollen und der Circuit-Breaker, die gleichzeitige Agenten steuern, werden mit Quellcode in Unternehmens-KI-Fragen beantwortet.